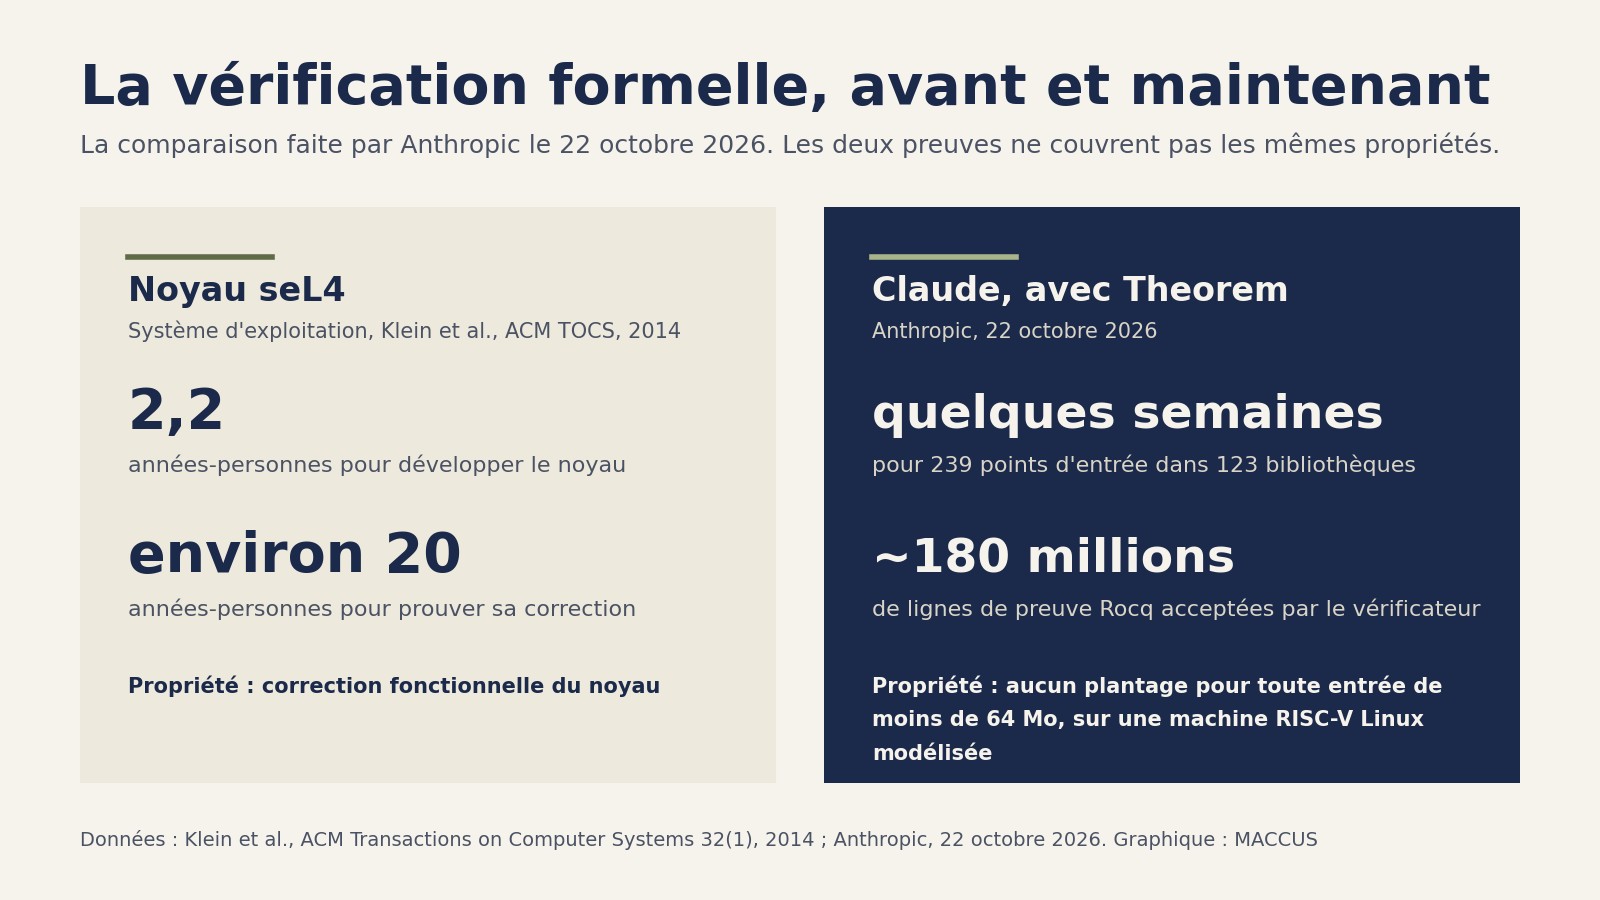

Le 22 octobre 2026, la Frontier Red Team d’Anthropic, avec la start-up Theorem, a annoncé que Claude avait rédigé des preuves vérifiées par machine pour 239 points d’entrée de tests de fuzzing, répartis dans 123 bibliothèques open source. Chaque preuve établit que le point d’entrée ne plante sur aucune entrée de moins de 64 Mo. Selon Anthropic, l’opération a duré « quelques semaines » et produit environ 180 millions de lignes de preuve en Rocq, un assistant de preuve dont le noyau contrôle chaque étape. Au passage, Claude a trouvé des bugs qui avaient « échappé à la détection pendant des années, malgré des milliers de milliards d’exécutions de tests », écrit Anthropic (notre traduction).
Anthropic prend pour étalon seL4, un noyau de système d’exploitation dont la correction a été démontrée formellement. Ses auteurs chiffrent son développement à 2,2 années-personnes et sa preuve à une vingtaine.
L’annonce tombe au lendemain de la divulgation de PHP2Shell, des failles du moteur PHP que Wiz a découvertes avec des modèles d’IA de pointe ; la NSA a demandé aux organisations concernées de mettre à jour leurs serveurs ou de les couper. Selon Wiz, le code fautif se trouvait dans le moteur PHP depuis plus de dix ans.
Une garantie longtemps réservée aux systèmes critiques
La vérification formelle consiste à décrire mathématiquement ce qu’un programme doit toujours faire, puis à démontrer que le code s’y conforme pour toutes les entrées possibles. Un test de fuzzing essaie les entrées qu’il génère au hasard, une preuve les couvre toutes. Trop coûteuse, la méthode n’était praticable, écrit Anthropic, que « dans des applications réellement critiques, comme le code avionique d’Airbus ».
Du test de fuzzing au théorème
L’équipe s’est dispensée d’écrire les spécifications à la main. Elle est partie d’OSS-Fuzz, le projet de Google qui fait tourner des tests de fuzzing sur des logiciels open source : de petits points d’entrée qui envoient au code des entrées générées et plantent au moindre problème, par exemple quand l’outil AddressSanitizer détecte un accès mémoire illicite.
Chaque bibliothèque et son test ont été compilés en binaire RISC-V, et le test est devenu un énoncé : pour toute entrée de moins de 64 Mo, le programme se termine normalement, sans erreur de sécurité mémoire ni assertion en échec. Des modèles formels de RISC-V et d’un processus Linux, écrits par Theorem, définissent ce que signifie exécuter le binaire. Claude écrit la preuve, le noyau de Rocq la vérifie.
Selon Anthropic, la confiance repose alors sur les modèles de RISC-V et de Linux, les énoncés exacts des théorèmes et le vérificateur de Rocq. Rocq est de la même famille que Lean, l’outil dans lequel une formalisation de la conjecture KLS, tout juste démontrée, est apparue sur GitHub ce mois-ci.
180 millions de lignes contrôlées par la machine
Une preuve typique compte environ 600 000 lignes, pour des binaires de 18 000 instructions RISC-V en médiane. D’après l’annexe, Claude a écrit au total environ un milliard de lignes de Rocq, dont environ 180 millions figurent dans des preuves acceptées par le vérificateur.
Le dépôt oss-verify-proofs, ouvert le 22 octobre sous licence MIT, publie les preuves de 60 points d’entrée dans 25 bibliothèques, dont OpenSSL, mbedtls, bzip2 et libpcap, vérifiées avec Rocq 9.2.0. Anthropic dit ne pas publier les preuves susceptibles de révéler un bug non corrigé.
Des bugs que le fuzzing n’avait pas vus
Certaines cibles ne sont devenues démontrables qu’après correction du bug par Claude et régénération de la spécification à partir du code corrigé. Selon Anthropic, l’opération a mis au jour « des centaines de bugs ». Pour éviter que le modèle ne transforme un programme en une version qui, trivialement, ne plante jamais, l’équipe a pénalisé chaque correctif et les a tous audités.
Les fuzzers font en général muter de petites entrées, d’environ 1 Mo au plus. Claude a trouvé dans un décompresseur un dépassement par le bas d’un compteur, à l’origine d’une écriture hors limites qui ne survient qu’avec des entrées d’environ 20 Mo à la structure rare.
Lors d’autres essais, l’équipe a découvert dans une application critique un bug logique latent depuis plus de dix ans et, en tentant de vérifier un lecteur PDF très répandu, « autant de bugs de sécurité en une semaine qu’il en est habituellement signalé en un an ». Le billet ne nomme aucun des deux logiciels.
Un coût qui baisse avec les nouveaux modèles
Anthropic range le coût parmi les principales limites : une preuve « peut demander des centaines de millions de tokens ». Sur 36 petites tâches tirées du code d’OSS-Fuzz, son graphique montre qu’Opus 5.5 en démontre la moitié avec environ 40 % de tokens en moins qu’Opus 5.
Theorem suit la tendance sur son propre banc d’essai de 36 petits programmes C. Sur sept modèles d’Anthropic et d’OpenAI sortis entre mai et septembre 2026, la vitesse de vérification est passée de 0,12 Ko de code machine par heure pour Opus 4.8 à une fourchette de 0,56 à 0,91 Ko pour les trois modèles de septembre, GPT-6 Astra en tête. Selon l’ajustement de Theorem, cette vitesse double tous les 1,9 mois ; Epoch AI estime à huit mois le temps de doublement des progrès algorithmiques des modèles de langage.
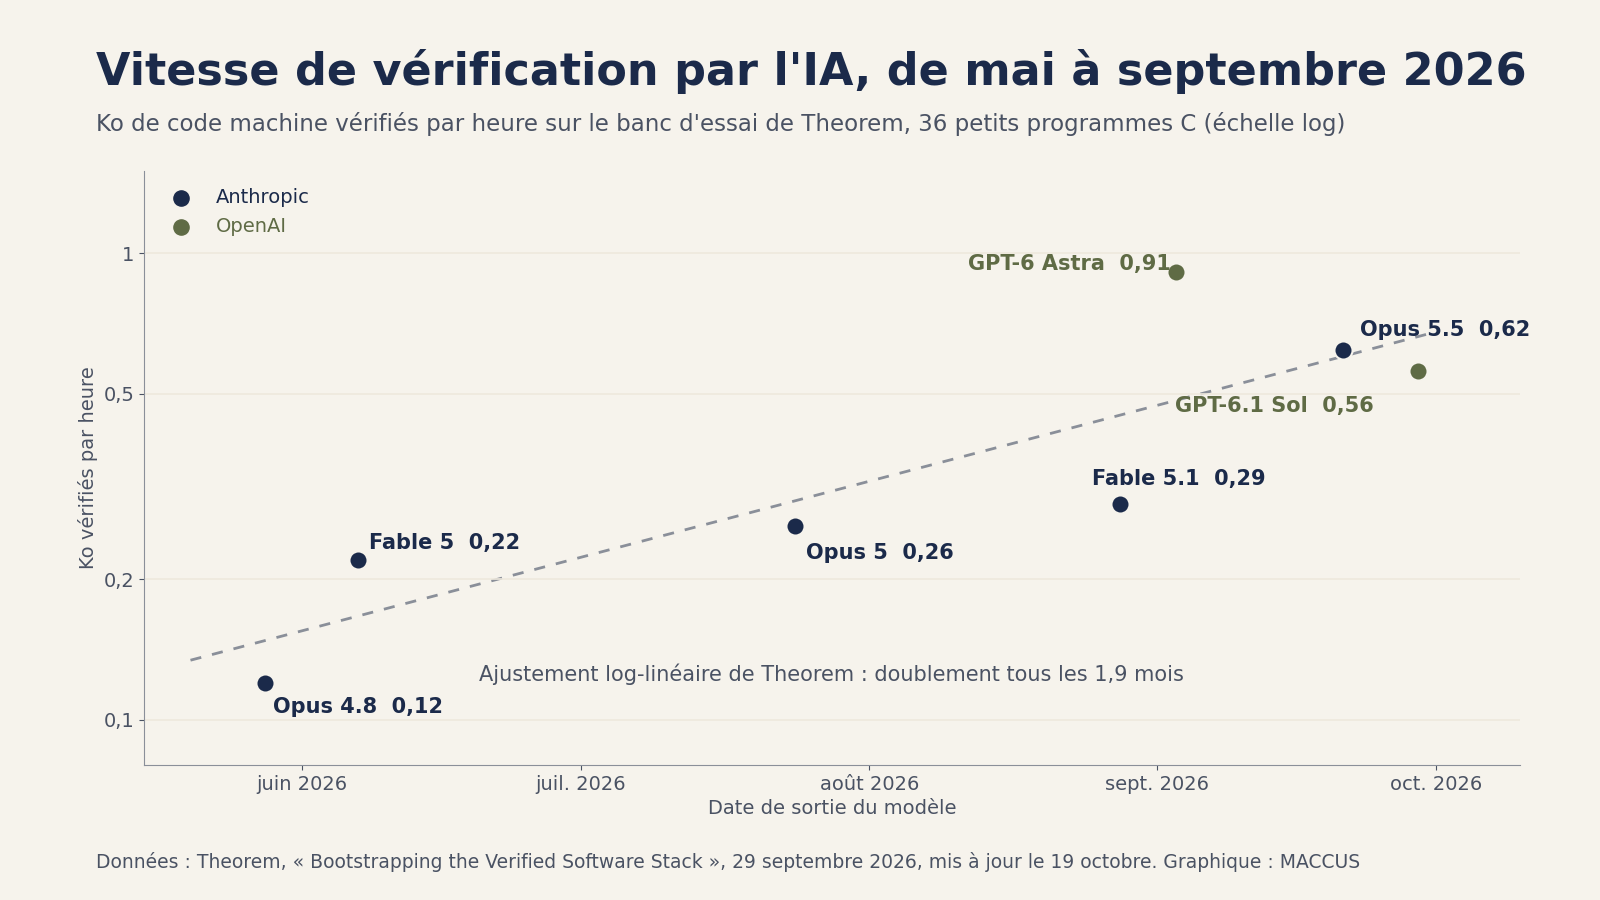
Si l’on parvient à faire progresser les modèles en vérification bien plus vite que dans l’ensemble, 95 % du code machine de nixpkgs, la collection de paquets de Nix, pourrait être vérifié d’ici fin 2027 pour environ 134 millions de dollars, selon les estimations de Theorem. L’entreprise vend ce service et le propose gratuitement aux projets open source éligibles via OSS Verify ; quatre des six auteurs de son billet figurent aussi parmi les signataires du travail d’Anthropic.
La même semaine, côté attaque
Le 21 octobre, Wiz Research a révélé PHP2Shell, des failles de sécurité mémoire du moteur PHP vieilles de « plus d’une décennie », qui touchent presque toutes les versions publiées depuis PHP 5.4, notées jusqu’à 9,2 sur l’échelle CVSS. Le même jour, Amazon a indiqué que les failles étaient « désormais largement exploitées », a rapporté le Financial Times. Google a demandé aux sites coupés pour appliquer le correctif de renvoyer un code 503, et OpenAI a estimé qu’à sa connaissance, l’IA de pointe avait trouvé ces failles avant les attaquants. Le travail d’Anthropic est un projet distinct, et PHP ne figure ni dans le billet ni parmi les 25 bibliothèques dont les preuves sont publiques.
Les limites décrites par les auteurs
« “Vérifié formellement” ne veut pas dire “sans bug” », rappelle Anthropic en tête de sa liste des limites. Une preuve vaut pour le modèle de la machine, et ces modèles décrivent des binaires RISC-V statiques, à un seul fil d’exécution, liés à musl, alors que ces bibliothèques tournent surtout sur x86 ou ARM avec glibc. AddressSanitizer ne détecte pas toutes les erreurs de sécurité mémoire, et tous les points d’entrée de chaque bibliothèque n’ont pas été vérifiés. Le README du dépôt précise que le modèle Linux de Theorem est « fait au mieux et incomplet », et qu’aucune preuve publiée n’exclut une exécution qui ne se termine jamais.
Une section de l’annexe examine les preuves du point de vue d’un expert humain en vérification formelle. Elle juge les preuves des agents « verbeuses » : des ingénieurs de la preuve « auraient immédiatement introduit des abstractions » pour éliminer les répétitions. L’expérience de MachCSL, un autre projet de vérification mené par des agents, laisse penser que ce style pourrait ne pas passer à l’échelle de programmes plus complexes : les agents y ont « buté sur un mur de complexité ».
Au-delà des 60 preuves publiques, le décompte repose sur la parole d’Anthropic, dont le billet ne donne ni coût total, ni volume de calcul, ni le modèle Claude employé.
Notre analyse
Jusqu’ici, une garantie vérifiée par machine exigeait une équipe de spécialistes et des années de travail par système, d’où son usage limité aux noyaux et à l’avionique. Anthropic et Theorem décrivent une chaîne qui transforme en théorèmes des tests déjà écrits par les mainteneurs open source et confie les preuves à un modèle, bibliothèque après bibliothèque. Les décomptes de tokens d’Anthropic et les mesures de vitesse de Theorem, tous deux réalisés sur de petits programmes, montrent un coût en baisse.
La garantie est plus étroite que celle de seL4, et les deux chiffres, 20 années-personnes et quelques semaines, viennent du billet d’Anthropic. Les preuves de Claude portent sur les plantages et les erreurs mémoire visibles par AddressSanitizer, sur des points d’entrée précis, dans une machine RISC-V Linux modélisée. La preuve de seL4 couvre la correction fonctionnelle du noyau entier.
Le volume de code à contrôler augmente aussi : Anthropic dit avoir fusionné plus de 30 000 modifications de code par jour en septembre. Ces preuves excluent les erreurs mémoire qu’AddressSanitizer sait détecter, sur les points d’entrée qu’elles couvrent. Wiz range toutes les failles PHP2Shell parmi les problèmes de sécurité mémoire.
Les questions ouvertes portent sur le coût par preuve, la tenue du style verbeux face à des programmes plus gros et la poursuite du doublement tous les 1,9 mois calculé par Theorem au-delà de sept modèles et de quatre mois de sorties. Les prochains jalons seront les revérifications indépendantes des 60 preuves publiques, des modèles de x86 et de glibc fidèles aux machines en service, et le nombre de projets d’OSS-Fuzz qui rejoindront OSS Verify.
Sources
- LLMs are making formal software verification feasible at a much larger scale, Anthropic, 22 octobre 2026
- Appendix: LLMs are making formal software verification feasible at a much larger scale, Anthropic, 22 octobre 2026
- theorem-labs/oss-verify-proofs, Theorem sur GitHub, 22 octobre 2026
- Bootstrapping the Verified Software Stack, Theorem, 29 septembre 2026, mis à jour le 19 octobre
- Comprehensive Formal Verification of an OS Microkernel, G. Klein et al., ACM Transactions on Computer Systems, février 2014
- PHP2Shell: AI uncovers critical RCE vulnerabilities affecting 70% of the Internet, Wiz Research, 21 octobre 2026
- Hackers got a four-day head start on epic PHP2Shell vulnerability, Financial Times, repris par Ars Technica, 22 octobre 2026
Image d’en-tête : graphique MACCUS, données Klein et al., ACM Transactions on Computer Systems (2014) et Anthropic (22 octobre 2026)