Sur des protéines que presque personne n’a étudiées, Claude Fable 5.2, d’Anthropic, devine la suite de la séquence, là où les modèles GPT d’OpenAI et Gemini de Google échouent. Il bat aussi tous les modèles spécialisés en protéines du comparatif. Les deux chercheurs qui ont mené le test en concluent que Claude a été entraîné sur des séquences de protéines à grande échelle. La page de lancement de Fable 5.2 ne parle pas de séquences de protéines, et le billet ne cite aucune déclaration d’Anthropic.
Le test porte sur 668 protéines de bactéries et d’archées, deux groupes de micro-organismes. Une protéine s’écrit comme une suite de lettres, une par acide aminé, les briques qui la composent. Chacun des 22 modèles de langage testés recevait le début d’une protéine et devait donner la lettre suivante. Fable 5.2 a trouvé la bonne dans 54 % des cas, contre 9 % sur des copies mélangées des mêmes protéines.
Xinming Tu et Leo Tianlai Chen ont publié le test le 16 novembre 2026 sur le blog du premier, sous le titre « Claude was trained on protein sequences at scale ». Doctorant en dernière année à l’Allen School de l’université de Washington, Xinming Tu est aussi membre fondateur de l’équipe technique de Phylo. Ce laboratoire développe des agents d’IA pour la recherche biomédicale.
Un test sur des protéines dont presque personne ne parle
Les modèles spécialisés, dits modèles de langage de protéines, apprennent sur les bases de séquences, comme un chatbot sur du texte. L’alphabet des protéines compte 20 acides aminés courants.
Les auteurs voulaient savoir d’où vient ce qu’un chatbot sait des protéines : des bases de séquences ou des textes à leur sujet. Les protéines célèbres ne permettent pas de trancher. La GFP, la protéine fluorescente verte, figure dans d’innombrables articles, et la plupart des grands modèles savent réciter sa séquence.
Ils ont donc choisi 668 protéines de 167 familles de Pfam, une base de familles de protéines, toutes classées « de fonction inconnue ». Aucune de ces familles n’a de structure 3D résolue, c’est-à-dire de forme connue dans l’espace, ni plus de trois publications. Aucune protéine n’a non plus de proche parente dans UniProt, la grande base publique de protéines.
Chaque protéine est coupée en cinq points tirés au hasard. À chaque coupure, le modèle écrit les dix acides aminés suivants, et seul le premier est noté. Pour comparer, chaque modèle reçoit aussi la même protéine aux lettres mélangées : mêmes lettres, ordre détruit. L’écart entre les deux scores mesure donc ce que le modèle sait des vraies séquences, au-delà des lettres les plus fréquentes.
Fable 5.2 devant les autres chatbots et les modèles spécialisés testés
Fable 5.2 obtient 54,1 % sur les vraies protéines et 9,0 % sur les mélangées, soit 45,1 points d’écart. Claude Opus 5.5, un autre modèle d’Anthropic, obtient 34,9 % et 7,5 %, soit 27,4 points. Les cinq modèles GPT testés, jusqu’à GPT-6.2, restent sous 3 points : le meilleur, GPT-6 Astra, atteint 2,9. Les modèles Gemini ne dépassent pas 1,1 point.
Les sept modèles à poids ouverts (aux paramètres publics), dont DeepSeek V4.1 Flash, Qwen 3.8 et Kimi K3.1 Pro, restent sous 2 points. Leur présenter les protéines au format brut des bases de séquences n’y change rien.
L’étalon, ce sont les modèles de langage de protéines. La société de biotechnologie Profluent indique que ses modèles ProGen3 ont été entraînés sur « plus de 3,4 milliards de séquences de protéines ». ProGen3-3B, la plus grande version publique, obtient 43,7 % contre 11,1 %, soit 32,5 points. ProtGPT3-10B, le plus grand modèle de protéines ouvert testé, atteint 27,7 points.
Fable 5.2 les devance tous les deux de plus de 12 points, et Opus 5.5 fait jeu égal avec ProtGPT3-10B. « Fable 5.2 bat tous les modèles de langage de protéines ouverts que nous avons fait tourner », écrivent les auteurs.
De 2 à 45 points d’écart en un an
L’écart grandit au fil des versions de Claude, avec deux petits reculs. Claude Opus 4.5, sorti le 24 novembre 2025, affiche 1,9 point et Opus 4.6, 0,9 : des valeurs proches du bruit de mesure. Opus 4.7 monte à 8,9, Opus 4.8 à 7,7 et Opus 5 à 9,6. Fable 5.1 atteint 14,9, Opus 5.5 27,4 et Fable 5.2, lancé le 9 novembre 2026, 45,1.
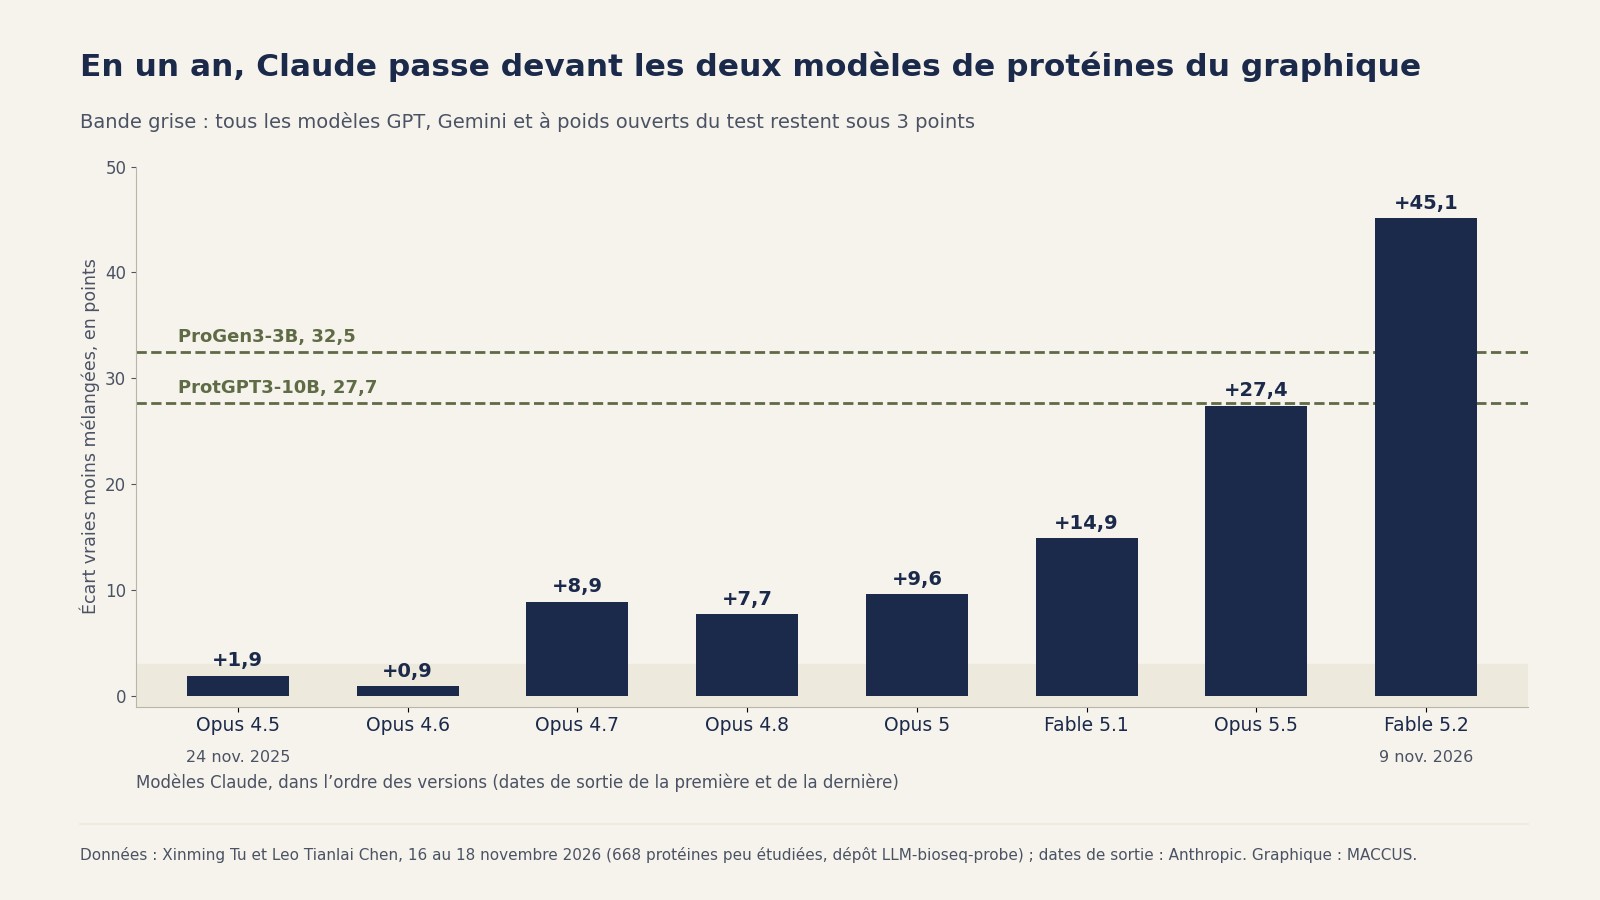
Selon les auteurs, le phénomène « apparaît avec Opus 4.7, fait un bond avec Opus 5.5, puis un autre avec Fable 5.2 ». Fable 5.2 retrouve même les dix acides aminés demandés à 88 coupures de vraies protéines, jamais sur une protéine mélangée. Si chaque lettre était devinée indépendamment des autres, on n’en attendrait qu’environ 16.
Les indices d’un entraînement sur des séquences
Premier indice : la taille des familles. Plus une famille Pfam compte de membres connus, mieux les derniers Claude s’en sortent. Les modèles de protéines, nourris uniquement de séquences, font de même.
Les publications n’expliquent pas le résultat. Sur les 128 familles sans aucune publication, l’écart atteint 45,9 points pour Fable 5.2 et 26,8 pour Opus 5.5. C’est à peu près leur écart sur l’ensemble des 167 familles.
Le raisonnement non plus. Avant de répondre, un modèle peut rédiger un brouillon caché, fait de « jetons de réflexion ». Les API des modèles, leur accès pour les développeurs, ne signalent ce brouillon que pour 9 % des réponses de Fable 5.2 et 36 % de celles d’Opus 5.5. Les réponses sans réflexion sont tout aussi justes.
Ce savoir est aussi ciblé. Sur l’ADN humain et de souris, Opus 5.5 prédit les séquences codantes, les portions de gènes qui servent à fabriquer les protéines. Il échoue sur le reste du génome. « Il a appris les protéines, pas les génomes », résument les auteurs.
La mise à jour du 18 novembre teste l’hypothèse d’un simple apprentissage par cœur. Leo Tianlai Chen a réuni 56 protéines rendues publiques en août 2026, après la date limite d’entraînement supposée par les auteurs, le 1er juillet. Aucune n’a de parente plus ancienne qui partage 50 % ou plus de sa séquence.
Sur les 31 familles concernées, l’écart de Fable 5.2 passe de 40,2 points dans le jeu principal à 22,1. Celui d’Opus 5.5 passe de 27,1 à 13,4, ProGen3-3B obtient 12,0 points et GPT-6.2 Sol reste à zéro. Selon les auteurs, chaque modèle garde ainsi environ la moitié de son écart du jeu principal, comme attendu pour des protéines aussi isolées. Ce que Claude a appris s’étendrait donc aux nouveaux membres d’une famille.
Les limites du test
Le travail est un billet de blog, qui n’a pas été relu par d’autres chercheurs avant publication. Sa conclusion sur les données d’entraînement reste une déduction des auteurs. Le code, les jeux de test et toutes les réponses des modèles sont en revanche publics dans un dépôt GitHub, sous licence libre MIT.
Le jeu de protéines récentes est petit. Avec 56 protéines, seul un écart d’environ 14 points ou plus est détecté de façon fiable, écrivent les auteurs. La date limite du 1er juillet reste aussi une hypothèse. Dans ce jeu, l’avance de Fable 5.2 sur ProGen3-3B, 22,1 points contre 12,0, est incertaine, car leurs marges d’erreur se chevauchent.
La comparaison s’arrête aux modèles ouverts que les auteurs pouvaient faire tourner. Profluent décrit un ProGen3 plus gros, de 46 milliards de paramètres, qui n’a pas été testé. Les outils comme AlphaFold, qui prédisent la forme 3D des protéines, font un autre travail. Pour GPT et Gemini, le test ne trouve aucun signe de ce savoir, ce qui ne prouve pas qu’ils n’ont jamais vu de séquence de protéine.
Sur le forum Hacker News, le billet a recueilli plus de 170 points de vote, et l’annonce de Xinming Tu sur X dépasse 1 000 mentions « j’aime ». Un commentateur du forum doutait de l’utilité de la tâche : dans quel cas faudrait-il deviner une protéine inconnue à partir d’un fragment ?
Les auteurs terminent sur une question : Claude pourrait-il, de la même façon, prédire le repliement d’une protéine, sa forme dans l’espace, ou classer ses variantes ? Le 18 novembre, Sergey Ovchinnikov, professeur adjoint de biologie au MIT, a écrit qu’avec une consigne courte, Fable 5.2 avait correctement prédit le repliement de l’ubiquitine. L’ubiquitine compte pourtant parmi les protéines les plus étudiées, et le billet montre lui-même que les modèles récitent les protéines célèbres. Un repliement juste sur une protéine reste donc un premier essai.
Notre analyse
Un chatbot généraliste détient désormais ce qui ressemble au savoir d’un modèle spécialisé dans les protéines. Fable 5.2 fait mieux que ProGen3-3B, un modèle entraîné uniquement sur des séquences. Il reste devant sur des protéines publiées après sa date limite d’entraînement supposée, dans des marges d’erreur qui se chevauchent.
Ce changement s’est fait en un an de versions de Claude, pendant que les autres chatbots restaient proches de zéro. Ce profil évoque un choix de données propre à un laboratoire, plutôt qu’une capacité qui apparaîtrait d’elle-même dans tout grand modèle. Seul Anthropic pourrait le confirmer.
Le résultat rejoint ce qu’Anthropic montre ailleurs. Selon la page de lancement de Fable 5.2, Claude Mythos 5.2, qui repose sur le même modèle, a correctement modélisé 28 des 34 capsides de virus qu’il a tentées. La capside est la coque de protéines d’un virus. Mythos 5.2 s’appuyait sur deux modèles ouverts de repliement des protéines.
En biologie, Claude a déjà servi à repérer une famille d’enzymes ensuite vérifiée en laboratoire et à coordonner les 11 laboratoires d’une biotech d’un seul salarié. Il a aussi servi à établir la structure 3D d’une coque de protéine appelée « vault ».
Les derniers ajouts au dépôt testent si les modèles savent prédire une carte de contacts, la liste des acides aminés qui se touchent une fois la protéine repliée. Le billet ne donne pas encore de résultat. Des réplications par d’autres équipes, une version évaluée par des pairs et une déclaration d’Anthropic sur ses données d’entraînement diraient jusqu’où va la découverte.
Sources
- Claude was trained on protein sequences at scale, Xinming Tu et Leo Tianlai Chen, 16 novembre 2026 (mis à jour le 18 novembre)
- LLM-bioseq-probe, GitHub (Xinming Tu), 18 novembre 2026
- Introducing ProGen3, Profluent, 16 avril 2025
- Introducing Claude Fable 5.2 and Claude Mythos 5.2, Anthropic, 9 novembre 2026
- Introducing Claude Opus 4.5, Anthropic, 24 novembre 2025
- Claude was trained on protein sequences, at scale, Xinming Tu sur X, 17 novembre 2026
- Given Claude Fable 5.2 can predict protein sequence, I was curious if it can predict structure, Sergey Ovchinnikov sur X, 18 novembre 2026
- Claude was trained on protein sequences at scale (discussion), Hacker News, 18 novembre 2026
Image d’en-tête : graphique MACCUS, d’après Xinming Tu et Leo Tianlai Chen (16 au 18 novembre 2026)