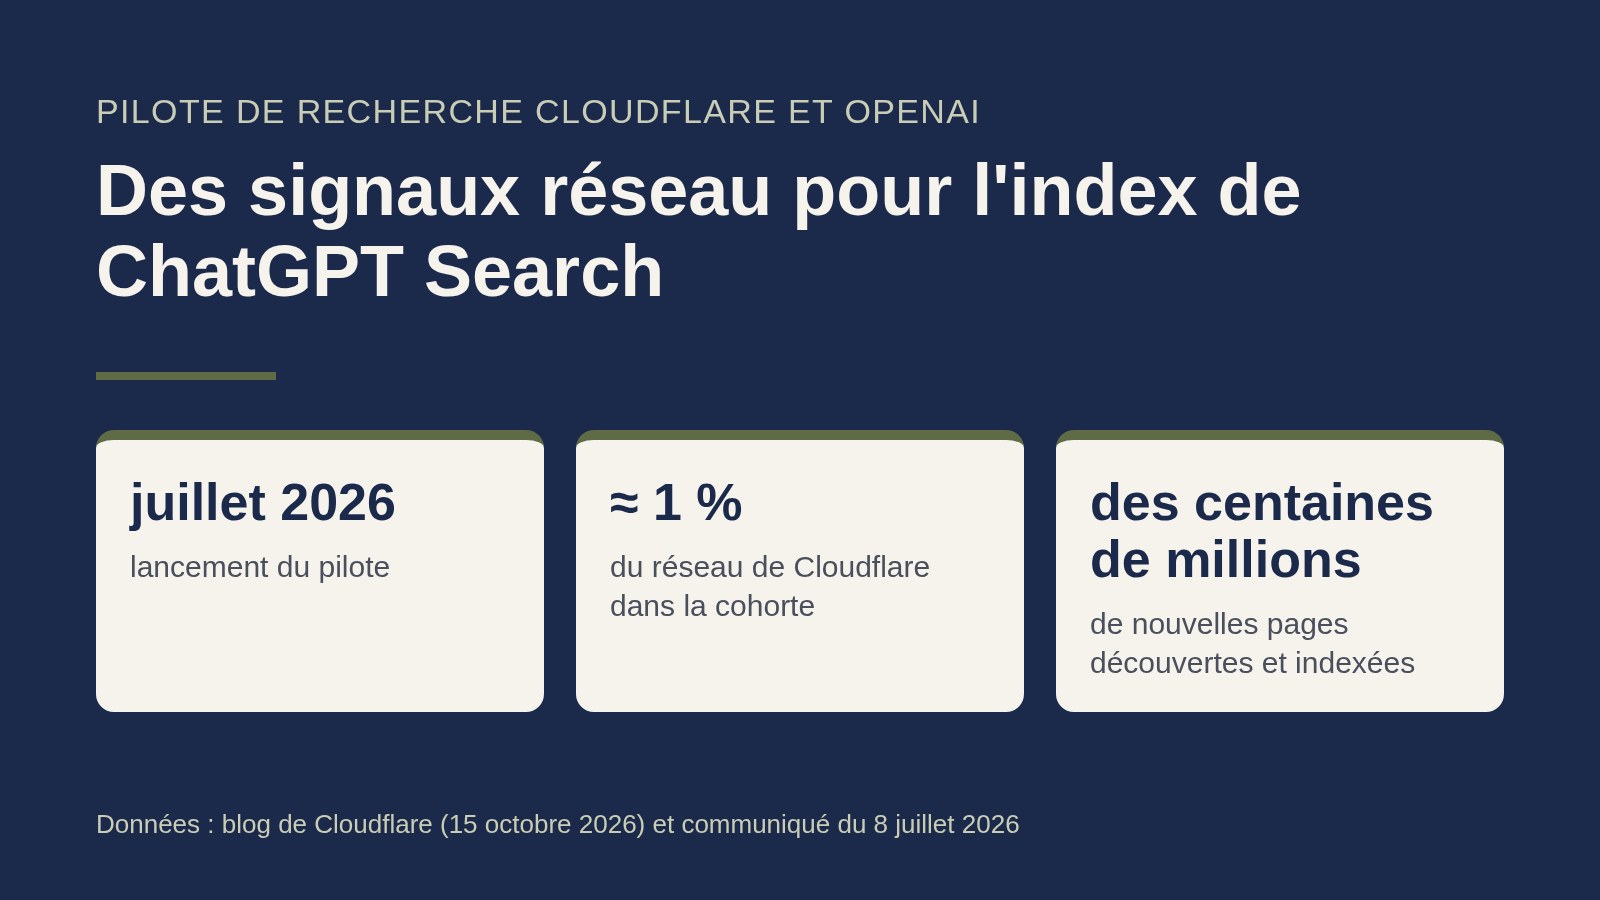

Les signaux tirés du réseau de Cloudflare ont permis au robot d’exploration d’OpenAI de découvrir et d’indexer « des centaines de millions » de nouvelles pages web, selon un billet publié le 15 octobre 2026 sur le blog de Cloudflare. Ce sont les premiers résultats d’un programme pilote de recherche mené avec OpenAI depuis juillet. ChatGPT peut désormais puiser dans ces pages pour répondre aux recherches de ses utilisateurs.
Le texte est signé par deux employés de Cloudflare, Matthew Conroy et Jack Galilee, et par deux employés d’OpenAI, Henry Aspegren et James Balfour. Le pilote n’a porté que sur une cohorte de sites participants, environ 1 % du réseau total de Cloudflare. Les auteurs parlent de résultats préliminaires et annoncent une nouvelle phase.
Un pilote annoncé le 8 juillet
Cloudflare avait présenté le programme le 8 juillet 2026, dans un communiqué publié aussi en français. Il s’agissait de vérifier si les informations issues des « sites web participants » de son réseau pouvaient aider les moteurs de recherche assistés par IA à trouver et à indexer plus efficacement les contenus du web ouvert. Le communiqué citait trois exemples de signaux : l’actualité des contenus, la qualité du trafic et les modifications réellement apportées aux pages.
Cloudflare y rappelait que plus de 20 % du web passe par son réseau, et précisait l’apport d’OpenAI : ses modèles, son système de recherche et de réponse, ainsi que des requêtes réelles d’utilisateurs pour les tests. « Le fait de disposer d’un ensemble d’informations à jour est important pour proposer des réponses précises aux utilisateurs de ChatGPT », déclarait alors Nick Ryder, vice-président de la recherche chez OpenAI. Matthew Prince, cofondateur et PDG de Cloudflare, parlait d’« améliorer l’efficacité de la recherche assistée par IA ».
Trois usages des signaux du réseau
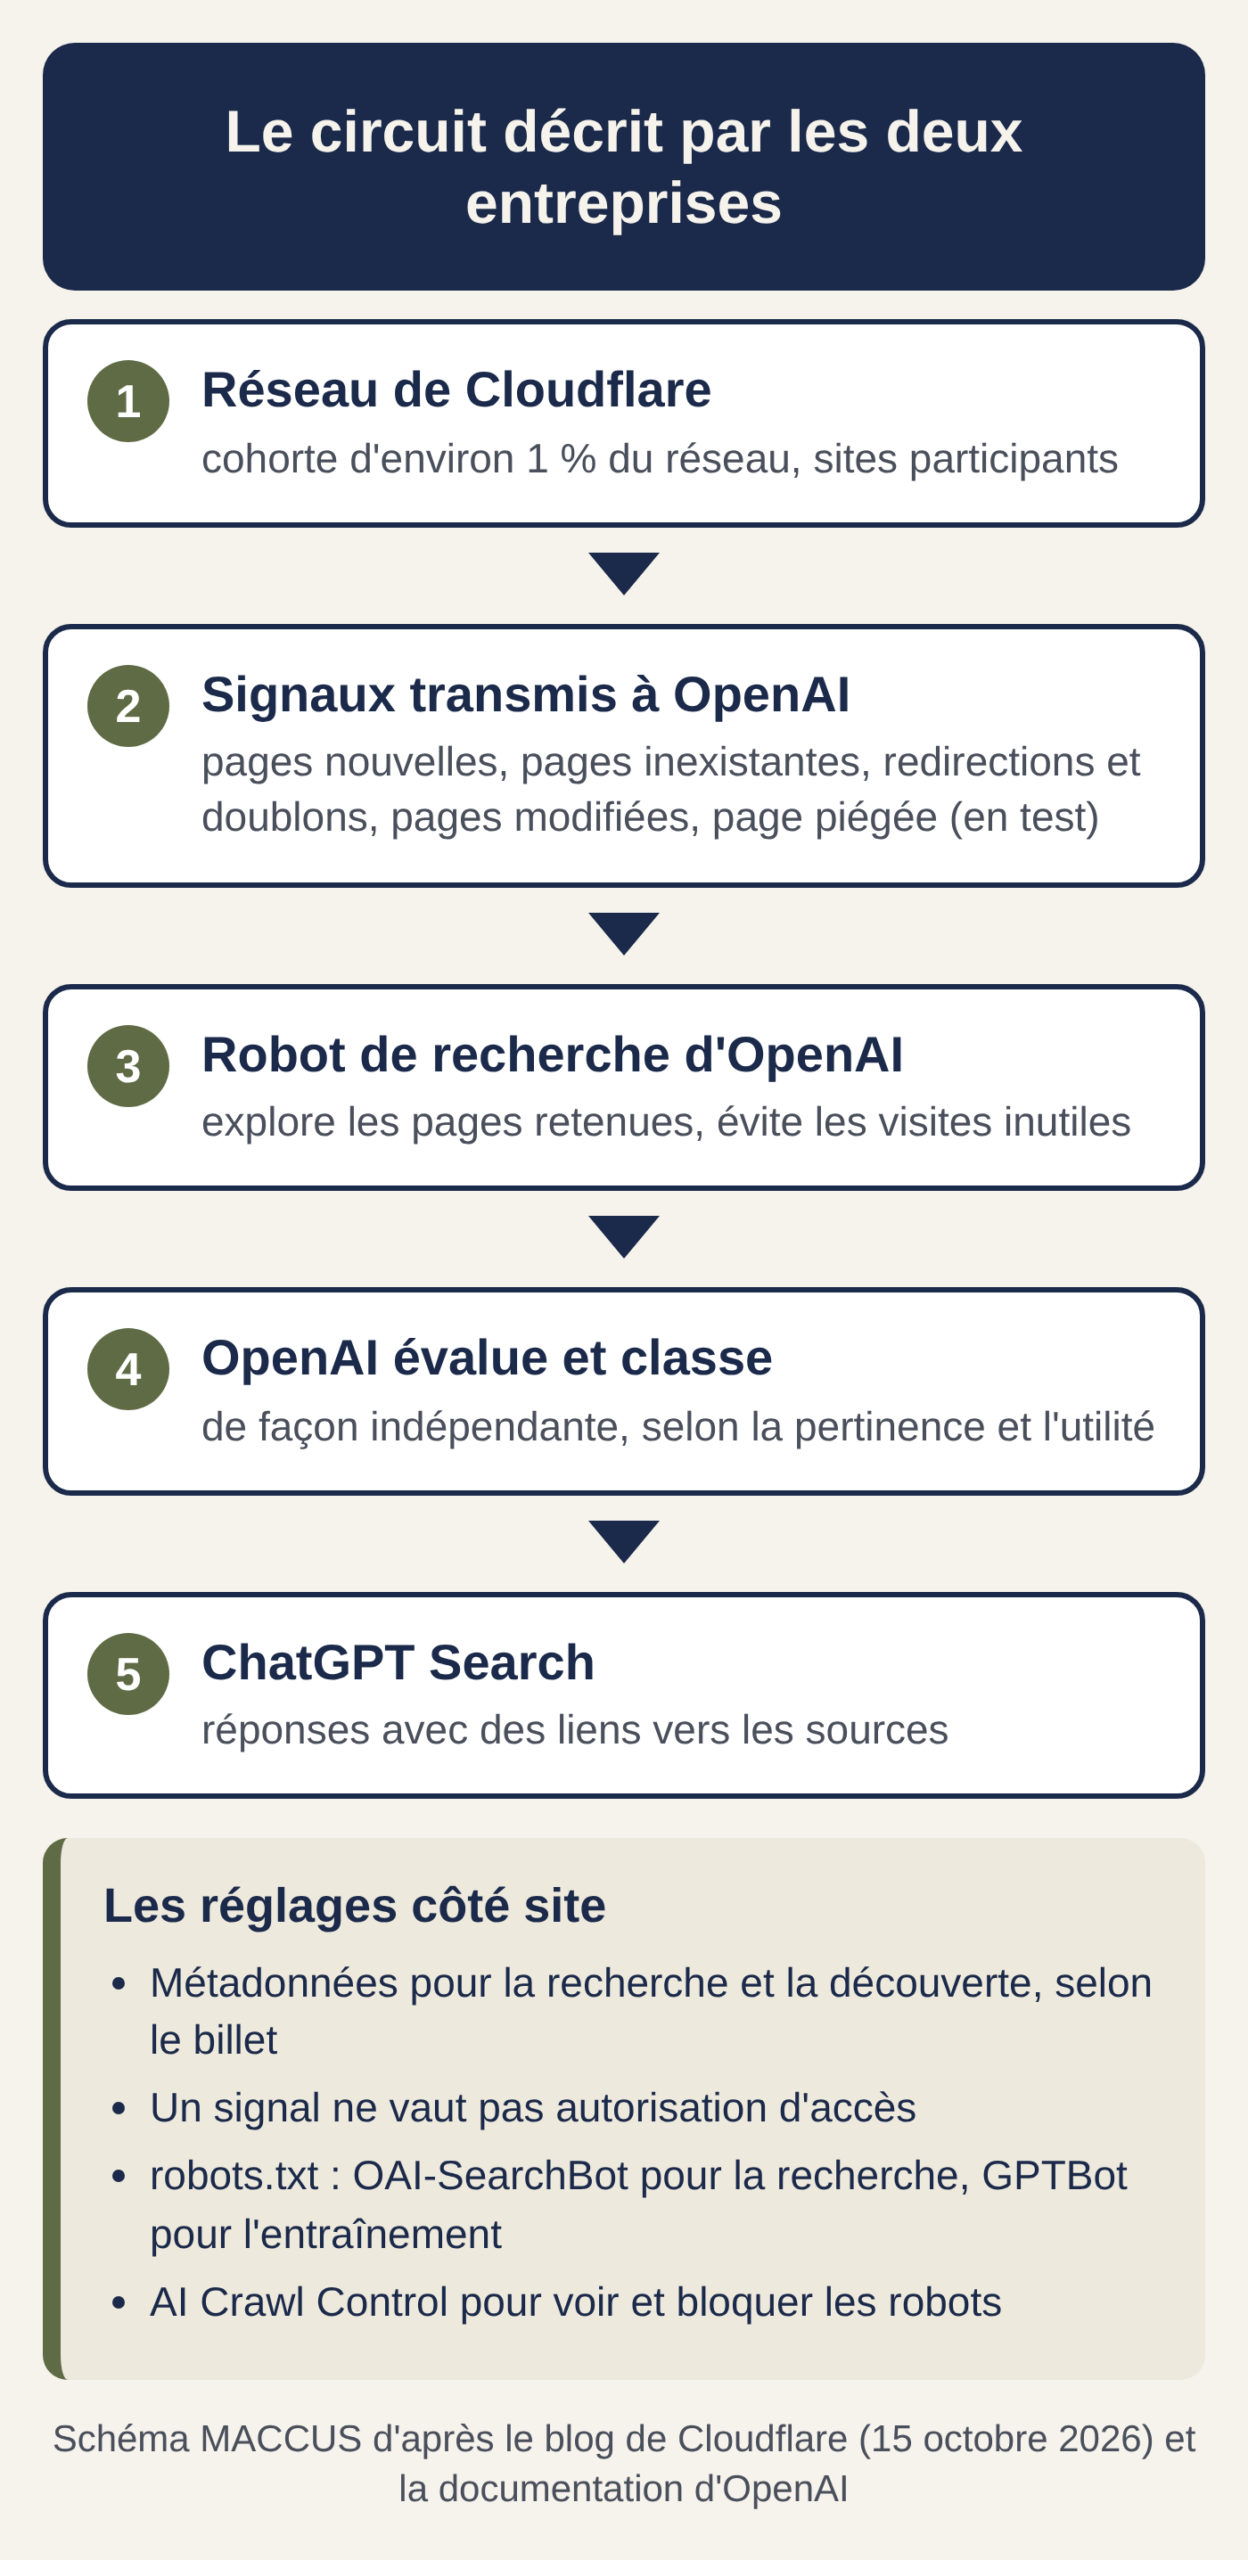
Le billet du 15 octobre décrit d’abord la découverte : signaler au robot d’OpenAI des pages qu’il n’avait jamais vues. Les auteurs citent en exemple le manuel d’un modèle précis de lave-linge, les conditions et les frais à jour d’une demande de passeport ou la carte d’un restaurant. Ces pages peuvent être utiles « même si peu d’autres sites renvoient vers elles », écrivent-ils.
Vient ensuite le tri, avant même que le robot n’envoie sa requête. Selon le billet, du trafic automatisé peut faire paraître intéressante une page qui n’existe pas, car des robots réclament sans cesse des fichiers absents. Certains sites redirigent aussi presque n’importe quelle adresse vers leur page d’accueil, et d’autres adresses mènent à des copies du même contenu. Repérer ces cas évite au robot des visites inutiles.
Les signaux de modification, enfin, indiquent si une page mérite une nouvelle visite. Les auteurs préviennent toutefois que la découverte de nouvelles pages peut d’abord faire augmenter l’exploration, le temps de les évaluer. Ils testent aussi des signaux capables de repérer une page piégée sur un site légitime, comme un faux formulaire de connexion placé par un attaquant, afin de signaler cette seule page plutôt que tout le domaine.
Le classement revient à OpenAI. D’après le billet, l’entreprise évalue et classe ensuite les pages de façon indépendante, selon leur pertinence et leur utilité.
Les données échangées et les réglages des sites
Le billet affirme que ces travaux utilisent des métadonnées sur le web, à des fins de recherche et de découverte, « plutôt que de partager le contenu des pages pour l’entraînement de modèles ». Il ajoute qu’un signal concernant une page ne vaut pas autorisation d’y accéder, et que les choix des propriétaires de domaines entrent en ligne de compte à chaque étape.
Dans sa documentation sur ses robots, OpenAI distingue OAI-SearchBot, qui sert à faire apparaître des sites dans les fonctions de recherche de ChatGPT, et GPTBot, qui collecte des contenus pouvant servir à l’entraînement de ses modèles. Un site qui bloque OAI-SearchBot n’apparaît pas dans les réponses de ChatGPT Search, sauf sous forme de lien de navigation.
Selon OpenAI, chaque réglage est indépendant des autres. L’entreprise précise aussi qu’il peut falloir environ 24 heures, pour la recherche, avant que ses systèmes prennent en compte une modification du robots.txt. Notre article sur les robots IA et le robots.txt détaille le rôle de chacun de ces robots.
Cloudflare renvoie de son côté vers AI Crawl Control, disponible dans toutes ses formules. L’outil montre quels services d’IA visitent un site, permet d’autoriser ou de bloquer chaque robot et de suivre le respect du robots.txt. La facturation à l’exploration (pay per crawl) y reste en bêta privée.
Les zones d’ombre du billet
Le billet ne dit pas comment la cohorte de 1 % a été choisie, si les sites concernés ont donné leur accord, ni quels pays et quelles langues ils représentent. Dès juillet, Luis Rijo relevait dans PPC Land que le communiqué ne nommait pas les sites participants, ne donnait pas leur nombre et ne décrivait aucune garantie encadrant les données partagées. Selon lui, rien n’y indiquait non plus que les éditeurs soient rémunérés.
Le chiffre de « centaines de millions » de pages reste un ordre de grandeur. Le billet ne donne ni le total exact, ni la taille de l’index d’OpenAI avant le pilote, ni la part de ces pages effectivement citées dans des réponses. Aucun chiffre n’est publié sur les visites envoyées aux sites.
Le billet indique que Cloudflare continue de travailler avec OpenAI pour comprendre comment une meilleure découverte des sites peut se traduire par des résultats commerciaux concrets. Le 16 octobre, William Chan notait dans Tech Times que la question du trafic restait ouverte.
Mesurer ces visites n’a rien de simple. Du 8 octobre au soir jusqu’au 15 ou 16 octobre, ChatGPT a ouvert une grande partie de ses liens sans paramètre de suivi ni référent. Google Analytics 4 a alors compté ces visites en accès direct, comme nous l’avons raconté dans notre article sur le bug du trafic ChatGPT.
Tech Times affirme aussi qu’un site qui refuse l’accès via AI Crawl Control ne fournit pas de signaux au pilote. Le billet de Cloudflare ne contient pas cette précision. Il ne détaille pas non plus les critères de classement de ChatGPT, au-delà de la pertinence et de l’utilité des pages. Sur le forum r/SEO de Reddit, un intervenant y voit pourtant l’indice que l’index de ChatGPT s’appuiera moins sur les liens que celui de Google, une lecture que ni Cloudflare ni OpenAI ne confirment.
Cloudflare change de cap, selon The Next Web
En juillet, Ana Maria Constantin soulignait déjà le contraste dans The Next Web. Cloudflare avait passé un an à armer les sites contre les robots d’IA, rappelait-elle, et leur avait permis l’année précédente de bloquer ces robots tant que les entreprises d’IA ne payaient pas les éditeurs. Avec ce pilote, l’entreprise aide un moteur d’IA à mieux explorer le web.
Le billet d’octobre ne parle que d’OpenAI. Il ne mentionne aucune autre entreprise, ni Google, ni Perplexity, ni Anthropic. Google continue d’explorer le web avec ses propres robots, à partir des liens qu’il trouve et des sitemaps que les sites lui soumettent. Nous avons décrit ses délais d’indexation le 11 octobre.
Notre analyse
Le pilote ajoute une voie de découverte des pages qui ne dépend pas des liens entrants : les signaux que relève l’intermédiaire technique par lequel transite le trafic du site. Pour être citée par un moteur de réponse, une page doit d’abord figurer dans son index. Cela ne suffit pas : OpenAI garde la main sur le classement.
Tel que décrit, le pilote n’a porté que sur sa cohorte de sites participants, environ 1 % du réseau de Cloudflare, et ni Cloudflare ni OpenAI n’ont publié la liste des sites concernés. Pour les autres sites, clients de Cloudflare ou non, l’accès laissé à OAI-SearchBot dans le robots.txt reste le réglage documenté par OpenAI pour apparaître dans ChatGPT Search.
Les résultats viennent des deux partenaires, sans mesure indépendante. Le seul résultat chiffré du billet est un ordre de grandeur. Le gain en visites pour les sites n’est pas encore quantifié, et les auteurs le renvoient eux-mêmes à la phase suivante.
Dans ce pilote, un intermédiaire placé devant plus d’un cinquième du web partage ses observations avec un seul moteur d’IA. Le billet ne dit pas si d’autres moteurs y auront accès.
Selon le billet, la prochaine phase doit améliorer la sélection des pages, tester des signaux de modification plus rapides et plus fiables, et mesurer ce qui se passe une fois le contenu découvert. Restent à suivre l’extension éventuelle du pilote au-delà de 1 % du réseau et l’apparition d’un réglage permettant aux clients de Cloudflare d’y participer ou de s’en retirer. Pour les éditeurs, le chiffre attendu reste celui des visites envoyées par ChatGPT aux pages découvertes de cette façon.
Sources
- Cloudflare and OpenAI: making AI discovery better for everyone, Cloudflare, 15 octobre 2026
- Cloudflare annonce un programme pilote de recherche avec OpenAI, Cloudflare, 8 juillet 2026
- Overview of OpenAI Crawlers, OpenAI, consulté le 19 octobre 2026
- AI Crawl Control, Cloudflare, mis à jour le 14 août 2026
- Cloudflare gives OpenAI network signals covering 20% of the web, PPC Land, 12 juillet 2026
- ChatGPT Search Gained Hundreds of Millions of Pages Link Crawlers Never Found, Tech Times, 16 octobre 2026
- Cloudflare spent a year blocking AI crawlers. Now it’s helping OpenAI index the web, The Next Web, 8 juillet 2026
Image d’en-tête : graphique MACCUS, données Cloudflare (blog du 15 octobre 2026 et communiqué du 8 juillet 2026)