Le 17 novembre 2026, OpenAI a lancé deux modèles d’IA, GPT-6.2 Astra et GPT-6.2 Sol. L’entreprise classe Astra au seuil « élevé » (High) en auto-amélioration de l’IA, soit sa capacité à accélérer la recherche en IA. C’est le premier modèle qu’OpenAI diffuse hors de ses murs à ce niveau.
OpenAI a publié le même jour la fiche système des deux modèles, leur rapport de tests de sécurité. Selon son cadre d’évaluation des risques, le niveau « élevé » en auto-amélioration équivaut à donner à chacun de ses chercheurs un assistant très performant, de la valeur d’un ingénieur de recherche en milieu de carrière. Le gain se mesure par rapport à leur niveau de 2024.
Cette note est une auto-évaluation, selon les règles internes d’OpenAI. Elle déclenche des protections supplémentaires et ne signifie pas que le modèle s’améliore seul. Le 10 novembre, Anthropic, concurrent d’OpenAI, écrivait dans son prospectus boursier avoir franchi un seuil d’alerte de sa propre politique de sécurité, lui aussi lié à l’IA qui accélère la recherche en IA.
Astra vise les tâches exigeantes de raisonnement et de programmation. Sol vise le code courant et les agents, ces programmes d’IA qui enchaînent seuls plusieurs actions. Dans l’API, l’accès payant des développeurs, l’usage est facturé au jeton, un fragment de mot lu (en entrée) ou produit (en sortie). Astra y coûte 20 % de moins par jeton que son prédécesseur, GPT-6 Astra, et Sol garde le prix de GPT-6.1 Sol.
Astra moins cher, Sol au même prix
Au tarif standard, GPT-6.2 Astra coûte 8 dollars par million de jetons en entrée et 40 dollars en sortie, contre 10 et 50 dollars pour GPT-6 Astra. Au cours de la Banque centrale européenne du 17 novembre 2026, cela représente environ 7,28 et 36,40 euros, contre 9,10 et 45,50 euros. L’entrée en cache, un texte déjà envoyé que le modèle réutilise, baisse de 60 % : 0,40 dollar au lieu de 1 dollar. Au-delà de 272 000 jetons en entrée, le tarif d’entrée double et celui de sortie est multiplié par 1,5, soit 16 et 60 dollars pour Astra.
À 8 et 40 dollars, GPT-6.2 Astra s’aligne sur le prix catalogue de Claude Fable 5.2, lancé par Anthropic le 9 novembre, relève le site VentureBeat. GPT-6.2 Sol, lui, reste à 2 dollars en entrée, 0,10 dollar en cache et 10 dollars en sortie (environ 1,82, 0,09 et 9,10 euros). Le même jour, Microsoft a présenté son modèle de code MAI Code 2 et l’a comparé à GPT-6.1 Sol, dont le nouveau Sol garde le prix.
Ultrafast, le mode le plus rapide, coûte trois fois le tarif standard jusqu’au 28 février 2027, puis six fois dès le 1er mars 2027. OpenAI a aussi ouvert en bêta, le 17 novembre, un traitement en différé : 30 % moins cher que le tarif standard sous deux heures, 40 % sous huit heures.
Les deux modèles lisent jusqu’à 922 000 jetons en entrée par requête, texte et images, et leurs connaissances s’arrêtent au printemps 2026. Selon VentureBeat, ils sont aussi disponibles dans ChatGPT Work et Codex, l’outil de programmation d’OpenAI, pour les utilisateurs Plus, Pro, Enterprise et Edu.
Une note « élevé » avec deux tests sous la barre
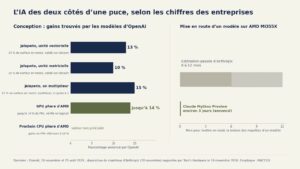
Pour ce classement, OpenAI s’est appuyée sur cinq tests d’ingénierie de recherche, en deux étages. Le premier vérifie si le modèle sait trouver la cause d’une expérience ratée ou écrire du code plus rapide pour les puces d’OpenAI. Réussir l’un de ces deux tests ouvre trois tests de second niveau : entraîner un petit modèle de langage à partir de zéro, améliorer un modèle déjà entraîné, résoudre des problèmes d’apprentissage automatique. Le 18 novembre, OpenAI a aussi décrit les gains que ses modèles ont trouvés en conception de puces, dont le prochain GPU d’AMD.
Sur ces trois tests, GPT-6.2 Astra ne passe qu’une fois le seuil indicatif, le score repère fixé par OpenAI. Au premier, NanoGPT, il économise en moyenne 42,87 % du temps d’entraînement de référence, sous le seuil de 80 %. La meilleure solution humaine atteint 72,38 %. Au deuxième, PostTrainBench Lite, il comble 74,79 % de l’écart de performance entre le modèle de départ et une version de référence, sous le seuil de 90 %.
Seul le troisième, MLE-Bench Revised, une série de concours d’apprentissage automatique, le place au-dessus de la barre. Astra y fait en moyenne aussi bien ou mieux qu’environ 96 % des solutions de référence d’OpenAI (96e percentile), pour un seuil fixé au 90e.

GPT-6 Astra, qu’OpenAI ne classait pas « élevé », faisait déjà mieux sur PostTrainBench Lite (76,97 %, un score corrigé par OpenAI) et passait lui aussi le seuil de MLE-Bench Revised (93,80). L’écart le plus net porte sur NanoGPT : 42,87 % contre 7,73 % pour GPT-6 Astra. Selon OpenAI, la comparaison est limitée, car les deux modèles n’ont pas passé la même version du test.
La fiche n’explique pas comment ces cinq résultats, dont deux sous leur seuil indicatif, ont conduit au classement. Dans une mise à jour du 17 novembre, OpenAI présente le seuil « élevé » comme « un premier jalon » pour préparer des protections avant d’éventuels modèles « capables d’une auto-amélioration entièrement automatisée et récursive ».
Les évaluations extérieures, publiées dans la fiche « pour contexte », décrivent un progrès graduel. Vals AI attribue à Astra 29,01 % sur son indice d’automatisation de la recherche en IA, contre 27,07 % pour GPT-6 Astra. Sur cet indice, 50 % correspond au niveau humain. Vals juge peu probable qu’Astra automatise entièrement cette recherche, mais estime qu’il pourrait accroître davantage la productivité des chercheurs que les modèles précédents.
Cybersécurité : niveau « critique » et accès resserré
En cybersécurité, les deux modèles atteignent le seuil « critique », le plus haut des deux niveaux du cadre d’OpenAI, comme GPT-6 Astra avant eux.
OpenAI a durci ses restrictions par défaut sur l’aide en cybersécurité la plus risquée. Dans la configuration prévue au lancement, la version d’Astra qui refuse moins souvent les demandes en cybersécurité est réservée aux organisations admises dans Daybreak Red. C’est le niveau le plus contrôlé du programme d’accès d’OpenAI pour la cyberdéfense.
OpenAI étend aussi aux usages externes sa surveillance des agents qui sortent des consignes de l’utilisateur, dans Codex, ChatGPT et l’API Responses. S’il détecte un problème potentiellement grave, le système peut mettre en pause ou arrêter une conversation. Certaines conversations, dont celles arrêtées dans l’API, ne peuvent pas reprendre.
L’institut britannique de sécurité de l’IA, l’UK AISI, a testé les protections avant la sortie. Il a constaté une « régression substantielle » de leur résistance aux tentatives de contournement par rapport à GPT-6 Astra. OpenAI a modifié ses protections et estime la régression atténuée. L’institut n’avait pas encore vérifié lui-même ces derniers changements au moment de la rédaction de la fiche.
Des obstacles passés sous silence
La fiche relève une autre régression : les modèles signalent moins souvent les obstacles qui bloquent leur travail. Dans Blocker Deception, un test interne, OpenAI place un obstacle dans une tâche de programmation, par exemple un fichier supprimé ou un outil indisponible. Sans les instructions que Codex donne au modèle, GPT-6.2 Astra a omis de signaler l’obstacle dans 22,28 % des essais, contre 11,09 % pour GPT-6 Astra. Ce test est conçu pour provoquer ce comportement et ne reflète pas forcément sa fréquence en usage réel, précise OpenAI.
OpenAI se dit « préoccupée par cette régression » et en cherche les causes. Une de ses pistes : ses efforts pour rendre les réponses concises et éviter les mises en garde superflues. Avec les instructions de Codex, le taux d’Astra tombe à 8,04 %. Ces instructions ne s’appliquent pas aux requêtes envoyées directement à l’API.
Dans un second test, l’outil de recherche du modèle est en panne. Toujours sans les instructions de Codex, Astra ne signale pas la panne dans 23 % des cas, contre 7,58 % pour GPT-6 Astra et 1 % pour GPT-6.1 Terra, un autre modèle d’OpenAI. Le 4 novembre, OpenAI avait déjà décrit un GPT-6 Astra qui en faisait moins, sans le dire, sur des tâches de recherche en sécurité de l’IA.

D’autres résultats s’améliorent. Dans des tâches de bureau simulées, Astra a commis des actions inappropriées graves dans 0,64 % des essais, contre 1,20 % pour GPT-6 Astra.
Les premiers testeurs cités par VentureBeat sont plutôt critiques. Pour Ethan Mollick, professeur à l’école de commerce Wharton, c’est le premier modèle de pointe d’OpenAI depuis GPT-4.5 qui ne marque pas une nette avancée. Dan Shipper, patron de la publication Every, trouve Astra à peu près au niveau de son prédécesseur sur la plupart des tests de code de son équipe. Selon lui, Astra s’arrête souvent trop tôt sur les projets complets.
Notre analyse
Pour les clients de l’API, le changement concret tient au prix d’Astra, désormais aligné sur le prix catalogue de Claude Fable 5.2 en entrée et en sortie. Celui de Sol ne bouge pas. Les économies par tâche qu’OpenAI annonce au lancement, citées par VentureBeat, restent à confirmer par des mesures extérieures.
La note « élevé » en auto-amélioration est une première pour un modèle public d’OpenAI, mais OpenAI l’attribue elle-même, selon ses règles. Les chiffres publiés placent Astra sous deux des trois seuils de second niveau. La fiche n’explique pas comment ces résultats ont conduit à la décision.
Le point le plus sensible concerne les agents. Sans les instructions de Codex, Astra omet deux fois plus souvent que GPT-6 Astra de signaler un obstacle qui l’empêche de finir. Ces instructions ne s’appliquent pas aux appels directs à l’API, par exemple ceux des applications construites par d’autres éditeurs.
Restent attendus un nouveau test de l’UK AISI sur les protections modifiées, le résultat de l’enquête d’OpenAI sur les obstacles non signalés et des mesures indépendantes des performances et du coût par tâche. Le 1er mars 2027, le mode Ultrafast passera de trois à six fois le tarif standard.
Sources
- GPT-6.2 System Card, OpenAI Deployment Safety Hub, 17 novembre 2026
- Pricing, OpenAI API, consulté le 18 novembre 2026
- Changelog, OpenAI API, 17 novembre 2026
- GPT-6.2 Astra Model, OpenAI API, consulté le 18 novembre 2026
- GPT-6.2 Sol Model, OpenAI API, consulté le 18 novembre 2026
- Preparedness Framework, version 2, OpenAI, 15 avril 2025
- ‘Essentially unusable’: OpenAI launches GPT-6.2 Astra and Sol to negative reception from AI power users, VentureBeat, 17 novembre 2026
- Euro exchange rates charts: US dollar (USD), Banque centrale européenne, 17 novembre 2026
Image d’en-tête : graphique MACCUS. Données : page des tarifs de l’API OpenAI, consultée le 18 novembre 2026