
Anthropic commencera le 3 novembre 2026 à appliquer son filigrane texte aux réponses de quatre modèles Claude plus anciens : Mythos 5, Opus 4.7, Opus 4.6 et Sonnet 4.6. L’éditeur l’a annoncé aux organisations qui utilisent au moins l’un de ces modèles sur son API, la Claude Platform, dans un courriel dont une capture a été rendue publique le 28 octobre. Le message précise qu’il s’agit du filigrane que portent déjà les modèles récents, dont Claude Opus 5.5, et que le déploiement sur Amazon Bedrock « pourrait prendre quelques jours de plus ».
C’est le consultant italien Pasquale Pillitteri qui a publié cette capture sur son blog. Le courriel s’intitule « Text watermarking is coming to more Claude models ». Au 31 octobre, la page d’aide d’Anthropic ne mentionnait pas cette date, et les notes de version de sa plateforme ne citaient que le filigrane des modèles récents. Le 30 octobre au soir, le sujet figurait parmi les fils les plus populaires de r/ClaudeAI, où un utilisateur résumait son grief : ceux dont les textes portent la marque ne peuvent pas la vérifier eux-mêmes.
Quatre modèles de plus le 3 novembre
La page d’aide d’Anthropic consacrée au marquage des contenus, mise à jour le 28 octobre, liste seize modèles dans un tableau. Dans sa version consultée le 31 octobre, neuf portent déjà le filigrane texte, sur les services d’Anthropic comme chez les hébergeurs partenaires : Fable 5.1, Fable 5, Mythos 5.1, Opus 5.5, Opus 5, Opus 4.8, Sonnet 5.5, Sonnet 5 et Haiku 5.5. Pour les sept autres, dont les quatre visés par le courriel, le tableau ne coche que les Content Credentials (C2PA) ajoutés aux fichiers.
Après le 3 novembre, trois modèles n’auront toujours pas de date qui leur soit propre : Opus 4.5, Sonnet 4.5 et Haiku 4.5. Sonnet 4.5 doit quitter l’API Claude le 30 novembre 2026, selon les notes de version d’Anthropic du 30 septembre. Haiku 4.5, lui, devait quitter le 29 octobre le sélecteur de modèles des formules Gratuit, Pro et Max, selon l’annonce d’Anthropic du 15 octobre, mais reste disponible par l’API. Notre guide des modèles Claude situe ces générations les unes par rapport aux autres.
Anthropic a déjà procédé ainsi en septembre. Un courriel du 24 septembre, rapporté par The Decoder puis par heise online, annonçait le marquage de Fable 5, Sonnet 5 et Opus 4.8 à partir du 30 septembre. Selon heise, Anthropic prévoyait d’équiper d’ici au 2 décembre les autres modèles plus anciens concernés. Opus 5, sorti plus tôt, avait lui aussi été équipé après coup, d’après le même article.
Un calendrier fixé par l’AI Act
Anthropic justifie le marquage par le règlement européen sur l’intelligence artificielle. L’article 50, applicable depuis le 2 août 2026, impose aux fournisseurs de systèmes qui génèrent du texte, du son, des images ou de la vidéo de veiller à ce que leurs sorties soient « marquées dans un format lisible par machine et identifiables comme ayant été générées ou manipulées par une IA ». L’éditeur figure parmi les quelque 190 signataires du code de bonnes pratiques européen sur la transparence des contenus générés par IA, qu’il a signé en juillet, selon son billet du 14 août.
Pour les systèmes mis sur le marché avant le 2 août, le règlement omnibus (UE) 2026/1744 a ajouté un délai. L’article 111, paragraphe 4, leur laisse jusqu’au 2 décembre 2026 pour se conformer à l’obligation de marquage. La date du 3 novembre place donc les quatre modèles à un mois de l’échéance.
Le texte européen prévoit une exception : l’obligation ne s’applique pas dans la mesure où les systèmes « remplissent une fonction d’assistance pour la mise en forme standard » ou ne modifient pas de manière substantielle les données fournies. La page d’aide d’Anthropic indique pour sa part que les filigranes s’appliqueront à tout le texte généré.
La marque tient au choix des mots
Le filigrane repose sur une version de SynthID-Text, la méthode présentée par Google DeepMind dans Nature en 2024, selon le billet technique publié par Anthropic le 14 août. Quand plusieurs mots conviendraient aussi bien, le choix ne relève plus du hasard ordinaire : il dépend d’une clé secrète combinée aux mots précédents. Rien n’est ajouté au texte, ni caractère caché ni token supplémentaire. L’éditeur assure aussi que la marque ne permet de remonter ni à une personne, ni à une organisation, ni à une conversation.
Le marquage se fait au niveau du modèle. Il couvre l’API, les applications Claude, Claude Code, Claude Cowork et Claude Tag, ainsi que les modèles servis par AWS, Google Cloud et Microsoft Foundry. Il s’applique partout où Claude est proposé, ce qu’Anthropic explique par l’absence, à ce stade, d’un moyen durable de le limiter à une région.
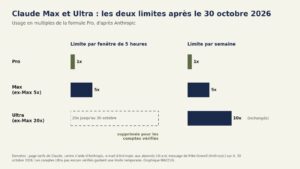
Ni la page d’aide ni le billet ne mentionnent de moyen de le désactiver, pas même sur l’offre la plus chère, l’ancienne Max 20x rebaptisée Ultra le 30 octobre. Selon heise online, les utilisateurs ne peuvent pas le couper. Les fichiers créés par Claude, comme les images PNG ou JPEG, reçoivent quant à eux des métadonnées signées au standard C2PA, que l’outil gratuit Claude Content Checker permet de vérifier.
Qui peut détecter la marque ?
L’API de détection du filigrane texte est en préversion privée. Selon la page d’aide, elle est ouverte aux organisations éligibles au titre du droit européen, comme les régulateurs, les forces de l’ordre, les médias, les vérificateurs de faits, les chercheurs indépendants, les établissements d’enseignement et les organisations de la société civile de l’Union. Les entreprises tenues de vérifier le marquage pour leur propre conformité peuvent aussi y accéder. Anthropic dit vouloir élargir cet accès avec le temps et propose un formulaire de demande.
OpenAI a fait un autre choix. Le 5 octobre, TechCrunch rapportait que son filigrane textGrain serait appliqué à ChatGPT et à Codex dans l’Union européenne seulement, et proposé en option, désactivée par défaut, aux développeurs de son API. Comme chez Anthropic, l’accès à son détecteur est d’abord réservé à des chercheurs agréés et à des organisations spécialisées.
Les limites reconnues par Anthropic
Anthropic présente une marque détectée comme un signal « pas totalement concluant ». Un texte marqué peut n’avoir été que relu, traduit ou résumé par Claude à partir d’un original écrit ailleurs, ou avoir été modifié ensuite. L’absence de marque, elle, ne prouve pas qu’un humain a écrit le texte : un passage trop court, une réécriture lourde, une paraphrase, une traduction ou un modèle antérieur au marquage suffisent à l’expliquer.
Le billet du 14 août précise que des retouches légères n’effaceront probablement pas tout le filigrane, alors qu’une réécriture qui remplace chaque mot le fera. Une traduction faite par Claude est marquée, puisque chaque mot y est choisi par le modèle. Le signal est plus faible dans les passages factuels, le code et les corrections légères, où peu de mots sont interchangeables. Anthropic affirme que le marquage n’a pas d’effet pratique sur la qualité des réponses, en s’appuyant sur ses tests internes et sur l’étude de Google DeepMind, mais ne publie aucun taux de faux positifs.
L’annonce d’août avait suscité des protestations chez une partie des abonnés. Le 15 août, Gizmodo, reprenant Business Insider, rapportait que certains utilisateurs ne voulaient pas que leurs clients ou leurs enseignants repèrent leurs textes générés par IA. Anthropic avait répondu à Business Insider ne pas constater de hausse des résiliations.
Notre analyse
Jusqu’ici, selon la page d’aide, Opus 4.7, Opus 4.6, Sonnet 4.6 et Mythos 5 produisaient du texte sans filigrane, y compris dans les outils et les automatisations branchés sur l’API. Après le 3 novembre, il ne restera que trois modèles sans date propre, dont Sonnet 4.5, qui quitte l’API Claude fin novembre. Pour les agences, les traducteurs et les rédacteurs qui travaillent avec Claude, presque tout le texte rédigé ou traduit par le modèle portera désormais la marque. Une relecture légère, elle, en laisse souvent trop peu pour être détectée, selon Anthropic.
Le filigrane ne règle pas la question de l’étiquetage. L’article 50, paragraphe 4, crée une obligation distincte pour les déployeurs : celui qui publie un texte généré ou manipulé par IA « dans le but d’informer le public sur des questions d’intérêt public » doit le signaler. Elle ne s’applique pas si le texte a fait l’objet d’un examen humain ou d’un contrôle éditorial et qu’une personne en assume la responsabilité éditoriale. La page d’aide d’Anthropic rappelle elle-même que les entreprises qui intègrent Claude dans leurs produits doivent évaluer leurs propres obligations au titre de l’article 50.
Anthropic assure que la qualité ne change pas et que la marque résiste aux retouches légères. Sans détecteur public, seules les organisations admises dans la préversion peuvent le vérifier, faux positifs compris. Une question reste sans réponse publique : où passe la frontière entre une relecture marquée par Claude et la « mise en forme standard » que le règlement exclut de l’obligation ?
À partir du 3 novembre, la page d’aide et les notes de version devraient refléter le changement. Selon Pasquale Pillitteri, le courriel ne donne aucune date pour Google Cloud et Microsoft Foundry. Pour Opus 4.5 et Haiku 4.5, aucune date propre n’est annoncée, alors qu’Anthropic visait en septembre le 2 décembre pour ses modèles plus anciens. Reste l’ouverture de l’API de détection au-delà des organisations éligibles, qu’Anthropic promet sans calendrier.
Sources
- How Claude marks AI-generated content, Anthropic (centre d’aide), mis à jour le 28 octobre 2026, consulté le 31 octobre 2026
- How Claude’s text watermarking works, Anthropic, 14 août 2026
- Claude Text Watermark Arrives on Opus 4.7, 4.6 and Sonnet 4.6 on November 3, Pasquale Pillitteri (blog, capture du courriel d’Anthropic), 28 octobre 2026
- Claude Platform release notes, Anthropic, consulté le 31 octobre 2026
- Article 50 : Obligations de transparence pour les fournisseurs et les déployeurs de certains systèmes d’IA, Commission européenne (AI Act Service Desk), consulté le 31 octobre 2026
- Article 111 : Systèmes d’IA déjà mis sur le marché ou mis en service et modèles d’IA à usage général déjà mis sur le marché, Commission européenne (AI Act Service Desk), consulté le 31 octobre 2026
- Watermarks for AI texts: Anthropic expands application, heise online, 25 septembre 2026
- OpenAI will start watermarking ChatGPT’s text in the EU, TechCrunch, 5 octobre 2026
Image d’en-tête : graphique MACCUS, données Anthropic (page d’aide consultée le 31 octobre 2026, courriel aux clients publié par Pasquale Pillitteri le 28 octobre 2026) et règlement (UE) 2026/1744.