Vous utilisez sans doute déjà une IA conversationnelle pour rédiger un e-mail ou résumer un document. Cette page va plus loin. Elle vous apprend trois choses réutilisables dans n’importe quel métier : choisir le bon modèle pour une tâche donnée, tester ce que l’IA produit avant de lui faire confiance, et comprendre ce que veulent vraiment dire les « agents » dont tout le monde parle.
Les trois exercices ci-dessous se font au clavier, avec des documents fictifs fournis. Aucun connecteur, aucune installation technique, aucune donnée réelle. Comptez une petite heure pour les trois. À la fin, vous aurez une méthode que vous pourrez appliquer aux articles par métier de ce site.
Les noms de modèles cités valent au 11 septembre 2026. Le marché bouge vite : chaque tableau renvoie vers la page officielle à revérifier.
Fichiers d’exemple
Ces fichiers contiennent uniquement des données fictives.
- E-mail fictif de client
- Facture fictive
- Brief fictif de mission
- Corrigé de la facture, à consulter après l’exercice
Six mots à distinguer avant tout
La confusion vient presque toujours du vocabulaire. Six termes reviennent partout, ils ne désignent pas la même chose.
- Le modèle est le moteur qui produit le texte. Claude Opus 5, gpt-5.6, Gemini 3.x, Mistral Large 3 sont des modèles.
- L’application grand public est la fenêtre dans laquelle vous parlez au modèle. ChatGPT, Claude, l’app Gemini, Le Chat et Copilot sont des applications. Pour départager les deux premières sur des tâches de bureau, voyez le comparatif Claude ou ChatGPT pour une petite entreprise.
- L’abonnement est le plan payant qui débloque des capacités et fixe vos limites d’usage (Free, Plus, Pro, Max, Team, Business, Workspace). Pour Claude, voyez quel abonnement choisir entre Pro, Max et Team.
- L’API est l’accès pour développeurs, facturé à l’usage. Elle sert à brancher un modèle dans un logiciel maison, pas à discuter dans une fenêtre.
- Le connecteur est le pont entre l’IA et un logiciel que vous utilisez déjà (Gmail, Drive, un CRM, un ERP). Il donne à l’IA le droit de lire ou d’écrire quelque part. Pour Claude, le guide des connecteurs Gmail, Google Drive et agenda montre où cliquer et quelles autorisations régler.
- L’exécuteur d’automatisation, souvent appelé agent runner, est ce qui fait tourner un vrai agent sans vous : il enchaîne les étapes, appelle les connecteurs, s’arrête pour une validation. Copilot Studio, Workspace Studio, Zapier, Make, n8n ou un service géré jouent ce rôle.
Retenez la hiérarchie : un modèle vit dans une application, débloquée par un abonnement, éventuellement reliée à vos logiciels par des connecteurs, et mise en mouvement par un exécuteur d’automatisation.
Choisir une famille de modèle
Pour comparer les modèles, on peut distinguer trois profils d’usage : les tâches simples à traiter rapidement, le travail courant et les tâches qui demandent une analyse approfondie. Un repère simple, à ajuster en testant. Une tâche courte, unique, sans document ni recherche se traite souvent très bien avec le modèle rapide.
Une tâche qui demande de raisonner, de lire des documents longs, ou qui porte un enjeu réel (des chiffres, un contrat, un client important) justifie souvent le modèle de raisonnement. Entre les deux, le modèle équilibré couvre l’usage courant. Le bon choix dépend de la tâche : vérifiez sur les vôtres plutôt que de suivre une réputation.
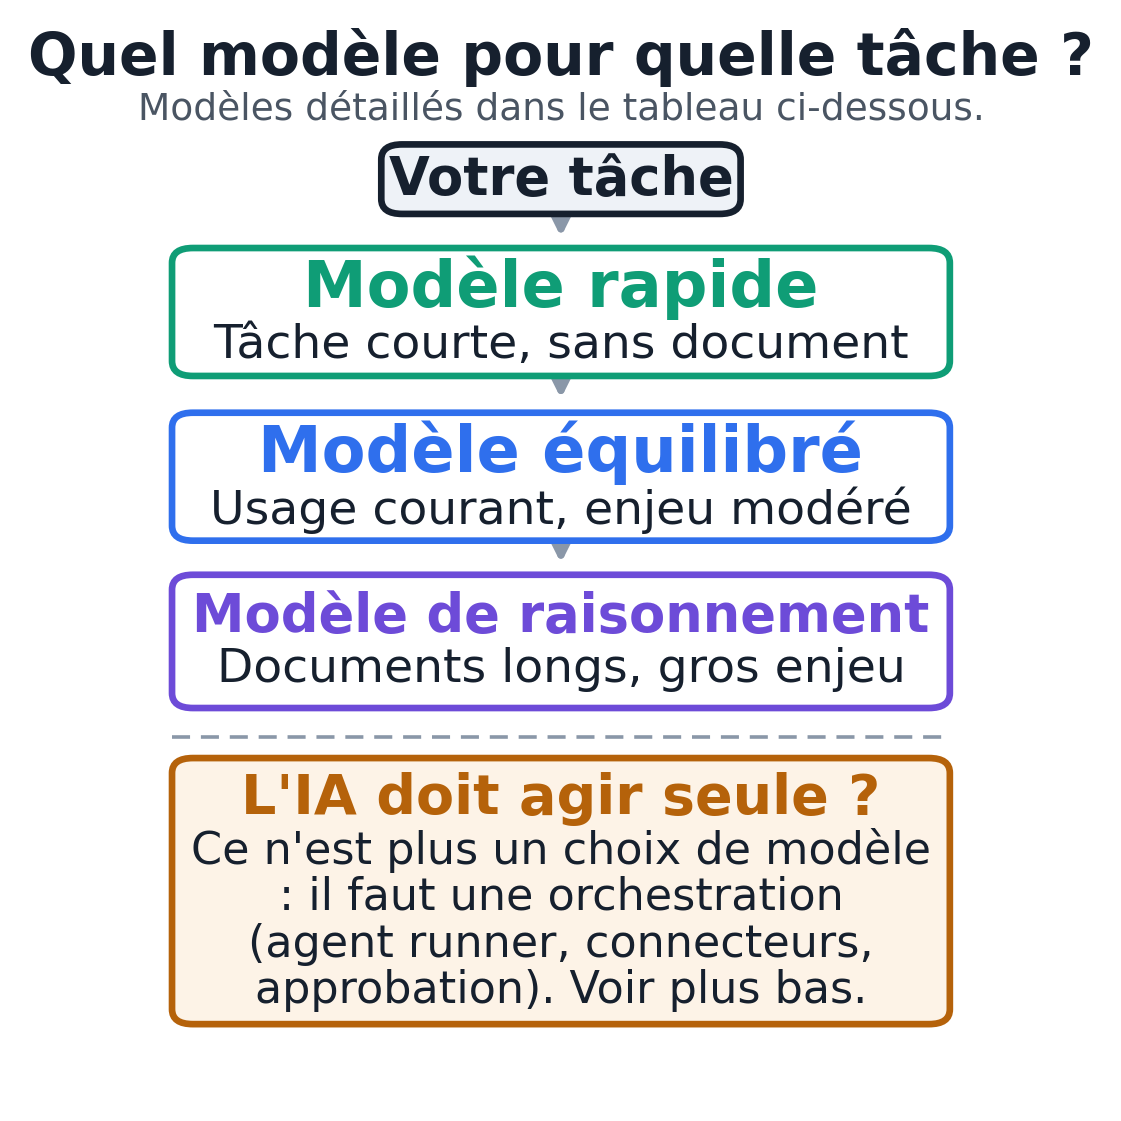
Voici les modèles courants par besoin, d’après les pages officielles des fournisseurs le 11 septembre 2026. Ce sont les modèles sous-jacents. Leur nom exact dans le sélecteur d’une application grand public peut différer, et certains (comme gpt-5.6-luna) sont des identifiants d’API, pas des libellés que vous verrez dans ChatGPT. Dans l’application, repérez la famille (rapide, équilibré, raisonnement) plutôt qu’un identifiant précis.
| Besoin | OpenAI | Anthropic | Mistral | |
|---|---|---|---|---|
| Rapide, simple, gros volume | gpt-5.6-luna | Claude Haiku 4.5 | Gemini Flash-Lite | Mistral Small 4 |
| Usage courant équilibré | gpt-5.6-terra | Claude Sonnet 5 | Gemini Flash | Mistral Medium 3.5 |
| Raisonnement, documents, enjeu élevé | gpt-5.6-sol ou gpt-6-astra | Claude Opus 5 ou Fable 5.1 | Gemini 3.1 Pro ou 2.5 Pro | Mistral Large 3 |
Microsoft n’expose pas ses propres modèles dans Copilot grand public : Copilot s’appuie surtout sur les modèles d’OpenAI, à l’intérieur de Word, Excel et Outlook. Si votre entreprise vit dans Microsoft 365, c’est là que la question se pose. Vérifiez la disponibilité dans votre licence.
Deux points de vigilance avant d’y confier des données. Sur les plans grand public, vos échanges peuvent servir à entraîner de futurs modèles sauf si vous désactivez l’option à la main ; les offres professionnelles excluent en général cet entraînement par défaut, mais vérifiez la politique de votre produit et de votre plan.
Sur la résidence des données en Europe, les options dépendent du produit et du plan. Mistral est une entreprise française qui documente un hébergement européen. Chez OpenAI, des offres éligibles comme ChatGPT Enterprise ou Education proposent le stockage du contenu en Europe, avec en option l’exécution (l’inférence) en région ; le stockage et le traitement sont deux choses distinctes, et la résidence ne couvre pas forcément chaque étape ni chaque intégration tierce.
La nationalité d’un fournisseur ne prouve rien à elle seule, et aucun plan n’est en soi « RGPD conforme » : vérifiez le produit, le plan, le contrat, les catégories de données, la région et les conditions de traitement, et prévoyez une évaluation propre à votre métier pour un usage réglementé.
Les pages à jour : modèles OpenAI, modèles Anthropic, modèles Google, modèles Mistral.
Exercice 1 : choisir le bon modèle pour une tâche
Objectif : décider par vous-même quel modèle mérite une tâche, au lieu de prendre le premier venu. Livrable : une grille de comparaison remplie et une règle personnelle.
Prérequis : une application d’IA qui vous laisse changer de modèle dans le sélecteur (un plan payant le permet en général ; le plan gratuit limite souvent le choix). Pas besoin de connaître les identifiants d’API : repérez dans le menu le modèle présenté comme le plus rapide et celui présenté comme le plus avancé.
Si votre application ne propose qu’un seul modèle, faites l’exercice sur ce modèle et notez que la comparaison n’était pas possible. Le fichier fourni email-client-exemple.txt, un e-mail client fictif à plusieurs demandes.
- Ouvrez une conversation et choisissez le modèle que votre application présente comme le plus rapide ou le plus économique (souvent un nom en « mini », « Flash », « Haiku » ou « Small » ; voir la première ligne du tableau pour les familles).
- Collez le prompt ci-dessous, puis le contenu de l’e-mail fictif.
- Notez la réponse.
- Ouvrez une nouvelle conversation, choisissez cette fois le modèle présenté comme le plus avancé ou « raisonnement » (souvent « Pro », « Opus », « Thinking » ou « Large » ; troisième ligne du tableau), collez le même prompt et le même e-mail.
- Comparez les deux réponses avec la grille donnée plus bas.
Prompt à copier :
Tu es assistant d'un professionnel. Voici un e-mail reçu d'un client.
Fais exactement trois choses, dans cet ordre :
1. Classe l'urgence en une ligne (faible, moyenne, élevée) et justifie en une phrase.
2. Liste toutes les demandes distinctes du client, sous forme de points.
3. Rédige un brouillon de réponse courte, poli, en vouvoyant, qui traite
   chaque demande et qui signale clairement ce que tu ne peux pas décider
   à ma place.
Ne promets aucune date ni aucun prix. Si une information me manque pour
répondre, dis-le au lieu d'inventer.

E-mail du client :
<< collez ici le contenu de email-client-exemple.txt >>
Résultat attendu. L’e-mail contient quatre demandes : garantir la date de livraison, une marge de négociation sur le prix, une facture au nom de la société mère, et une décision rapide. Un bon résultat les repère toutes les quatre, classe l’urgence en « élevée » à cause de l’échéance du 30, et écrit un brouillon qui ne s’engage ni sur une date ni sur un prix.
Sur une tâche aussi courte, un bon modèle rapide récent repère souvent déjà les quatre demandes et évite de s’engager. Comparez aussi les résultats sur un exemple fictif plus long ou comportant davantage de contraintes. La grille permet de mesurer les différences sur vos tâches.
Grille de contrôle, à remplir pour chaque modèle : les quatre demandes sont-elles listées, l’urgence est-elle justifiée, le brouillon évite-t-il toute promesse de date ou de prix, le ton est-il correct. Comptez un point par case.
Contrôle humain : relisez toujours la liste des demandes avant le brouillon. Si une demande manque dans la liste, le brouillon sera incomplet, quel que soit le modèle.
Erreur fréquente et correction : si les deux modèles se valent sur votre tâche, gardez le plus rapide, il coûte moins et répond plus vite. Le modèle de raisonnement ne se justifie que là où il fait une vraie différence. Votre règle personnelle sort de cet écart mesuré, pas d’une réputation.
Exercice 2 : tester une extraction et réconcilier les chiffres
Objectif : voir de vos yeux que l’IA lit vite mais se trompe parfois, et apprendre à recouper. Livrable : une fiche de contrôle qui rattrape une erreur de facture.
Prérequis : une application avec un modèle capable de lire un document. Le fichier fourni facture-fixture.txt, une facture fictive. Gardez de côté facture-fixture-valeurs-attendues.txt, qui contient les bonnes valeurs et l’erreur cachée. Ne le donnez pas à l’IA.
- Ouvrez une conversation avec un modèle équilibré ou de raisonnement.
- Collez le prompt ci-dessous, puis le contenu de la facture fictive.
- Lisez ce que l’IA renvoie.
- Recalculez vous-même le total à partir des lignes, ou demandez le calcul détaillé dans un second message.
- Comparez le total recalculé au total imprimé sur la facture.
Prompt à copier :
Tu extrais des données d'une facture. Rends uniquement un tableau avec, pour
chaque ligne : désignation, quantité, prix unitaire HT, total HT. Puis, en
dessous, indique le sous-total HT imprimé, la TVA imprimée et le total TTC
imprimé, exactement tels qu'ils figurent sur le document. Ne corrige rien et
n'ajoute aucun commentaire à cette étape.

Facture :
<< collez ici le contenu de facture-fixture.txt >>
Résultat attendu de l’extraction :
Chaise ergonomique "Démo"   3   149,00   447,00
Bureau réglable "Démo"      2   320,00   640,00
Lampe LED "Démo"            5    39,50   197,50
Sous-total HT imprimé : 1 284,50
TVA 21 % imprimée     :   269,75
Total TTC imprimé     : 1 545,25
Réconciliation. Additionnez les totaux de ligne : 447,00 + 640,00 + 197,50 = 1 284,50. La TVA à 21 % donne 269,75. Le total correct est donc 1 284,50 + 269,75 = 1 554,25. Or la facture imprime 1 545,25. Il manque 9,00, deux chiffres ont été inversés. Le fichier des valeurs attendues confirme cet écart.
Contrôle humain : le point clé de cet exercice est de comparer le chiffre lu par l’IA à un recalcul, pas à l’avis d’une autre IA. Une IA peut recopier fidèlement un total faux. Seul le recalcul, ou la comparaison à une source connue, prouve quelque chose.
Erreur fréquente et correction : si vous demandez d’emblée « vérifie cette facture », le modèle peut « corriger » le total en silence et vous ne verrez jamais l’erreur d’origine. Séparez toujours l’extraction du contrôle, en deux étapes, comme ici.
Ce que font vraiment les fonctions « agents »
Un assistant conversationnel écrit du texte puis s’arrête. Un agent reçoit une mission, planifie des étapes, utilise des outils, se corrige et va jusqu’à un livrable. Voici, sans promesse, ce que chaque produit permet aujourd’hui.
OpenAI. Le mode agent de ChatGPT mène des recherches en plusieurs étapes, pilote un navigateur pour consulter des sites, lit vos fichiers via des connecteurs (Gmail, Google Drive, GitHub, SharePoint) et peut planifier des tâches récurrentes.
Les Projects regroupent des consignes et des fichiers de référence pour un sujet. Prérequis : un plan payant, certaines fonctions réservées aux offres équipe. Les actions à impact demandent votre confirmation.
Anthropic. Claude propose des Projects pour isoler un contexte, des connecteurs et le protocole ouvert MCP pour relier Claude à d’autres logiciels (Notion, un CRM, un ERP), et Claude Code, un agent qui travaille dans le terminal des développeurs. Prérequis : un plan Pro ou Max ; un connecteur sur mesure demande une mise en place technique. Pour confier des tâches de bureau au mode agent de Claude, suivez le tutoriel Claude Cowork.
Google. Les Gems sont des assistants personnalisés avec des consignes enregistrées. Gemini est intégré à Gmail, Docs, Drive et Agenda dans Google Workspace. Workspace Studio construit des automatisations sans code, décrites en langage naturel, reliées à des applications comme Asana ou Salesforce. Prérequis : un plan Google adapté.
Mistral. Le Chat relie l’IA à vos logiciels par des connecteurs (des serveurs MCP enregistrés) et propose un mode de travail où l’agent prépare une action puis attend votre validation avant de l’exécuter, par exemple avant d’envoyer un message ou de modifier une donnée. L’entreprise est française. Prérequis : un compte Le Chat et des droits d’administration pour brancher vos outils.
Microsoft. Copilot trie la boîte Outlook, rédige des suivis et aide à gérer l’agenda dans Microsoft 365. Copilot Studio sert à construire des agents sur mesure. Prérequis : une licence Microsoft 365 et le module Copilot. Vérifiez ce qui est activé dans votre organisation.
Une mise au point utile. Les Projects et les Gems sont des dossiers de consignes réutilisables : ils gardent votre contexte et vos règles, mais un dossier de consignes ne se transforme pas seul en système multi-agents qui agit dans vos logiciels.
La mémoire, les tâches planifiées, la voix et les connecteurs existent déjà dans plusieurs outils grand public. Ce que les exercices de cette page n’activent pas, c’est l’accès à vos vraies données : tout reste sur des fichiers fictifs. La différence d’un service géré est ailleurs, dans des connexions et des permissions décidées avec vous, et une responsabilité claire sur le résultat.
Coordinateur et agents spécialisés
Pour un travail long qui touche plusieurs logiciels, une seule conversation peut se disperser. Une approche courante consiste à séparer les rôles : un coordinateur et des sous-agents. Une IA principale reçoit la demande, la découpe, confie chaque morceau à un agent spécialisé, puis rassemble le tout. Utile quand la tâche le justifie, pas systématiquement.
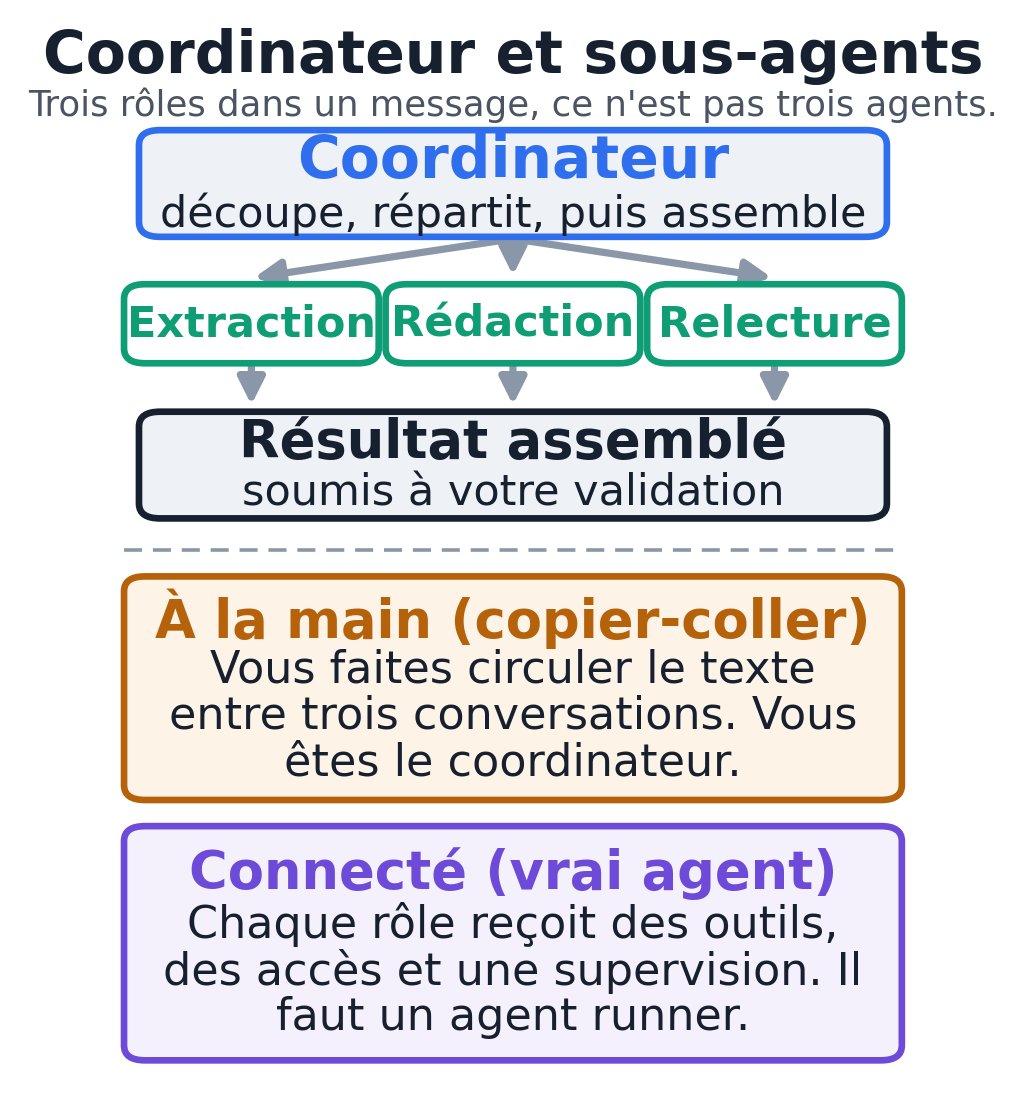
Une confusion à éviter absolument. Écrire dans un seul message « agis comme un extracteur, puis comme un rédacteur, puis comme un relecteur » ne crée pas trois agents indépendants : c’est une seule IA qui joue trois rôles à la suite.
Copier une réponse d’une fenêtre à une autre est aussi une délégation, mais c’est vous qui la faites à la main. Un dossier de Projet ou une Gem ne se transforment pas tout seuls en système multi-agents connecté. Un vrai enchaînement automatique demande un exécuteur d’automatisation, des accès aux logiciels et une implémentation.
Quand ce schéma vaut la peine : la tâche touche plusieurs logiciels, enchaîne plusieurs étapes, exige des recoupements, ou comporte un vrai risque d’erreur. Quand une seule IA suffit : la tâche est courte, autonome, sans donnée externe, comme corriger un texte ou proposer des titres.
Exercice 3 : un coordinateur, un spécialiste et un relecteur, à la main
Objectif : ressentir le schéma multi-agents sans aucun outillage, en étant vous-même le coordinateur. Livrable : une proposition commerciale d’une page, rédigée puis relue.
Prérequis : une seule application d’IA suffit. Le fichier fourni brief-mission-exemple.txt, le brief fictif d’un fleuriste qui veut refaire son site. Vous ouvrirez trois conversations séparées.
- Conversation « coordinateur ». Collez le prompt coordinateur et le brief. Vous obtenez les faits clients à respecter et un plan en points.
- Conversation « spécialiste ». Collez le prompt de rédaction, puis le brief et le plan produit à l’étape 1. Vous obtenez un brouillon.
- Conversation « relecteur ». Collez le prompt de relecture, puis le brief, le plan et le brouillon de l’étape 2. Vous obtenez une liste de corrections.
- Revenez dans la conversation coordinateur, collez le brouillon et les corrections, et demandez la version finale.
Prompt coordinateur :
Tu es le coordinateur d'une petite mission. Voici le brief d'un client.
Découpe le travail en un plan clair pour une proposition commerciale d'une
page. Donne trois choses : les faits clients à respecter (3 à 5 points tirés
du brief), les sections de la proposition en une ligne chacune, et les trois
questions à poser au client avant de s'engager. N'écris pas encore la
proposition.

Brief :
<< collez ici le contenu de brief-mission-exemple.txt >>
Prompt spécialiste rédaction :
Tu rédiges une proposition commerciale d'une page, ton simple et concret,
en vouvoyant, sans jargon. Reste fidèle au brief du client et suis exactement
le plan. N'invente aucun fait sur le client, aucun prix ni délai : laisse
« à convenir » là où il faut décider.

Brief du client :
<< collez ici le contenu de brief-mission-exemple.txt >>

Plan à suivre :
<< collez ici le plan produit par le coordinateur >>
Prompt relecteur :
Tu relis un texte avec un œil critique, sans le réécrire et sans inventer de
nouvelles sections. Compare le brouillon au brief et au plan ci-dessous.
Vérifie : faits du client oubliés ou inventés par rapport au brief, sections
manquantes par rapport au plan, promesses de prix ou de délai qui ne devraient
pas y être, phrases trop vagues, et ton trop commercial. Rends une liste de
corrections précises qui pointe chaque écart.

Brief du client :
<< collez ici le contenu de brief-mission-exemple.txt >>

Plan validé :
<< collez ici le plan produit par le coordinateur >>

Texte à relire :
<< collez ici le brouillon produit par le spécialiste >>
Résultat attendu : un plan qui liste les faits clients à respecter, cinq à sept sections et trois questions au client ; un brouillon qui suit ce plan, reste fidèle au brief et laisse les prix « à convenir » ; une liste de corrections concrètes qui pointe tout écart avec le brief. La version finale intègre les corrections.
Contrôle humain : c’est vous qui décidez quelles corrections retenir. Le relecteur propose, vous tranchez. C’est exactement le rôle qu’un exécuteur d’automatisation garderait sous votre validation dans une version connectée.
Passage à la version connectée. Pour que cet enchaînement tourne seul, il faudrait trois briques : un exécuteur d’automatisation qui appelle les rôles dans l’ordre, des connecteurs vers vos logiciels (le fichier client, votre modèle de proposition, votre messagerie), et une étape d’approbation avant tout envoi. C’est un projet à cadrer, avec des accès et une responsabilité définis, pas une case à cocher dans un chat grand public. Pour un premier essai sur une tâche simple, créer un agent IA sans coder construit le même agent avec Claude, ChatGPT et n8n.
Des consignes de projet réutilisables
Vous n’allez pas réécrire vos règles à chaque fois. Les Projects (chez OpenAI et Anthropic) et les Gems (chez Google) enregistrent des consignes permanentes pour un type de travail. Créez-en un par activité récurrente.
Écrivez-y qui vous êtes, votre ton, ce que l’IA doit toujours faire (vouvoyer, ne jamais promettre de date ni de prix, signaler ce qui manque) et ce qu’elle ne doit jamais faire. Ajoutez un ou deux documents de référence, comme un modèle vierge de proposition. Pas besoin de savoir programmer ni de construire quoi que ce soit de technique : un dossier de consignes et deux fichiers de référence suffisent.
Vérifier qu’une information est encore à jour
Les gammes changent tous les quelques mois et des pannes arrivent, y compris chez plusieurs fournisseurs le même jour. Ne vous fiez pas à un article daté, y compris celui-ci. Deux réflexes suffisent.
Pour les modèles et les capacités, ouvrez la page officielle du fournisseur (liens plus haut). Pour savoir si un service fonctionne en ce moment, consultez sa page de statut : status.openai.com, status.anthropic.com, status.cloud.google.com pour Google, et la page d’aide de Mistral. Pour les prix et les limites, seule la page de tarification affichée dans votre compte, dans votre pays, fait foi.
Votre prochaine session
- Choisissez une tâche que vous répétez et refaites l’exercice 1 dessus, avec un document d’exemple sans donnée sensible. Retirer les noms d’un vrai dossier ne suffit pas à l’anonymiser : pour des données réelles sensibles, il faut une évaluation et des autorisations propres à votre métier avant de les confier à une IA.
- Notez votre règle : quel modèle pour cette tâche, et pourquoi.
- Sur toute tâche qui touche des chiffres, gardez le réflexe de l’exercice 2 : extraire d’abord, contrôler ensuite, contre une source connue.
- Repérez une tâche longue qui touche plusieurs logiciels. Faites-la une fois à la main comme dans l’exercice 3 avant d’envisager de l’automatiser.
- Gardez une étape d’approbation sur tout envoi ou toute écriture, tant que vous n’avez pas confiance.
Pour commencer par une tâche concrète et savoir quel article suivre selon votre métier, partez du guide Utiliser l’IA dans votre métier. Les tutoriels par métier, par exemple pour la fiduciaire ou le cabinet de psychologue, reprennent la méthode de cette page sur des cas réels.
Quand un enchaînement mérite de tourner seul, avec vos logiciels et une étape d’approbation, c’est un projet à cadrer. C’est le travail de MACCUS : construire avec vous un assistant configuré, aux connexions et permissions décidées ensemble, et voir ce qui est réaliste pour votre activité.