Le 19 octobre 2026, OpenAI a annoncé que 86,6 % des réécritures de programmes COBOL produites par son nouveau modèle de milieu de gamme, GPT-6.1 Sol, passent tous les tests cachés de son évaluation, contre 5,4 % pour GPT-5.6 Sol, de la génération précédente, au même réglage de raisonnement faible. Le COBOL est le langage des années 1960 qui, selon IBM, traite encore la plupart des opérations aux distributeurs de billets, et l’épreuve demande de réécrire des programmes COBOL dans des langages modernes. Avec plus de temps de raisonnement, GPT-6.1 Sol atteint 97,9 %, ce qui amène l’épreuve « près de la saturation », selon la publication d’OpenAI.
Ces résultats viennent d’une évaluation conçue par OpenAI et non publiée, mais le modèle, lui, est disponible. GPT-6.1 Sol a été lancé lors du DevDay d’OpenAI le 29 septembre et s’utilise via l’API sous le nom gpt-6.1-sol, à 2 dollars le million de jetons en entrée et 10 dollars en sortie (environ 1,78 et 8,91 euros au cours BCE du 19 octobre), soit un cinquième des tarifs de GPT-6 Astra. Notre guide des modèles GPT d’OpenAI détaille ce qui distingue Astra, Sol et Luna. D’après OpenAI, le nouveau modèle a passé l’épreuve COBOL pour 61 % du coût d’API de GPT-5.6 Sol au même réglage.
Le code des paiements par carte
Le COBOL a été conçu par le CODASYL, un consortium d’administrations et d’entreprises américaines formé en 1959, et sa première version date de 1960. Selon IBM, il reste la base de plus de 40 % des systèmes de banque en ligne et traite 80 % des paiements par carte en magasin et 95 % des transactions aux distributeurs automatiques. Ces estimations circulent depuis des années, et OpenAI les reprend en renvoyant vers IBM.
Dans sa publication du 23 février, Anthropic écrivait que « des centaines de milliards de lignes de COBOL tournent en production chaque jour » et que les développeurs qui ont bâti ces systèmes sont partis à la retraite « il y a des années ». Le COBOL n’est plus enseigné que dans « une poignée d’universités », ajoutait l’entreprise, et trouver des ingénieurs capables de le lire devient « plus difficile chaque trimestre ». Avec l’IA, selon elle, les équipes pouvaient moderniser ces systèmes en quelques trimestres au lieu de plusieurs années.
IBM, qui vend les mainframes sur lesquels tourne une bonne partie de ce code, a vu son action clôturer en baisse de près de 13,2 % le jour même, selon CNBC. D’après Reuters, c’était la plus forte chute du titre sur une séance depuis octobre 2000.
Une migration jugée à l’octet près
L’épreuve d’OpenAI demande à un modèle de migrer des programmes COBOL vers C++, Java, Kotlin, Python ou Rust sans changer leur comportement. Des tests cachés comparent ensuite les sorties observables du nouveau programme aux sorties attendues, octet par octet, et une migration ne compte comme réussie que si tous les tests passent.
Ce niveau d’exigence vise les échecs typiques des réécritures COBOL. Les programmes qui manipulent de l’argent reposent sur des détails comme les règles d’arrondi ou le traitement des enregistrements manquants. OpenAI cite un exemple : l’arithmétique à virgule fixe du COBOL tronque les décimales en trop, sauf si le code demande explicitement un arrondi. Une réécriture qui arrondit ces valeurs « peut tourner sans erreur tout en produisant des résultats financiers différents ».
Un graphique de la publication d’OpenAI donne les scores à cinq niveaux de raisonnement, du plus faible au maximum. Au maximum, GPT-5.6 Sol atteignait 65,2 % et GPT-6.1 Sol 97,9 % : l’écart se resserre quand les deux modèles raisonnent plus longtemps. À effort faible, GPT-6.1 Sol dépasse pourtant GPT-5.6 Sol à effort maximal, pour environ un septième du coût par essai évalué (0,31 dollar contre 2,06, soit environ 0,28 et 1,84 euro).
L’essentiel de ce bond à effort faible revient à GPT-6.1 Sol lui-même. GPT-6 Sol, sorti une semaine plus tôt, le 22 septembre, obtenait 20,8 % à effort faible et 95,8 % à effort maximal sur la même épreuve.
Des agents qui échouaient sans s’en rendre compte
En avril, Factory, éditeur d’outils de programmation par IA, a publié Legacy-Bench, une série de tâches de maintenance en COBOL, Fortran, Java 7 et d’autres langages anciens. Sur les 12 combinaisons de modèles et d’agents testées, les taux de réussite globaux allaient de 16,9 % à 42,5 %. Parmi les 44 tâches qu’aucun modèle n’a résolues, 31 étaient en COBOL, et Factory notait que la migration du COBOL vers Java, Rust ou C++ « fonctionne rarement ».
Ces échecs passaient aussi inaperçus. Selon Factory, les bugs COBOL ne font pas de bruit : dans une tâche de paie, un agent calculait une retenue santé de 275 dollars au lieu de 125, les totaux devenaient faux, et 24 tests sur 29 passaient malgré tout. « Dans 97 % des échecs, l’agent croit avoir résolu la tâche », écrivait l’entreprise.
Les deux séries de chiffres viennent de tests et de modèles différents (le meilleur modèle d’avril chez Factory était GPT-5.3-Codex) et ne se comparent donc pas point par point. Elles décrivent toutefois le même piège, un code qui compile et tourne mais donne de faux résultats, et c’est ce piège que vise l’exigence octet par octet d’OpenAI.
Un moteur de base de données en 20 langages
La seconde épreuve d’OpenAI, MultiLangBench, est publiée sur GitHub sous licence Apache 2.0. Elle demande à un modèle d’écrire, dans un langage imposé, un moteur de base de données compatible avec SQLite 3.40.1, à partir de la seule documentation de SQLite, sans accès à Internet et sans aucune copie de SQLite dans son environnement. Une solution écrite dans un autre langage obtient zéro. Les tests viennent de la suite de SQLite elle-même : 24 000 des 51 000 tests ont pu être convertis, et le dépôt demande d’utiliser un sous-ensemble de 272 tests.
À effort de raisonnement maximal, GPT-6 Astra, le modèle le plus puissant d’OpenAI, passe en moyenne 87,4 % des tests sur 20 langages, contre 26,8 % pour GPT-5.6 Sol, et dépasse 83 % dans 19 langages sur 20. Le COBOL reste le plus difficile, à 72,1 % (10,9 % pour GPT-5.6 Sol). Le Fortran passe de 21,4 % à 83,5 %, Visual Basic de 27,5 % à 89,4 % et OCaml de 25,6 % à 85,8 %. Moins cher, GPT-6 Luna atteint 40,3 % pour un coût estimé de 0,77 dollar par tentative (environ 0,69 euro), contre 3,48 dollars (environ 3,10 euros) pour GPT-5.6 Sol.
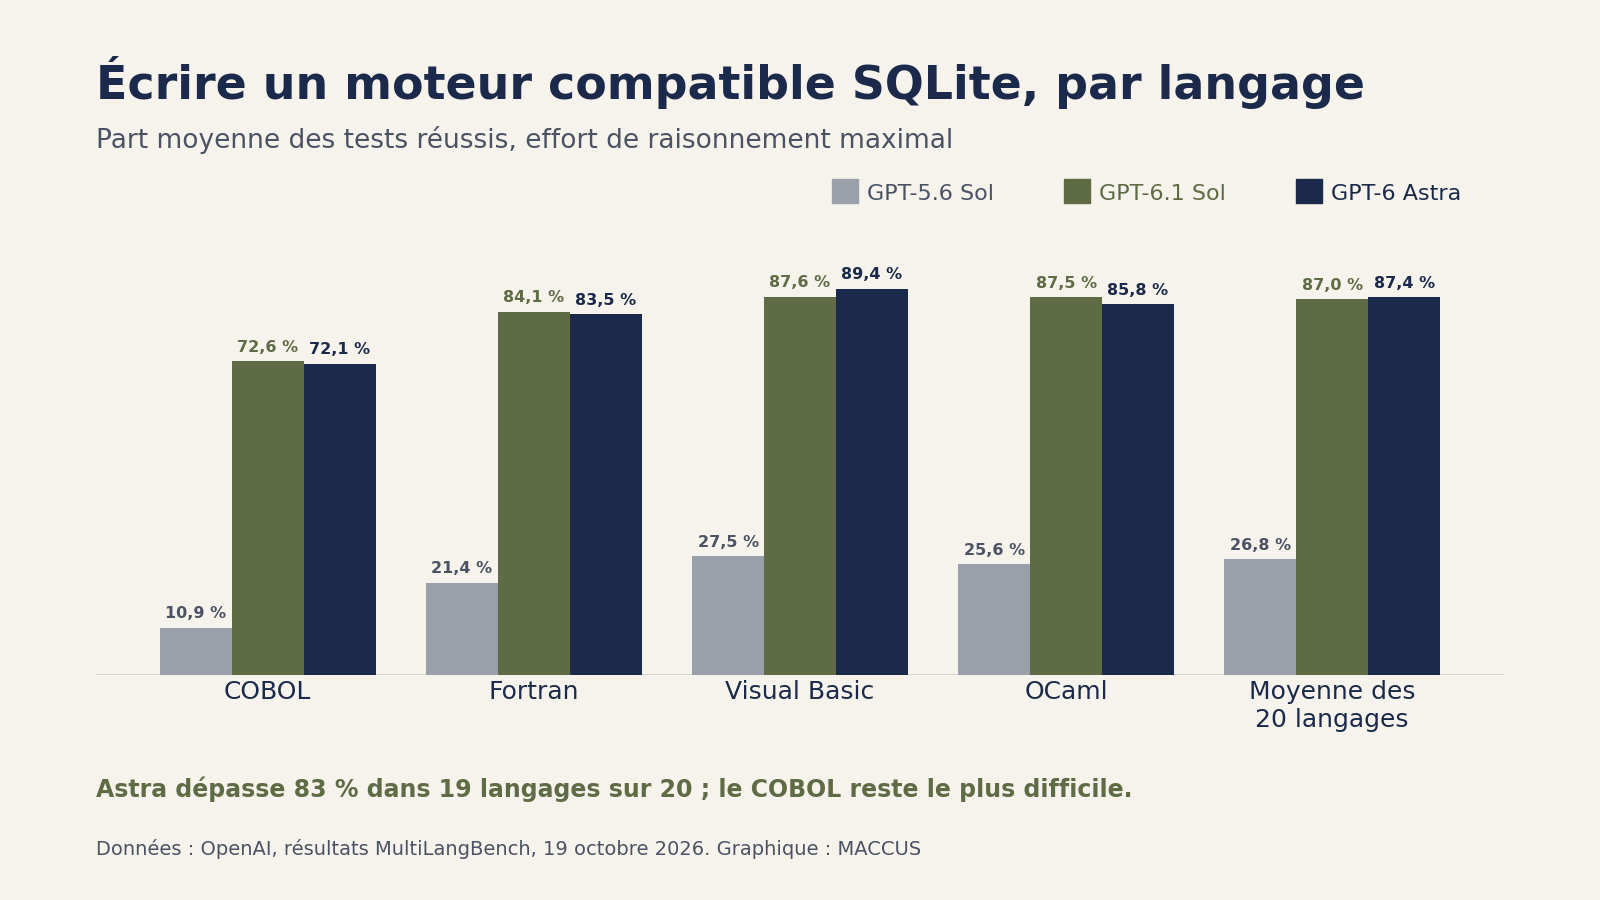
Le texte d’OpenAI compare son modèle haut de gamme à un ancien modèle de milieu de gamme, mais un graphique de la même publication place GPT-6.1 Sol, lui aussi de milieu de gamme, juste derrière Astra, à 87,0 % de moyenne. Des logiciels entiers écrits surtout par l’IA sortent déjà des laboratoires : le 8 octobre, une équipe open source a publié une alternative gratuite à Word, Excel et PowerPoint écrite en grande partie avec Claude.
Les limites des tests d’OpenAI
Les scores COBOL et MultiLangBench viennent d’OpenAI et de ses propres tests. L’épreuve COBOL reste privée : OpenAI n’a pas indiqué combien de programmes elle contient, leur longueur ou le type de règles métier qu’ils couvrent, et personne hors de l’entreprise ne peut la refaire. Passer tous les tests cachés garantit des sorties identiques sur les cas couverts par ces tests, mais ne dit rien des autres.
L’entreprise n’explique pas comment elle a entraîné ses modèles sur ces langages. Elle indique seulement que ce travail a été guidé par des retours de développeurs et d’entreprises clientes, selon lesquels les modèles de programmation « peinent souvent » sur ces langages. Pour les logiciels en production, OpenAI précise que l’application de ces capacités « exige toujours une revue par des experts et des tests au regard des règles métier et des dépendances du système ». Le site japonais TechnoEdge, qui a consacré un article à l’annonce le 20 octobre, fait la même remarque : aucun système de production ne tourne à 86,6 % ou 97,9 %, et l’intervention humaine reste nécessaire.
Notre analyse
Il y a six mois, dans les tests de Factory, les meilleurs agents de programmation échouaient sur la plupart des tâches COBOL et, en cas d’échec, croyaient presque toujours avoir réussi. Sur l’épreuve d’OpenAI, un modèle public de milieu de gamme réécrit désormais des programmes COBOL avec des sorties identiques près de neuf fois sur dix à son réglage le moins cher, mieux que la génération précédente à son réglage le plus coûteux. Banques, assureurs et administrations repoussent depuis longtemps la réécriture de ces systèmes, en partie parce que comprendre ce vieux code coûtait plus cher que le réécrire, comme l’écrivait Anthropic en février.
Le goulot d’étranglement se déplace vers la vérification. Le résultat d’OpenAI repose sur des tests cachés qui fixent ce que fait chaque ancien programme, et une vraie migration exige le même type de tests à bien plus grande échelle, écrits par des gens qui connaissent les règles métier. Un autre domaine où le résultat se compare à un original a déjà connu ce basculement : des passionnés qui ont passé des années à reconstituer le code source de jeux vidéo ont vu l’IA accélérer ce travail au point que leur site de suivi ferme.
Les prochaines preuves viendront de l’extérieur d’OpenAI. Comme MultiLangBench est accessible à tous, des scores indépendants devraient suivre. L’épreuve de migration COBOL reste privée, et Factory n’a pas publié de résultats Legacy-Bench pour cette génération de modèles. Une banque ou une administration qui publierait les résultats d’une migration menée ainsi apporterait les premières données issues de la production.
Sources
- Advancing coding in low-resource programming languages, OpenAI, 19 octobre 2026
- openai/MultiLangBench, OpenAI sur GitHub, 19 octobre 2026
- Introducing GPT-6.1 Sol, OpenAI, 29 septembre 2026
- Legacy-Bench: Can AI Agents Maintain the World’s Most Critical Software?, Factory, 1er avril 2026
- COBOL Modernization with AI: Breaking the Cost Barrier, Anthropic, 23 février 2026
- What Is COBOL?, IBM, 8 mai 2025
- IBM is the latest AI casualty. Shares tank 13% on Anthropic programming language threat, CNBC, 23 février 2026
- COBOLやVBなど旧式言語でGPT-6急伸、正解率5%から最大98%とOpenAI発表, TechnoEdge, 20 octobre 2026
Image d’en-tête : graphique MACCUS, données OpenAI (19 octobre 2026)