Emre Onur Kahya, aujourd’hui physicien à l’Université technique d’Istanbul, a consacré un an de sa thèse et environ 500 pages manuscrites à un seul calcul de gravité quantique, selon son propre décompte. Le 16 octobre 2026, il a publié une re-dérivation pas à pas de ce travail, menée avec Claude Opus 5.5 en une dizaine d’heures de calcul réparties sur trois jours. Elle montre que le résultat paru en 2007 dans Physical Review D a le signe global inversé et que deux entrées de son tableau final sont fausses, mais que la conclusion physique tient.
Une confession sur X
Kahya avait mené le calcul d’origine avec Richard Woodard pendant son doctorat à l’université de Floride. Le premier article, déposé sur arXiv le 4 septembre 2007, est paru dans Physical Review D 76, 124005, et le second en 2008 dans Physical Review D 77, 084012.
Le 18 octobre, il a résumé l’audit dans un message en turc : « Confession d’un physicien : le calcul de gravité quantique qui m’a pris un an de thèse et environ 500 pages à la main, Opus 5.5 l’a fait en 10 heures, article et dépôt GitHub compris. Il a même trouvé les erreurs. Heureusement, le résultat n’a pas changé. Que voudra dire le mot “labeur” dans le monde universitaire désormais ? » (notre traduction). Le 20 octobre, le message dépassait 540 000 vues et 4 000 mentions « J’aime ».
La question posée par le calcul
Pendant l’inflation, la phase d’expansion fulgurante des premiers instants de l’univers, l’espace se remplit d’une mer toujours plus dense de gravitons de grande longueur d’onde. Les deux articles se demandaient si cette mer modifie le comportement d’un champ scalaire sans masse, substitut du champ responsable de l’inflation, une fois ses ondes étirées au-delà de l’horizon.
Le premier article calculait la correction à une boucle due aux gravitons, ce que les physiciens appellent l’auto-masse au carré du scalaire. Le second l’injectait dans l’équation du champ et concluait, ce que confirme la reprise de 2026, qu’aux temps tardifs le champ ne reçoit aucune correction notable : rien n’y croît avec l’expansion.
Un signe inversé et deux entrées fausses
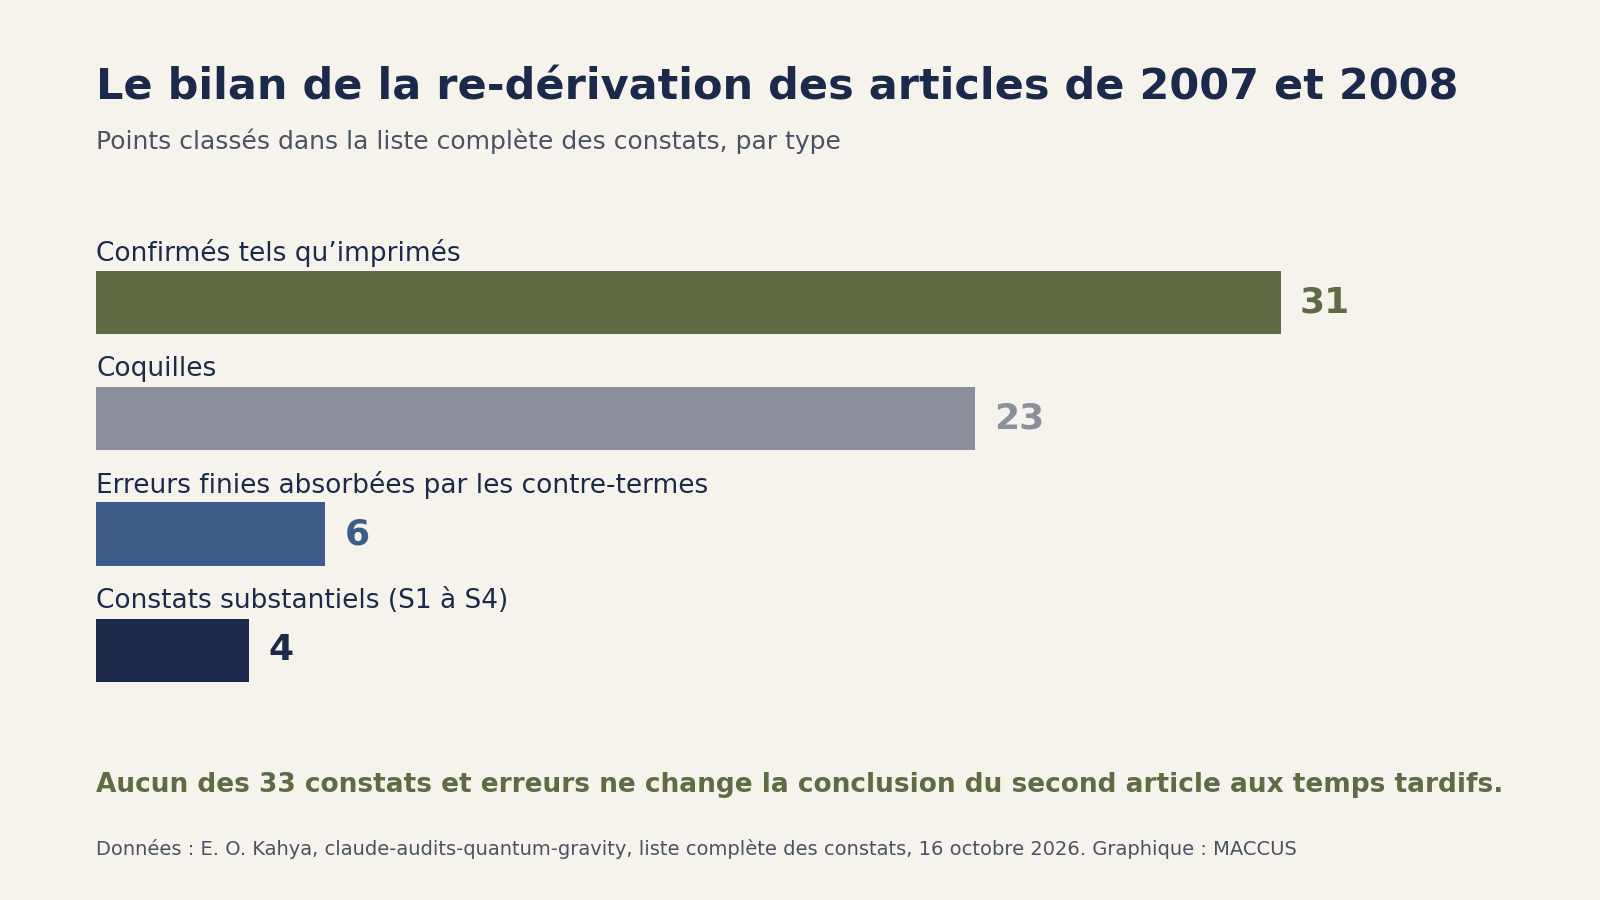
L’audit classe chaque écart relevé par rapport aux articles publiés. Quatre constats sont jugés substantiels.
| Constat | Écart relevé par l’audit | Effet sur la conclusion |
|---|---|---|
| S1 | L’auto-masse au carré publiée est l’opposée de celle que donne la définition du premier article | N’inverse que des termes qui s’éteignent aux temps tardifs |
| S2 | Une ligne du tableau X final omet un terme logarithmique | N’ajoute que des termes qui s’éteignent |
| S3 | Une constante d’une autre ligne doit valoir +18, et non -54 | Disparaît du calcul aux temps tardifs |
| S4 | L’argument qui justifiait un raccourci dans le second article ne tient pas terme à terme | Le calcul complet donne le même résultat |
La liste complète des constats y ajoute six erreurs finies, absorbées par les contre-termes et sans effet physique, et 23 coquilles. Elle recense aussi 31 points conformes à la version publiée, et les tableaux 2 à 4 du second article reproduits à l’identique.
Le dépôt fait remonter l’erreur de signe à deux sources : une règle de dérivation dans l’équation (I.32) et le passage de (I.46) à (I.47). Les deux diagrammes concernés étaient inversés, si bien que leur signe relatif restait cohérent, tout comme une compensation que l’article vérifie entre eux.
Un protocole conçu contre la copie
Pour éviter que le modèle ne recopie la réponse publiée, chaque tâche ne prenait en entrée que les résultats des tâches précédentes et les définitions posées dans les articles. L’équation publiée à vérifier « n’a pas servi d’entrée » et n’a été comparée « qu’une fois la dérivation terminée », précise le README, qui énumère les quelques exceptions.
Chaque résultat analytique a ensuite été contrôlé, quand c’était possible, par un code SymPy et mpmath distinct : identités symboliques exactes, ou tests numériques en des points tirés au hasard, avec 20 à 30 chiffres significatifs. Les deux corrections du tableau X sont issues d’un test global, où le tableau ne concorde à 30 chiffres avec la somme directe des contributions séparées que si l’on applique S2 et S3 ensemble. Selon le README, les 38 exécutions de code du dépôt réussissent toutes en une dizaine de minutes sur un Mac à puce Apple.
L’ampleur du chantier
Les deux articles ont été découpés en 18 tâches regroupées en neuf étapes, dans l’ordre des équations. Il en est sorti 183 pages de notes de calcul, à distinguer des 500 pages manuscrites du travail d’origine.
Les remerciements de l’article attribuent à Claude Opus 5.5 la reprise pas à pas des calculs et les vérifications symboliques et numériques présentées, ainsi que la préparation des notes et du dépôt. L’ensemble, rédaction du manuscrit comprise, a consommé environ 2,7 millions de jetons de sortie et quelque 800 millions traités au total, pour l’essentiel des relectures en cache du contexte de travail. Le tout a pris environ 10 heures de calcul actif, les 5, 15 et 16 octobre 2026.
Le 19 octobre, Kahya a donné un conseil pratique : demander explicitement au modèle de travailler séquentiellement. Sinon, écrit-il, celui-ci découpe le travail en dizaines de morceaux confiés à des agents travaillant en parallèle, et une erreur peut se propager. « On aura vraiment l’impression de former un doctorant », ajoute-t-il.
Le même constat sur les benchmarks
Le 11 septembre, une équipe emmenée par Yale a fait recorriger par des experts les copies de modèles de pointe sur des benchmarks de physique. Sur 250 cas audités dans quatre sous-ensembles, les experts n’imputent que 12 erreurs au modèle ; les 238 autres tiennent à des défauts des questions ou des correcteurs. Selon les auteurs, leurs résultats suggèrent que le taux d’erreur réel des modèles de pointe est désormais « bien inférieur au taux de défauts des benchmarks disponibles ».
Le 9 octobre, les auteurs de TheoPhysEval, présenté dans notre article du 17 octobre sur l’IA et la physique, ont écrit avoir d’abord jugé que GPT-6 Astra se trompait sur plusieurs problèmes, avant de trouver des erreurs subtiles dans les solutions d’origine rédigées par leurs experts.
Dans les deux cas, les erreurs se trouvaient dans les benchmarks eux-mêmes ; chez Kahya, dans un article à comité de lecture. L’affaire suit aussi les 36 manuscrits rédigés avec Claude en trois mois par un physicien de Harvard et le Vals Science Index du 16 octobre, qui note les modèles sur des tâches de recherche écrites par des scientifiques.
Une proposition et une inquiétude
Le 19 octobre, Kahya a interpellé Anthropic et OpenAI en leur suggérant de collaborer avec les grandes revues scientifiques, voire d’en créer une, pour que les calculs de chaque article soumis soient vérifiés automatiquement. « Tellement utile pour le monde universitaire », écrit-il.
À un internaute qui lui demandait s’il confierait plutôt ces calculs à des doctorants, il a répondu qu’il faudrait d’abord leur enseigner les méthodes techniques, ce que beaucoup ne feraient pas, au risque d’un « effet néfaste sur l’apprentissage du métier de chercheur ». Carlo Iacono, auteur de la newsletter Hybrid Horizons, a exprimé la même inquiétude le 19 octobre : « Les dix heures ont produit un calcul corrigé, et personne de nouveau. »
Les limites reconnues par le dépôt
Le dépôt énumère lui-même ses limites et les points qu’un expert humain doit encore examiner, à commencer par les deux sources du signe. Les rapports de travail ont été rédigés en turc ; les notes en anglais en sont des traductions faites avec Claude, comparées au turc lors d’une relecture distincte par Claude. L’annexe du premier article consacrée à l’extraction des dérivées a été auditée, non refaite : des exemples ont été vérifiés à la main et ses totaux testés numériquement. Un rapport de travail en turc affirmait que chaque ligne avait été reproduite à la main ; les notes corrigent cette exagération.
Les tests globaux sont numériques, sur deux ou trois paires de points tirées au hasard, et ne valent pas preuve symbolique. La compensation aux temps tardifs est exacte jusqu’à l’ordre k puissance 10, sans démonstration à tous les ordres. Un éventuel terme local supplémentaire n’est que partiellement exclu.
La physique elle-même était déjà connue, et l’audit confirme un résultat de 2008. Le nouvel article porte la mention « soumis à arXiv ». Il n’y figurait pas le 20 octobre, et aucune revue ne l’a publié. Woodard est remercié pour la collaboration d’origine, mais rien dans le dépôt n’indique qu’il ait relu l’audit.
Notre analyse
L’affaire montre ce que coûte désormais la reprise d’un long calcul publié. En 2007, le travail d’origine a demandé un an à un doctorant, selon son récit, et les relecteurs de Physical Review D n’ont pas vu l’inversion du signe global. En octobre 2026, la re-dérivation qui l’a détectée a pris une dizaine d’heures de calcul et 2,7 millions de jetons de sortie, avec des vérifications que chacun peut relancer.
L’idée de Kahya, pour l’instant une simple suggestion sur X, repose sur ce coût. Si revérifier un calcul ne demande plus que quelques heures de machine, vérifier tous les calculs soumis devient une question de budget, et de savoir qui pilote le processus.
À ce stade, on ne dispose que d’un seul calcul, borné et à la réponse connue, audité par l’un de ses propres auteurs, qui connaissait la physique, et découpé en tâches ordonnées. Ce cas ne montre pas si la méthode tient quand la personne qui mène l’audit n’a pas écrit le calcul et ne sait pas où chercher.
Restent à suivre la mise en ligne de l’article sur arXiv, la reprise des 38 vérifications par d’autres physiciens, qui confirmeraient ou non S1 à S3, et l’éventuelle adoption de la vérification automatique par une revue ou un laboratoire.
Sources
- claude-audits-quantum-gravity, E. O. Kahya sur GitHub, 16 octobre 2026
- Auditing a quantum gravity calculation with an AI model: corrected scalar self-mass and unchanged late-time mode functions during inflation, E. O. Kahya, soumis à arXiv, 16 octobre 2026
- Bir fizikçi itirafı, Emre Onur Kahya sur X, 18 octobre 2026
- Not sure if it would make sense for @AnthropicAI, Emre Onur Kahya sur X, 19 octobre 2026
- Quantum Gravity Corrections to the One Loop Scalar Self-Mass during Inflation, E. O. Kahya et R. P. Woodard, arXiv, 4 septembre 2007
- How Good Are Frontier Models at Physics? Expert Re-Grading Reveals Broken Evaluations and Near-Saturation of Leading Benchmarks, arXiv, 11 septembre 2026
- TheoPhysEval: Assessing AI agents at autonomous theoretical physics problem solving, arXiv, 9 octobre 2026
- When the Work Stops Making the Worker, Carlo Iacono, Hybrid Horizons, 19 octobre 2026
Image d’en-tête : graphique MACCUS, données E. O. Kahya sur X (18 octobre 2026) et remerciements de l’article (16 octobre 2026)