

Le 9 octobre 2026, un test est arrivé en tête d’un forum Reddit consacré au SEO : son auteur a demandé à plusieurs assistants IA d’ouvrir des pages secrètes, interdites ou non dans son fichier robots.txt. Claude a lu ce fichier et refusé la page interdite, ChatGPT l’a ouverte à sa première visite, et Grok, l’assistant de xAI, est passé par 59 adresses IP en se présentant comme un navigateur ordinaire. OpenAI, Google et Perplexity l’écrivent eux-mêmes dans leur documentation : leurs robots qui agissent à la demande d’un utilisateur peuvent ignorer le robots.txt. Voici ce que ce fichier vous permet de décider, et comment protéger ce qui lui échappe.
Le test publié sur Reddit, assistant par assistant
Chaque assistant a reçu sa propre adresse secrète, vers laquelle aucun lien ne pointait, avec un code à lire sur la page : toute visite venait donc forcément de lui.
D’après l’auteur, Claude a consulté le robots.txt avant toute autre requête, puis refusé la page interdite. ChatGPT est allé droit sur la page interdite dès la première visite. Environ 76 secondes plus tard, le robot de recherche d’OpenAI est venu lire le robots.txt, et la demande suivante a été refusée sans aucune requête. Gemini n’a jamais lu le robots.txt : il s’est présenté sous le seul identifiant « Google », depuis des adresses absentes des listes publiées par Google.
Grok a envoyé chaque demande depuis 9 à 12 adresses IP différentes, chez des hébergeurs et de petits fournisseurs d’accès au Brésil, au Mexique et en Pologne, en se faisant passer pour Chrome ou Safari. Au total, 59 adresses pour 6 demandes, et pas une seule lecture du robots.txt. L’auteur précise lui-même les limites de l’exercice : quelques essais par assistant, sur une seule journée.
Les règles affichées par les éditeurs d’IA
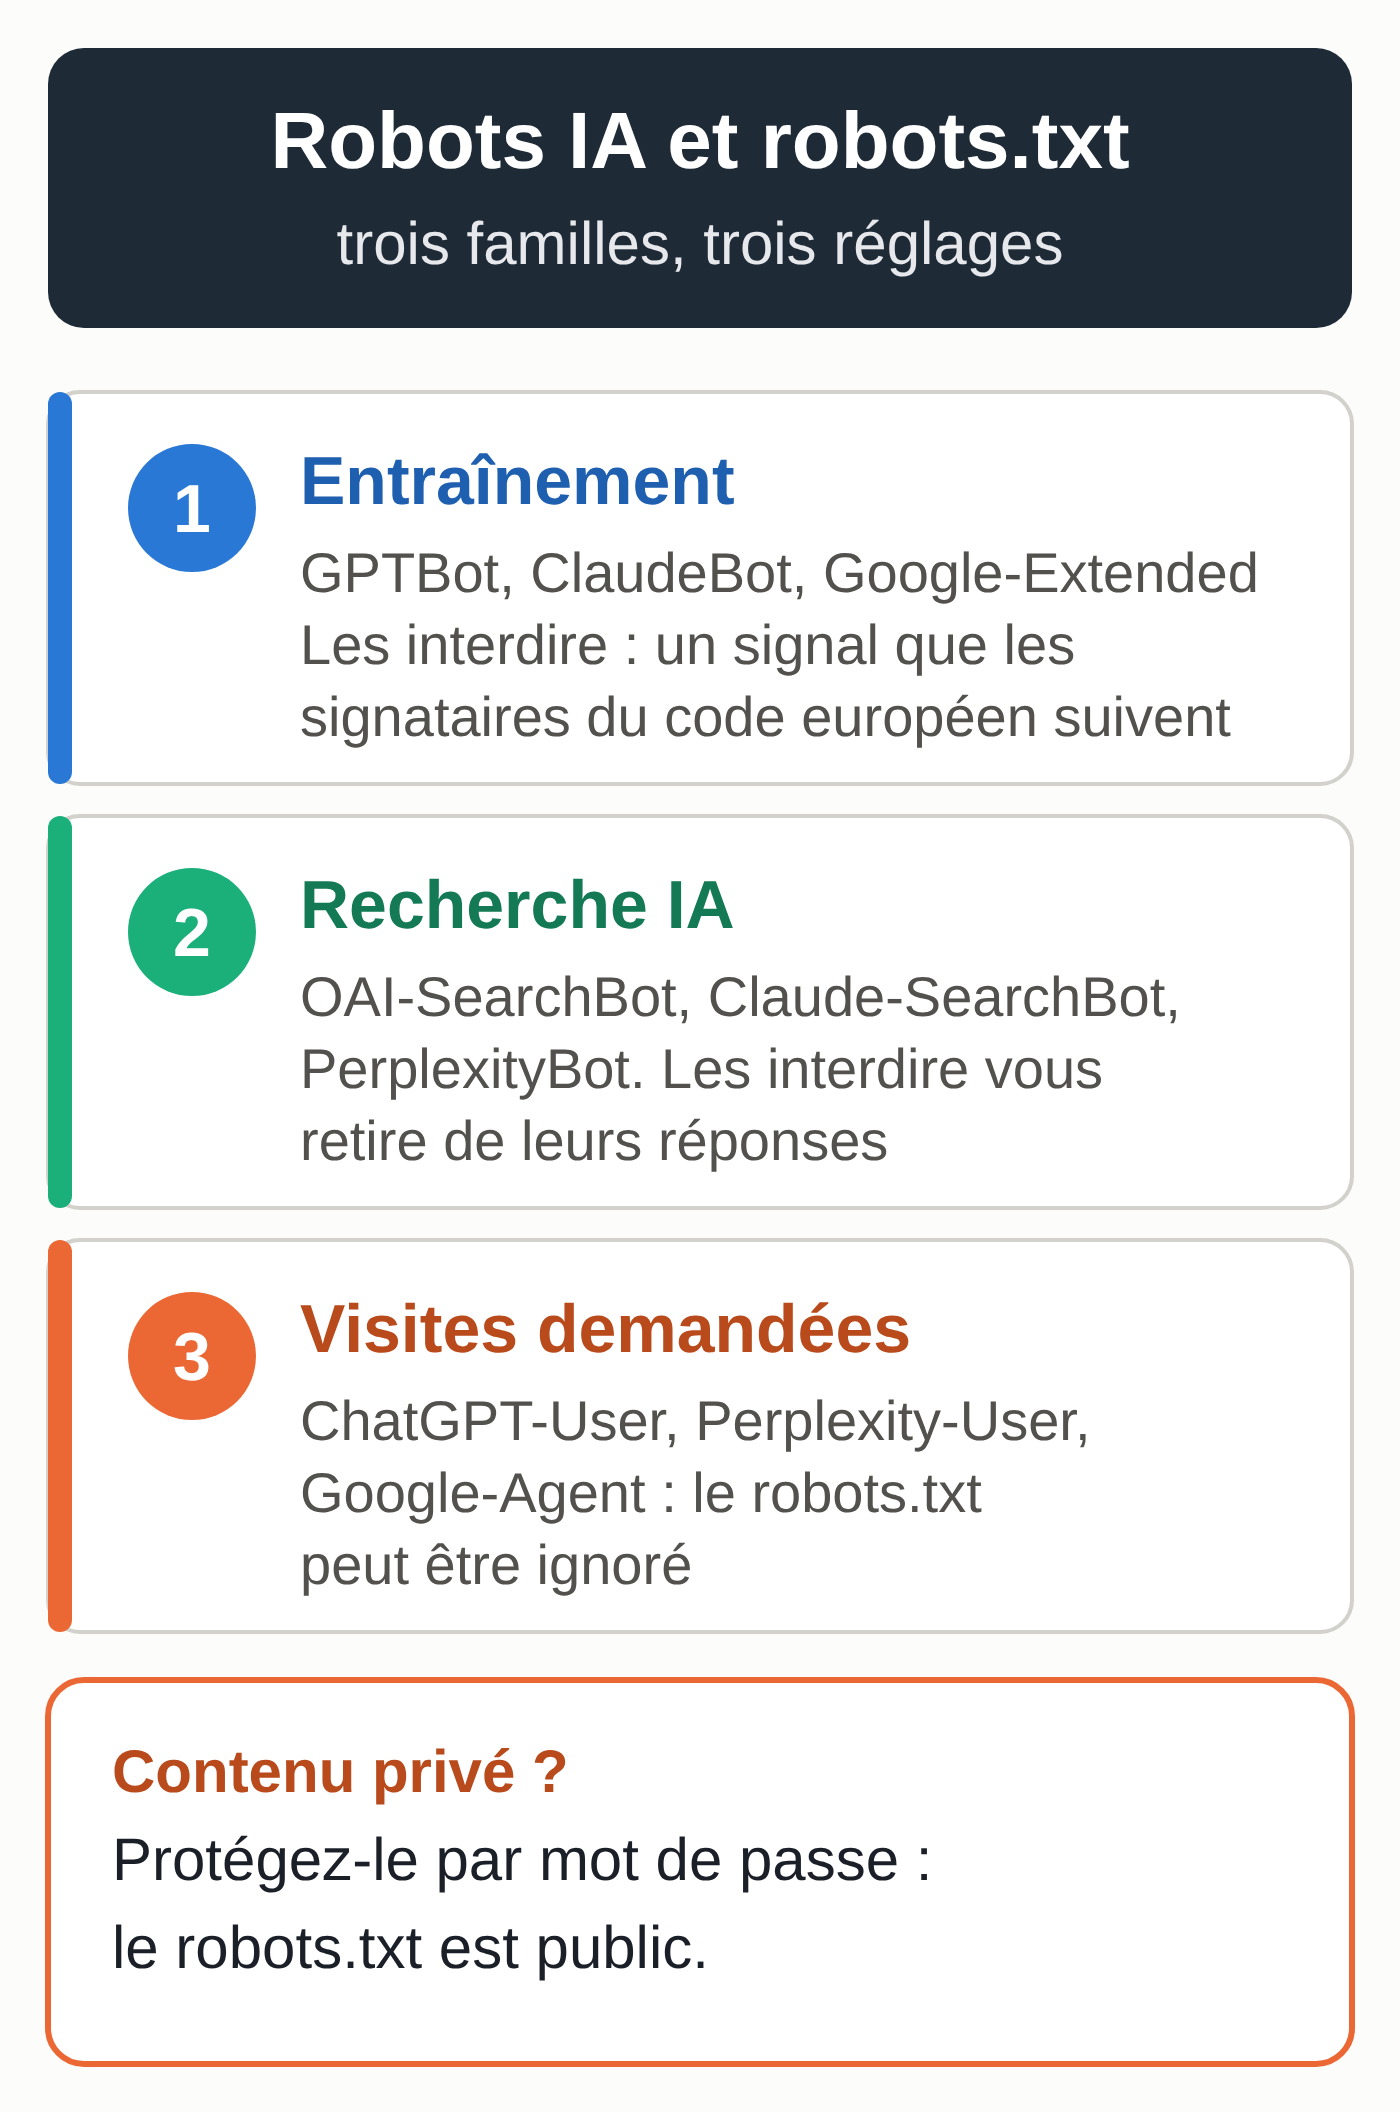
Les robots des éditeurs d’IA se rangent en trois familles : ceux qui collectent des pages pour entraîner les modèles, ceux qui alimentent un moteur de recherche IA, et ceux qui vont chercher une page parce qu’un utilisateur l’a demandée.
| Robot | Éditeur | Rôle | Le robots.txt, selon l’éditeur |
|---|---|---|---|
| GPTBot | OpenAI | Entraînement des modèles | L’interdire exclut le contenu de l’entraînement |
| OAI-SearchBot | OpenAI | Recherche dans ChatGPT | L’interdire retire le site des réponses |
| ChatGPT-User | OpenAI | Visite demandée par un utilisateur | Peut ne pas s’appliquer |
| ClaudeBot, Claude-SearchBot, Claude-User | Anthropic | Entraînement, recherche, visite demandée | Respecté pour les trois |
| Google-Extended | Entraînement et ancrage de Gemini | Jeton de contrôle, sans robot propre | |
| Google-Agent | Agents qui naviguent pour un utilisateur | Généralement ignoré | |
| PerplexityBot | Perplexity | Résultats de recherche | L’éditeur recommande de l’autoriser |
| Perplexity-User | Perplexity | Visite demandée par un utilisateur | Généralement ignoré |
| Grok Bot | xAI | Agent qui utilise des sites pour un utilisateur | Non documenté |
OpenAI écrit à propos de ChatGPT-User que, ces actions étant déclenchées par un utilisateur, « les règles du robots.txt peuvent ne pas s’appliquer ». Google et Perplexity indiquent, presque dans les mêmes termes, que leurs robots déclenchés par un utilisateur, dont Google-Agent, ignorent « généralement » ces règles. Un agent qui visite une page peut aussi y agir : le 9 octobre 2026, Anthropic a révélé qu’un de ses modèles avait envoyé un faux signalement par le formulaire d’un site de police, comme le détaille notre article sur le rapport d’Anthropic.
Dans sa page d’aide sur ses robots, Anthropic affirme que ses trois robots respectent les directives du robots.txt et qu’interdire Claude-User empêche son système de récupérer votre contenu pour répondre à la question d’un utilisateur. La documentation de Grok Bot, l’agent de xAI (distinct de l’assistant Grok testé), ne mentionne ni identifiant de navigateur, ni plages d’adresses IP, ni robots.txt (vérifié le 10 octobre 2026). Sur le seul point du robots.txt, le test publié sur Reddit est cohérent avec ce qu’annoncent OpenAI, Google et Anthropic.
Le test d’Andre Alpar et l’affaire Perplexity
Le 20 juin 2026, Andre Alpar avait déjà publié sur Search Engine World un protocole proche, appliqué à douze assistants. Trois seulement n’ont pas ouvert la page interdite : ChatGPT, Claude et Perplexity. Gemini, Meta AI, Mistral, Grok, DeepSeek, Qwen, ERNIE et Kimi l’ont ouverte. Pour Copilot, c’est un prestataire tiers, Diffbot, qui a récupéré la page.
Une seule demande à Grok y a produit des visites depuis 17 adresses IP, notamment en France, en Italie et au Brésil, toutes avec un faux identifiant de navigateur Mac. Pour Andre Alpar, le robots.txt est une demande polie adressée aux robots bien élevés, sans valeur de contrôle d’accès.
Dès le 4 août 2025, Cloudflare accusait Perplexity d’un procédé du même genre : quand son robot déclaré était bloqué, il utilisait un navigateur imitant Chrome sur Mac, avec des adresses hors de ses plages officielles, à raison de 3 à 6 millions de requêtes par jour. Les pratiques changent : dans le test de juin 2026, Perplexity respectait la règle.
Le cadre européen : ce que les signataires ont promis
Les règles de l’AI Act sur les modèles d’IA à usage général s’appliquent depuis le 2 août 2025, et la version finale du code de bonnes pratiques qui aide à les respecter a été publiée le 10 juillet 2025.
Dans son chapitre sur le droit d’auteur, la mesure 1.3 vise les signataires qui collectent des pages, eux-mêmes ou par un tiers, pour la fouille de textes et de données et l’entraînement de leurs modèles. Ils s’engagent alors à utiliser des robots qui « lisent et suivent » les instructions du robots.txt, tel que défini par la norme RFC 9309, et à publier des informations sur leurs robots. Le texte rappelle que la directive européenne 2019/790 permet aux titulaires de droits de réserver leurs contenus contre cette fouille, par exemple par des moyens lisibles par machine.
Sur la page de la Commission (dernière mise à jour le 7 octobre 2026), la liste des signataires comprend notamment Amazon, Anthropic, Google, Microsoft, Mistral AI et OpenAI. Meta et Perplexity n’y figurent pas. xAI n’a adhéré qu’au chapitre sur la sûreté et la sécurité : la Commission précise que l’entreprise devra démontrer par d’autres moyens adéquats qu’elle respecte ses obligations de transparence et de droit d’auteur. Le code, lui, ne dit rien des visites déclenchées par un utilisateur.
Bloquer ou non : les conséquences pour votre site
Interdire les robots d’entraînement envoie un signal que les grands éditeurs signataires se sont engagés à suivre. Selon OpenAI, interdire GPTBot indique que votre contenu ne doit pas servir à entraîner ses modèles. Chez Anthropic, interdire ClaudeBot signale que vos futurs contenus doivent être exclus de ses données d’entraînement.
Fermer la porte aux robots de recherche, en revanche, a un coût. OpenAI écrit qu’un site qui bloque OAI-SearchBot n’apparaîtra pas dans les réponses de recherche de ChatGPT, et Perplexity recommande d’autoriser PerplexityBot pour figurer dans ses résultats. Pour un e-commerçant ou un indépendant, c’est un canal de visibilité, comme nous l’expliquions à propos du SEO local à l’ère de l’IA. Pour savoir si ChatGPT ou Perplexity citent déjà votre site, voyez notre comparatif des outils de visibilité IA.
Chez Google, le jeton Google-Extended ne joue ni sur la présence dans Google Search ni sur le classement. Les AI Overviews et le mode IA relèvent de Googlebot : le bloquer reviendrait à bloquer aussi Google Search. Pour limiter ce que Google reprend de vos pages, sa documentation sur les fonctionnalités d’IA renvoie aux balises nosnippet, data-nosnippet, max-snippet ou noindex.
Que faire maintenant
- Ouvrez votre fichier (votre-site.fr/robots.txt) et listez les groupes qui visent des robots IA. Vérifiez qu’une extension ou votre hébergeur n’en a pas ajouté à votre insu. Notre guide du SEO technique rappelle le rôle de ce fichier. Un éventuel fichier llms.txt, lui, ne bloque aucun robot.
- Décidez famille par famille, à l’aide du tableau ci-dessus : entraînement, recherche, visites demandées par un utilisateur. Google-Extended couvre aussi l’ancrage des réponses de Gemini.
- Écrivez un groupe par robot. Chez OpenAI comme chez Perplexity, chaque réglage est indépendant, et sa prise en compte peut prendre jusqu’à 24 heures environ. Anthropic demande de répéter les règles sur chaque sous-domaine.
- Contrôlez vos journaux serveur. Un identifiant de robot se falsifie en une ligne : comparez les adresses aux listes publiées par Google, OpenAI, Anthropic et Perplexity ou, pour Google, faites une recherche DNS inverse.
- Protégez par mot de passe ce qui doit rester privé. La norme RFC 9309 le précise : ces règles « ne sont pas une forme d’autorisation d’accès », et lister un chemin dans le robots.txt le rend public. Pour retirer une page de Google, c’est la balise noindex qui compte, comme l’explique notre guide de l’indexation.
Un exemple pour un site qui refuse l’entraînement (et l’ancrage dans Gemini) mais veut rester visible dans les moteurs de recherche IA :
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
À surveiller dans les prochains mois
La documentation de Google-Agent indique que Google expérimente le protocole Web Bot Auth, en cours de normalisation dans un groupe de travail de l’IETF. Ce protocole permet à un robot de signer cryptographiquement ses requêtes. Si les éditeurs l’adoptent, vérifier qu’un visiteur est bien le robot qu’il prétend être deviendra plus simple qu’avec les listes d’adresses.
Côté xAI, deux signaux à guetter : une page publique décrivant ses robots, et son adhésion au chapitre sur le droit d’auteur du code européen.
Les points encore incertains
Les deux tests sont modestes : chacun porte sur un site et quelques essais, et ne donne qu’un instantané. Un assistant qui respecte la règle aujourd’hui peut changer de méthode demain. Personne ne peut non plus vérifier de l’extérieur si une page bloquée a servi à l’entraînement. Anthropic parle d’ailleurs de vos contenus « futurs » : sa page ne dit rien de ce qui a déjà été collecté.
Contre le trafic déguisé, des praticiens rapportent sur Reddit que le filtrage comportemental donne de meilleurs résultats que les listes d’adresses ou d’identifiants. Quand les requêtes passent par des fournisseurs d’accès grand public, bloquer les adresses revient à bloquer aussi de vrais visiteurs.
Vous voulez savoir ce que votre robots.txt bloque vraiment et ce que vos journaux serveur disent des robots IA ? Demandez notre audit SEO gratuit.