
Le fichier llms.txt est un fichier texte écrit en Markdown, publié à l’adresse votresite.fr/llms.txt. Il présente votre site en quelques lignes et donne la liste des pages qu’un assistant IA devrait lire en priorité pour répondre à une question sur vous. Jeremy Howard, cofondateur d’Answer.AI et de fast.ai, l’a proposé le 3 septembre 2024. Il reste une proposition, publiée sur llmstxt.org et ouverte aux contributions sur GitHub.
Au 10 octobre 2026, le bilan est net. Google écrit que son moteur de recherche ignore ce fichier. Les pages où OpenAI, Anthropic et Perplexity décrivent leurs robots ne disent nulle part que ces robots le lisent.
Une étude d’Ahrefs portant sur 137 000 sites trouve que 97 % des fichiers llms.txt n’ont reçu aucune visite en mai 2026. Parmi les robots d’IA, ce sont surtout des agents, dont des outils de programmation, qui le demandent, et seulement quand on les y envoie.
Ce guide décrit le format, les données disponibles sur ses lecteurs et les cas où il vaut la peine d’en publier un. Il se termine par un modèle commenté pour un site de PME et un générateur qui construit le vôtre.
Un fichier Markdown à la racine du site
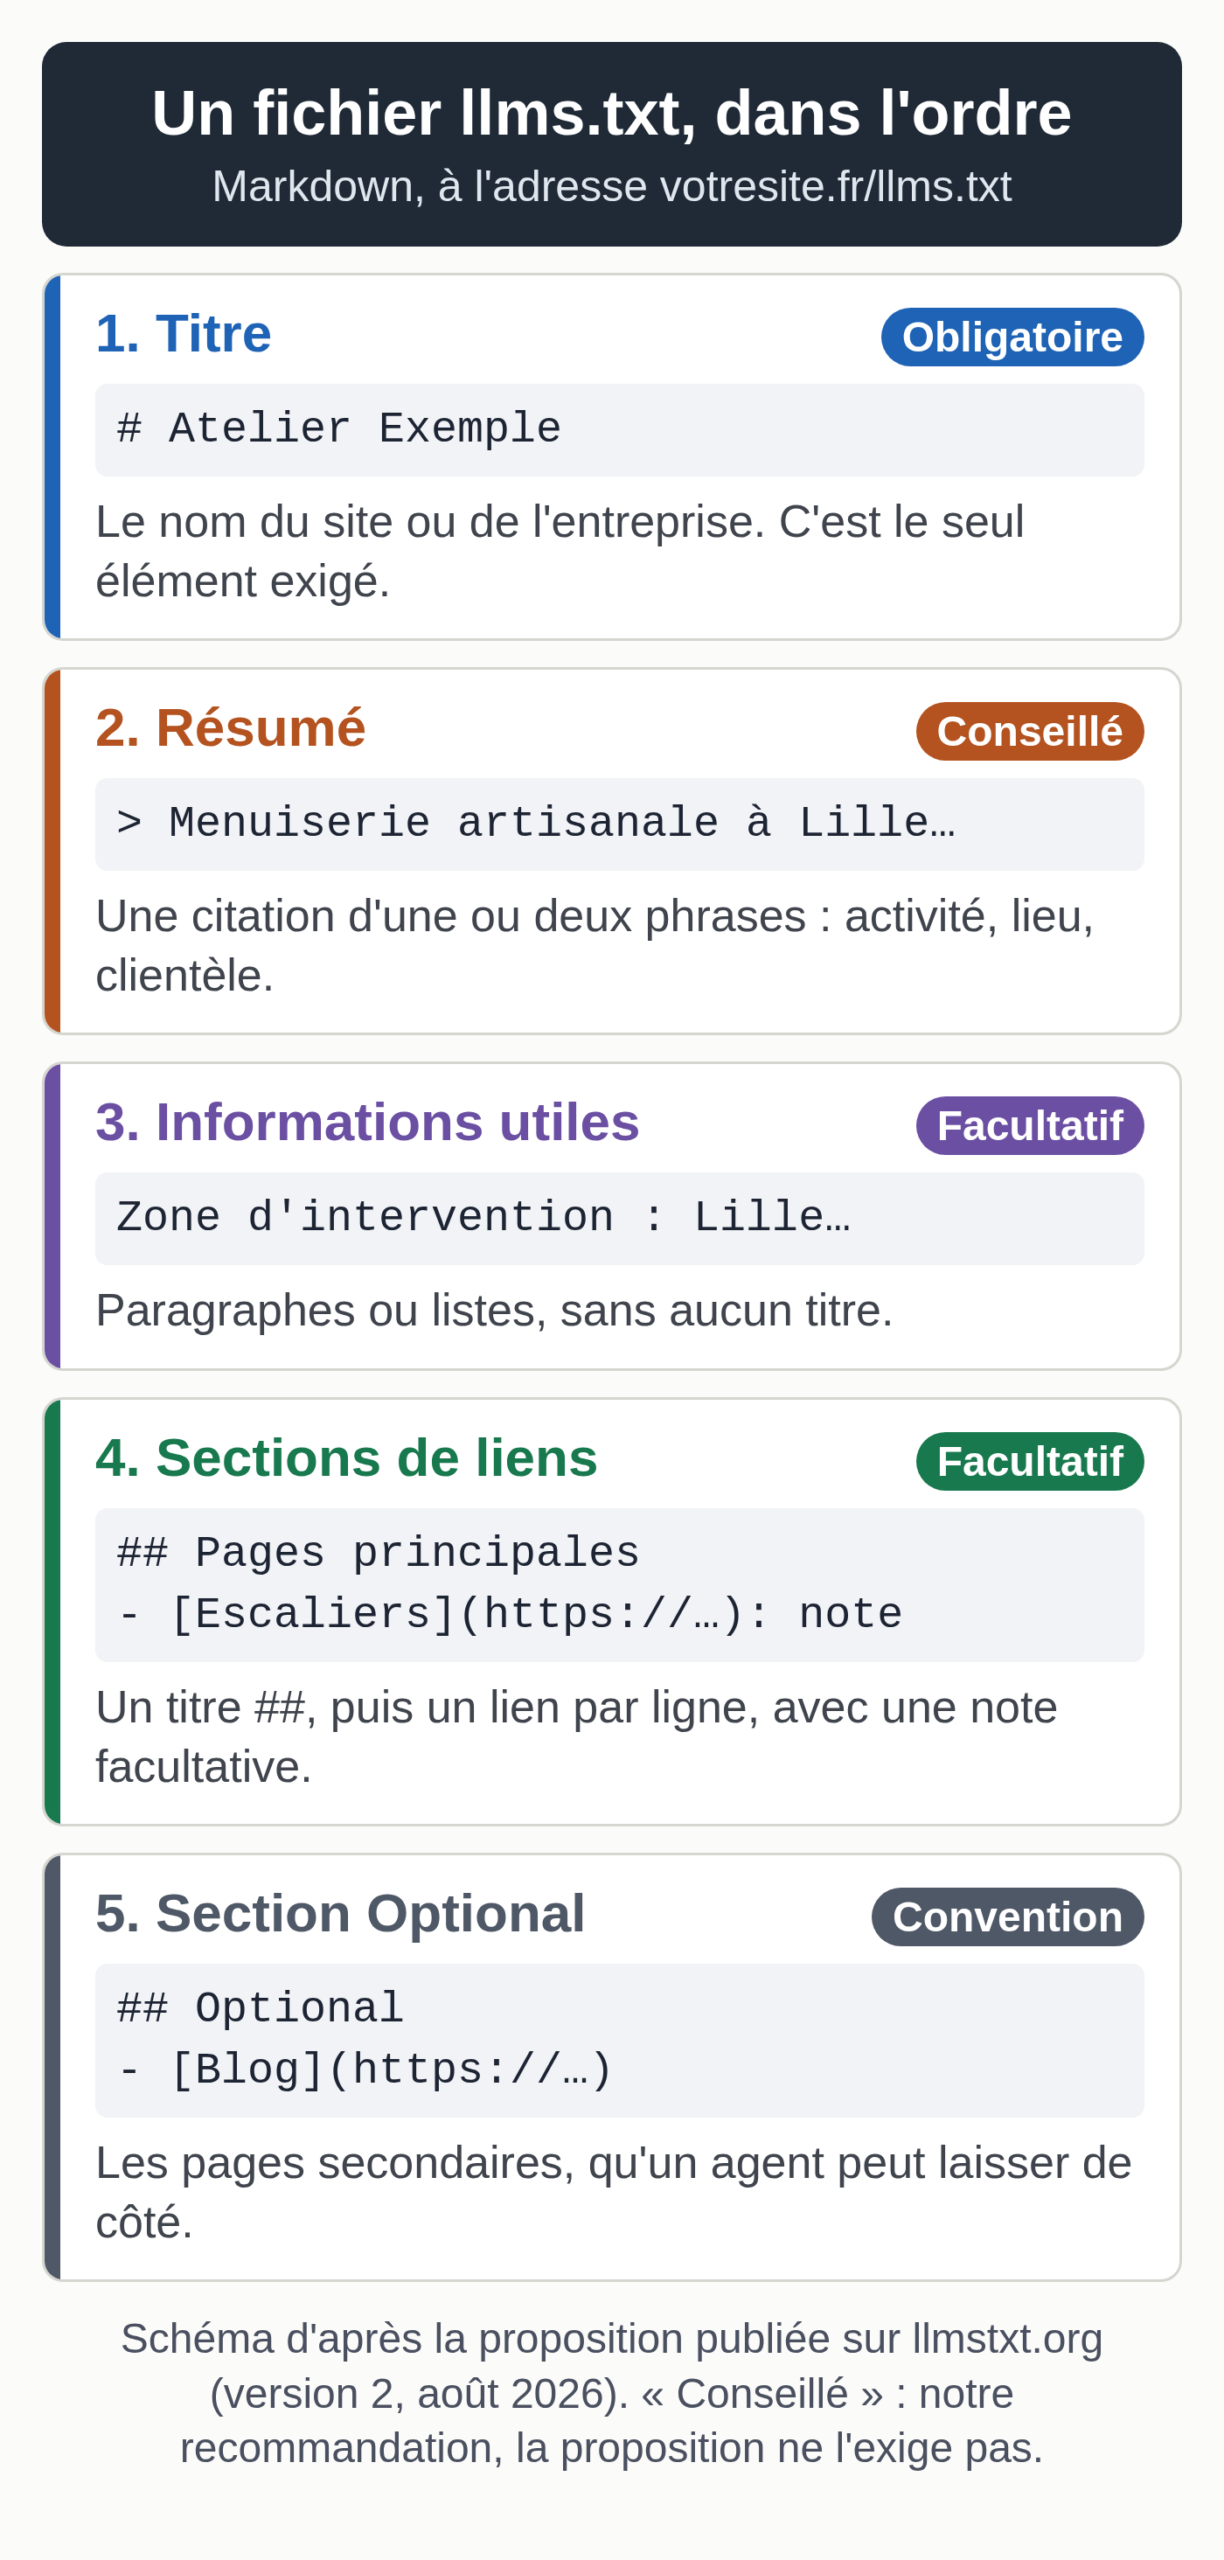
La proposition fixe un ordre précis. Le fichier commence par un titre de niveau 1, une ligne qui commence par #, avec le nom du site ou de l’entreprise : c’est le seul élément obligatoire. Vient ensuite une citation, une ligne qui commence par >, qui résume l’activité en une ou deux phrases avec les informations nécessaires pour comprendre la suite.
Après ce résumé, vous pouvez ajouter des paragraphes ou des listes sans titre : zone servie, langues, précisions utiles. Le reste du fichier est fait de sections ouvertes par un titre de niveau 2 (##). Chacune contient une liste de liens au format - [nom de la page](adresse): note, la note étant facultative.
Par convention, une section intitulée « Optional » regroupe les liens secondaires, ceux qu’un agent peut laisser de côté quand il manque de place. Le mot vient de la proposition, rédigée en anglais.
La version 2 d’août 2026
Jeremy Howard a publié une deuxième version de la proposition en août 2026. Elle précise qu’un fichier peut aussi se trouver dans un sous-dossier, par exemple /docs/llms.txt, et qu’il couvre alors les pages situées sous ce chemin. Quand plusieurs fichiers s’appliquent, l’agent retient le plus précis.
Elle recommande aussi de proposer une version Markdown des pages importantes à la même adresse, avec .md ajouté ou à la place de l’extension. Chaque page peut signaler sa version Markdown par un lien rel="alternate" de type text/markdown, et le llms.txt qui la couvre par un lien rel="describedby", dans le code de la page ou dans un en-tête HTTP. La section « Optional » perd au passage son sens technique : elle reste une convention, sans règle de traitement attachée.
Pour une PME, ces ajouts sont facultatifs. Un fichier racine qui pointe vers vos pages habituelles respecte le format, même si la proposition préfère des liens vers des versions Markdown.
Le rôle de llms.txt à côté de robots.txt et du sitemap
Les trois fichiers vivent à la racine du site et leurs noms se ressemblent. Leurs rôles diffèrent. Le robots.txt indique aux robots ce qu’ils ont le droit d’explorer ; son format est normalisé depuis septembre 2022 par la RFC 9309 de l’IETF. Le sitemap.xml liste toutes les pages que vous voulez voir indexées par les moteurs de recherche, sans les commenter.
Le llms.txt sélectionne une poignée de pages et les explique, pour un lecteur qui dispose d’un espace limité ; les droits d’accès restent l’affaire du robots.txt. La proposition le formule ainsi : le robots.txt dit aux robots quel accès est acceptable, le llms.txt sert à la demande, quand un agent cherche une information pour aider un utilisateur.
Si votre but est de bloquer un robot d’IA, ce fichier n’y peut rien. Ce travail revient au robots.txt, avec ses limites : notre article sur les robots IA et le robots.txt détaille quels assistants respectent ces règles et lesquels passent outre.
Qui lit llms.txt aujourd’hui ?
La position de Google
Google a tranché pour son moteur de recherche. Son guide d’optimisation pour les fonctions d’IA générative de la recherche, mis à jour le 10 juillet 2026, range les fichiers llms.txt parmi les sujets à ignorer : la recherche Google ne s’en sert pas, et en créer un ne nuit pas à votre visibilité ni à votre classement, sans les améliorer. Sa page consacrée aux aperçus IA et au mode IA ajoute qu’aucun fichier spécial n’est nécessaire pour y apparaître.
Une autre équipe de Google regarde le fichier autrement. Lighthouse, l’outil d’audit de Chrome, vérifie llms.txt dans ses audits consacrés à la navigation par des agents. Sa documentation, mise à jour le 5 mai 2026, explique que, sans ce fichier, un agent peut passer plus de temps à explorer le site pour en comprendre la structure. L’audit signale une erreur serveur sur ce fichier et classe son absence comme non applicable, puisque le fichier reste facultatif.
D’après le compte rendu qu’en a publié Ahrefs, John Mueller, de Google, interrogé sur cette contradiction par Lily Ray sur LinkedIn, a répondu que llms.txt n’est pas fait pour la recherche. Il y voit un appui provisoire pour les outils de programmation IA qui lisent de la documentation technique.
Les robots d’OpenAI, d’Anthropic et de Perplexity
Les trois éditeurs décrivent leurs robots dans des pages dédiées : GPTBot, OAI-SearchBot et ChatGPT-User chez OpenAI, ClaudeBot, Claude-User et Claude-SearchBot chez Anthropic, PerplexityBot et Perplexity-User chez Perplexity. Au 10 octobre 2026, aucune de ces pages ne dit que ces robots lisent ou respectent un llms.txt : celles d’OpenAI et de Perplexity ne citent le fichier que dans le bandeau de leur documentation, pour renvoyer vers leur propre index. Les réglages qu’elles décrivent pour les propriétaires de sites passent par le robots.txt.
Les mêmes éditeurs publient pourtant un llms.txt pour leur documentation technique. Les fichiers de developers.openai.com, de platform.claude.com et de docs.perplexity.ai répondent tous les trois, comme celui de la documentation de l’API Gemini de Google. Ils listent les pages de référence de leurs API, à l’usage des développeurs et de leurs outils de programmation.
Les journaux de 137 000 sites
L’étude publiée la plus large que nous ayons trouvée vient d’Ahrefs : elle est parue le 15 juin 2026, signée Louise Linehan avec Xibeijia Guan. L’éditeur a analysé les requêtes reçues par les 137 210 domaines équipés de son outil d’analyse d’audience et actifs en mai 2026. Parmi eux, 28 % publiaient un llms.txt, un chiffre que les auteurs présentent comme un plafond, car leurs clients sont plus techniques que la moyenne.
Sur ces quelque 38 000 fichiers, 97 % n’ont reçu aucune requête de tout le mois, ni robot ni humain. Dans les 3 % restants, 96 % des requêtes venaient de robots. Les outils d’audit SEO arrivent en tête avec 21,7 % des requêtes.
L’ensemble des robots d’IA pèse 19,5 % de ces requêtes. Les agents qui agissent pour un utilisateur, et les services construits pour eux, en font 10,5 % ; Claude Code, l’outil de programmation d’Anthropic, figure parmi les premiers. Les robots qui collectent des données d’entraînement suivent avec 5,3 %, GPTBot en tête.
Les assistants qui ouvrent une page pour répondre à une question, comme ChatGPT-User ou Claude-User, en font 2,5 %. Les robots qui alimentent les réponses des moteurs d’IA, comme OAI-SearchBot ou PerplexityBot, ne représentent que 1,1 %. Le robot d’aperçu de liens de la messagerie Slack a demandé ces fichiers plus souvent que PerplexityBot.
Deux résultats comptent pour une PME. Aucun robot d’IA n’a demandé de llms.txt sur un site qui n’en avait pas : 98 % des requêtes vers des fichiers absents venaient d’humains, probablement des référenceurs qui regardent chez leurs concurrents selon Ahrefs. Ahrefs en conclut que les agents demandent le fichier quand un lien, un index ou une consigne de l’utilisateur les y conduit, sans aller le chercher d’eux-mêmes. Les auteurs rappellent enfin qu’une requête ne prouve pas une lecture : tous leurs chiffres sont des plafonds.
Les raisons d’en publier un, et celles d’attendre
Le fichier coûte peu. Pour un site vitrine, il s’écrit en une séance de travail, et plusieurs extensions WordPress et constructeurs de sites le génèrent seuls. Il a des lecteurs réels quand vos clients passent par des agents : un développeur qui demande à son outil de programmation d’intégrer votre API, ou un agent qui compare des fournisseurs pour quelqu’un. L’exercice vous oblige aussi à désigner la dizaine de pages qui répondent aux questions de vos clients.
Pour la plupart des PME, les arguments contre pèsent plus lourd. Le fichier ne change rien à votre visibilité dans Google, qui l’écrit lui-même. Les robots qui alimentent les réponses de ChatGPT ou de Perplexity le demandent très rarement, d’après les journaux étudiés par Ahrefs. Un fichier oublié devient faux le jour où vous supprimez une page ou changez une offre, et un agent qui lui fait confiance répétera l’erreur.
Le fichier pose aussi une question de sécurité. Il est public et lu par des agents conçus pour s’y fier. Ahrefs a relevé dans ses journaux un robot de recherche nommé prompt-injection-survey ; d’après Ahrefs, il étudie ces fichiers comme un moyen de glisser des instructions aux agents. Limitez le nombre de personnes qui peuvent le modifier, et n’y mettez jamais d’adresse privée : espace client, page de test, document interne.
Notre recommandation dépend de votre site. Si vous publiez une documentation, une API ou un catalogue que des agents consultent pour vos clients, publiez un llms.txt soigné et tenez-le à jour. Si vous avez un site vitrine, activez la fonction de votre extension ou de votre constructeur quand elle existe, relisez le résultat et n’y passez pas plus de temps. Dans les deux cas, méfiez-vous d’une prestation vendue comme une « optimisation llms.txt » pour gagner des citations dans les IA : les données publiées citées plus haut ne montrent pas cet effet. Pour savoir si les assistants citent votre site, mesurez-le avec un outil de visibilité IA ou une grille de suivi manuel.
Le modèle commenté pour un site de PME
Voici un fichier complet pour une entreprise fictive, l’Atelier Exemple, une menuiserie de Lille. Le domaine example.com est réservé aux exemples : remplacez-le par le vôtre. Écrivez le fichier dans la langue de votre site, la proposition n’impose pas l’anglais.
# Atelier Exemple

> Menuiserie artisanale à Lille : cuisines, dressings et escaliers sur mesure pour les particuliers de la métropole lilloise.

L'atelier travaille le chêne, le noyer et le contreplaqué de bouleau. Zone d'intervention : Lille et 30 km autour.
Les demandes de devis passent par le formulaire de contact. L'atelier ne vend rien en ligne.

## Pages principales

- [Cuisines sur mesure](https://www.example.com/cuisines/): modèles réalisés, essences de bois, étapes du projet
- [Dressings et placards](https://www.example.com/dressings/): aménagements sous pente et niches
- [Escaliers](https://www.example.com/escaliers/): escaliers droits et quart tournant, rénovation de marches
- [Demander un devis](https://www.example.com/contact/): formulaire, adresse de l'atelier, horaires

## Informations pratiques

- [Questions fréquentes](https://www.example.com/faq/): délais, garanties, entretien du bois
- [L'atelier et l'équipe](https://www.example.com/atelier/): historique, artisans, machines

## Optional

- [Blog](https://www.example.com/blog/): conseils d'entretien et chantiers récents
- [Mentions légales](https://www.example.com/mentions-legales/)
Le titre reprend le nom tel que vos clients le tapent dans un moteur, sans slogan. Le résumé donne l’activité, le lieu et la clientèle en une phrase : c’est la première chose qu’un agent lit.
Le paragraphe d’informations dit ce qu’une page d’accueil laisse souvent implicite : les matériaux, la zone d’intervention, la façon de demander un devis et ce que l’entreprise ne fait pas. Cette dernière ligne donne à l’assistant une réponse claire quand un client lui demande s’il peut commander en ligne.
Les sections de liens suivent les questions de vos clients. Chaque note dit en quelques mots concrets ce que la page contient, pour que l’agent choisisse sans ouvrir toutes les pages. Les adresses sont complètes, avec https://. La section « Optional » garde les pages secondaires, comme le blog et les mentions légales.
Gardez le fichier court. La proposition demande qu’il tienne dans le contexte d’un agent, le détail restant derrière les liens. Une dizaine de liens suffit pour un site de PME.
Un générateur pour votre propre fichier
Le générateur ci-dessous reprend ce modèle. Remplissez le nom, l’adresse du site et le résumé, puis vos liens, à raison d’un par ligne sous la forme Titre | adresse | note. Les adresses courtes comme /contact/ sont complétées avec l’adresse du site.
L’outil signale les lignes sans adresse, les doublons, les adresses en http:// et les fichiers trop longs. Vous pouvez ensuite copier le texte ou télécharger le fichier llms.txt. Tout se passe dans votre navigateur : rien n’est envoyé ni enregistré.
Générateur de fichier llms.txt
Les champs sont préremplis avec l’exemple fictif de l’Atelier Exemple. Remplacez-les par vos informations : le fichier se construit dans votre navigateur, rien n’est envoyé ni enregistré.
Mise en ligne sur WordPress, Wix ou un hébergement classique
Sur un hébergement classique, enregistrez le fichier sous le nom llms.txt, encodé en UTF-8 pour que les accents s’affichent correctement. Déposez-le à la racine du site, dans le même dossier que le robots.txt, par FTP ou avec le gestionnaire de fichiers de votre hébergeur. Il doit répondre à l’adresse https://www.votresite.fr/llms.txt.
Au 10 octobre 2026, plusieurs extensions SEO de WordPress savent générer le fichier. Yoast SEO le propose dans sa version gratuite, avec une sélection des pages automatique ou manuelle. Rank Math l’active avec un module nommé « LLMS Txt » ; sa documentation précise que le fichier reste vide tant que vous n’avez pas choisi les contenus, et que les pages en noindex en sont exclues. Dans sa version payante, AIOSEO produit aussi un fichier llms-full.txt, qui rassemble le texte des contenus ; ce nom ne figure pas dans la proposition de llmstxt.org.
Gardez une seule source. Avec la configuration Apache que WordPress recommande, un fichier présent à la racine est servi directement, avant WordPress. Un fichier déposé à la main peut donc masquer celui d’une extension qui le produit à la volée, ou être écrasé par une extension qui écrit le sien.
À la même date, Wix génère et met à jour le fichier pour les sites qui ont un forfait payant, un domaine personnalisé et l’indexation activée, dans la partie SEO du tableau de bord (« SEO & GEO » dans l’interface anglaise). Si vous le modifiez à la main, Wix cesse de le mettre à jour ; un bouton permet de revenir à la version automatique.
Si votre site existe en plusieurs langues, la version 2 de la proposition permet de placer un fichier par dossier de langue, par exemple /en/llms.txt pour les pages anglaises, chacun rédigé dans sa langue. Rien n’empêche le fichier racine de pointer vers les autres. Notre guide du référencement d’un site multilingue détaille l’organisation des adresses par langue.
Vérifier le fichier, puis surveiller ses lecteurs
Ouvrez l’adresse du fichier dans votre navigateur. Vous devez voir du texte brut, avec des accents corrects. Si une page de votre site s’affiche à la place, avec le menu et le pied de page de votre thème, le fichier n’est pas au bon endroit. Cliquez ensuite chaque lien pour vérifier qu’il répond.
Faites ensuite le test que suggère la proposition : donnez à un assistant capable d’ouvrir des pages web l’adresse de votre llms.txt, et rien d’autre, puis posez-lui trois questions que vos clients vous posent souvent. Si les réponses sont fausses ou vagues, reprenez le résumé et les notes des liens.
Pour que les agents trouvent le fichier, signalez-le. La version 2 recommande un lien rel="describedby" vers le fichier, placé dans la partie <head> de vos pages ou envoyé dans un en-tête HTTP Link ; vous pouvez aussi le citer dans votre documentation. C’est la conclusion d’Ahrefs : un agent demande le fichier quand quelque chose l’y dirige.
Pour savoir qui le lit, consultez les journaux d’accès de votre hébergement, quand il les fournit. Sur un journal au format « combined » d’Apache ou de nginx, cette commande compte les requêtes vers le fichier par robot ou navigateur :
grep "GET /llms.txt" access.log | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn
Cherchez dans le résultat les noms de robots cités plus haut : GPTBot, ClaudeBot, Claude-User, ChatGPT-User, OAI-SearchBot, PerplexityBot. Refaites le compte après quelques mois. Si personne ne lit le fichier, gardez-le en l’état sans y consacrer plus de temps. Les visites que les assistants envoient vers vos pages se comptent, elles, dans Google Analytics 4 : voyez notre guide du trafic IA dans GA4.
Mettez-le à jour chaque fois qu’une page qu’il cite change d’adresse ou disparaît. Pour un site qui bouge peu, une relecture par trimestre suffit.
Le fichier dans une stratégie de visibilité IA
Le llms.txt reste un accessoire. Google rappelle que les bonnes pratiques SEO habituelles valent pour ses fonctions d’IA, et l’accès des autres assistants à vos pages se règle dans le robots.txt. Le fichier s’ajoute à ce travail, pour les agents qui le lisent. Les autres préparations pour ces agents (version Markdown, WebMCP, Content Signals) sont classées dans notre guide d’un site prêt pour les agents IA.
Si votre site existe en plusieurs langues, notre offre de SEO multilingue commence par un audit de vos langues actuelles : pages indexées, positions, doublons.