Le New York Times a assigné Brave Software, l’éditeur du navigateur et du moteur de recherche Brave, le 2 novembre 2026 devant le tribunal fédéral de Manhattan. Le même jour, les éditeurs du New York Daily News, du Chicago Tribune et de l’Orlando Sentinel ont déposé une seconde plainte, bâtie sur le même modèle. Les plaignants accusent Brave d’avoir copié leurs articles dans son index de recherche, de les restituer dans sa fonction de réponses Ask Brave et de les vendre, par son API payante, à des entreprises d’IA qu’ils nomment : Anthropic, Perplexity, Mistral, xAI et Cohere. Ces cinq entreprises sont citées comme clientes de Brave ; aucune n’est visée par ces deux plaintes.
Brave n’avait répondu ni devant le tribunal ni publiquement le 3 novembre au matin. L’affaire concerne aussi les propriétaires de sites : le robot qui alimente cet index ne s’annonce sous aucun nom distinct. Notre guide sur les robots IA et le fichier robots.txt explique comment ce fichier désigne chaque robot par son nom.
Deux plaintes et cinq griefs
La plainte de The New York Times Company (affaire 1:26-cv-09549) et celle des trois quotidiens (affaire 1:26-cv-09554) demandent un procès devant jury et portent la signature du même avocat, Steven Lieberman, du cabinet Rothwell, Figg, Ernst & Manbeck. Brave y est décrit comme « le fournisseur, le revendeur et le distributeur de contenus protégés volés », qui agirait à la fois comme « un cambrioleur » et comme un « receleur » d’IA « qui vend des contenus volés à des tiers » (notre traduction).
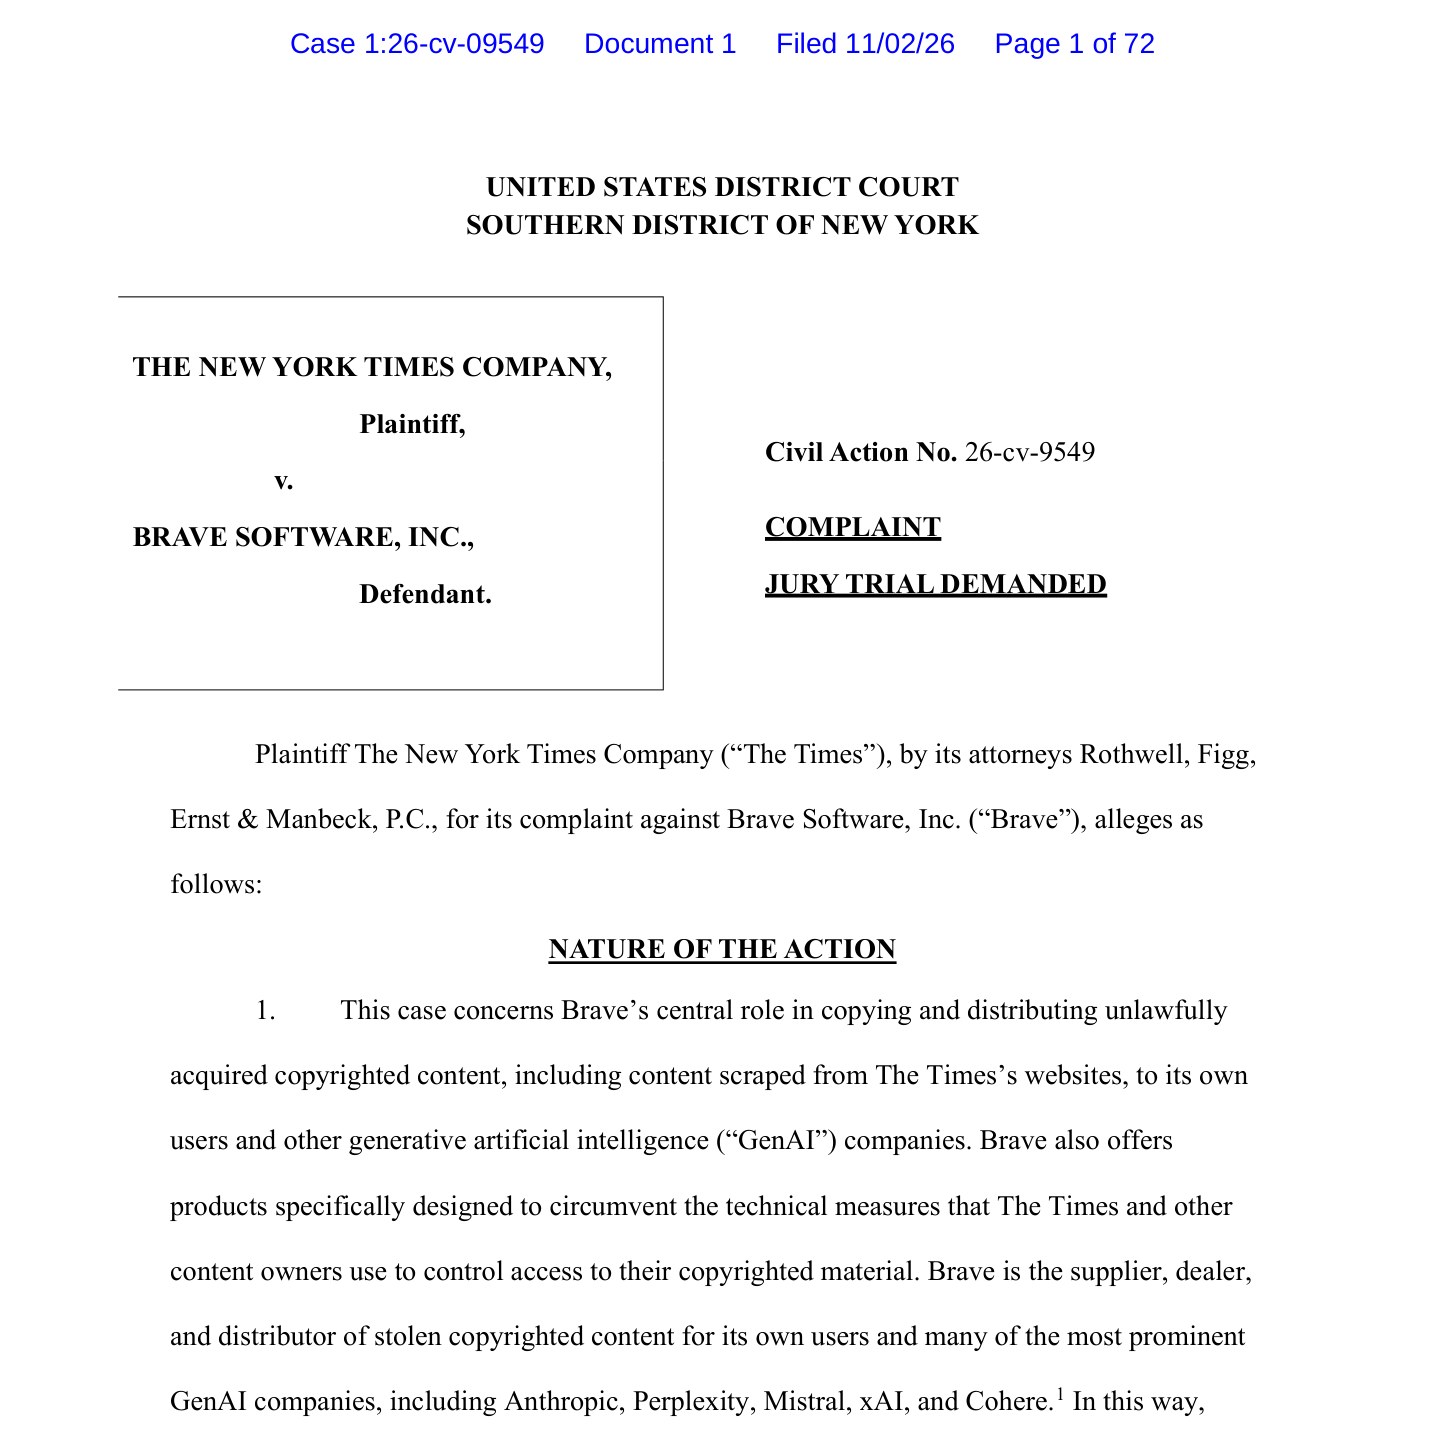
Chaque plainte compte cinq chefs de demande : contrefaçon directe du droit d’auteur, contribution à la contrefaçon (contributory infringement), responsabilité du fait d’autrui (vicarious infringement), contournement de mesures techniques de protection au sens du Digital Millennium Copyright Act (DMCA) et enrichissement sans cause en droit new-yorkais. Les plaignants réclament des dommages et intérêts, la restitution des profits et une injonction définitive, sans chiffrer de montant. Le Times dit détenir plus de 10 millions d’œuvres enregistrées au titre du droit d’auteur.
Le Times affirme avoir écrit deux fois au patron de Brave, Brendan Eich, le 11 août 2025 puis le 13 avril 2026. La seconde lettre évoquait des dommages et intérêts légaux majorés « jusqu’à 150 000 dollars par contrefaçon » (environ 134 000 euros au cours du 2 novembre 2026) en cas de violation délibérée. Selon la plainte, Brave n’a répondu à aucune des deux.
Un index de plus de 30 milliards de pages et trois produits visés
Brave revendique un index de « plus de 30 milliards de pages », sur lequel reposent deux des trois produits visés. Le premier, Ask Brave, est la fonction d’IA de Brave Search : elle répond aux questions en transmettant à un modèle de langage des pages tirées de l’index, une technique que Brave appelle « AI Grounding ». D’après la plainte du Times, Brave Search traite plus de 50 millions de requêtes par jour, dont un tiers reçoit une réponse générée par IA.
L’API Brave Search, deuxième produit visé, ouvre l’index à d’autres entreprises contre paiement. Les plaintes citent un guide de Brave de septembre 2023, selon lequel ses usages « les plus courants » sont l’entraînement et l’ancrage (« training and grounding ») de grands modèles de langage. Elles visent notamment l’accès « LLM Context », qui renvoie selon Brave des extraits de pages « sans besoin de scraping supplémentaire ». La page de présentation de Brave cite Cohere, Mistral, Perplexity et You.com parmi les utilisateurs de l’API.
Le 2 novembre 2023, en ouvrant son assistant Leo aux utilisateurs sur ordinateur, Brave écrivait lui-même qu’Anthropic avait « utilisé l’API de recherche de Brave pour entraîner son dernier modèle, Claude 2, sur des données de haute qualité », afin d’optimiser les réponses de Claude aux requêtes qui s’appuient sur une recherche (RAG).
Troisième produit visé, le navigateur propose un réglage nommé « Paywall blocker ». Les plaintes affirment que Brave le présente comme un moyen de « contourner les paywalls » et que le navigateur remplace les publicités des sites par celles de Brave Ads. Le site spécialisé PPC Land note que ce réglage figure parmi des listes de filtres optionnelles et que les plaintes ne disent pas s’il est activé à l’installation.
Les essais cités dans les plaintes
Une grande partie des plaintes reproduit, en regard des articles originaux, des échanges avec Ask Brave et des requêtes à l’API issus de l’enquête des plaignants. À partir de la seule adresse d’un article payant du Times, Ask Brave a proposé de « récupérer l’article complet », puis en a restitué plus de 400 mots à l’identique.
Interrogé à partir du seul titre d’un article du Times, l’accès LLM Context de l’API a renvoyé 1 291 des 1 295 mots du texte, à l’identique. La plainte des trois quotidiens décrit des essais du même type, dont l’un a restitué près de 600 mots d’un article du Daily News sur les calèches de Central Park.
Un robot sans nom distinct, par choix de Brave
Les plaintes reprochent à Brave de n’avoir « jamais divulgué le nom » de son robot d’exploration et d’avoir copié les pages « sans s’identifier » ni offrir aux sites un moyen de le bloquer. Le Times y voit une preuve de contrefaçon délibérée.
Brave assume ce choix sur la page d’aide de son robot. Celui-ci n’affiche pas d’identifiant (user agent) distinct, écrit l’entreprise, « parce que nous devons éviter d’être discriminés par les sites qui n’autorisent que Google ». Selon Brave, son robot n’explore rien de ce qui est interdit à Googlebot, et robots.txt ne sert pas à empêcher l’indexation : pour retirer une page de Brave Search, il faut la directive noindex, puis un nouveau passage du robot, qu’un formulaire permet de demander.
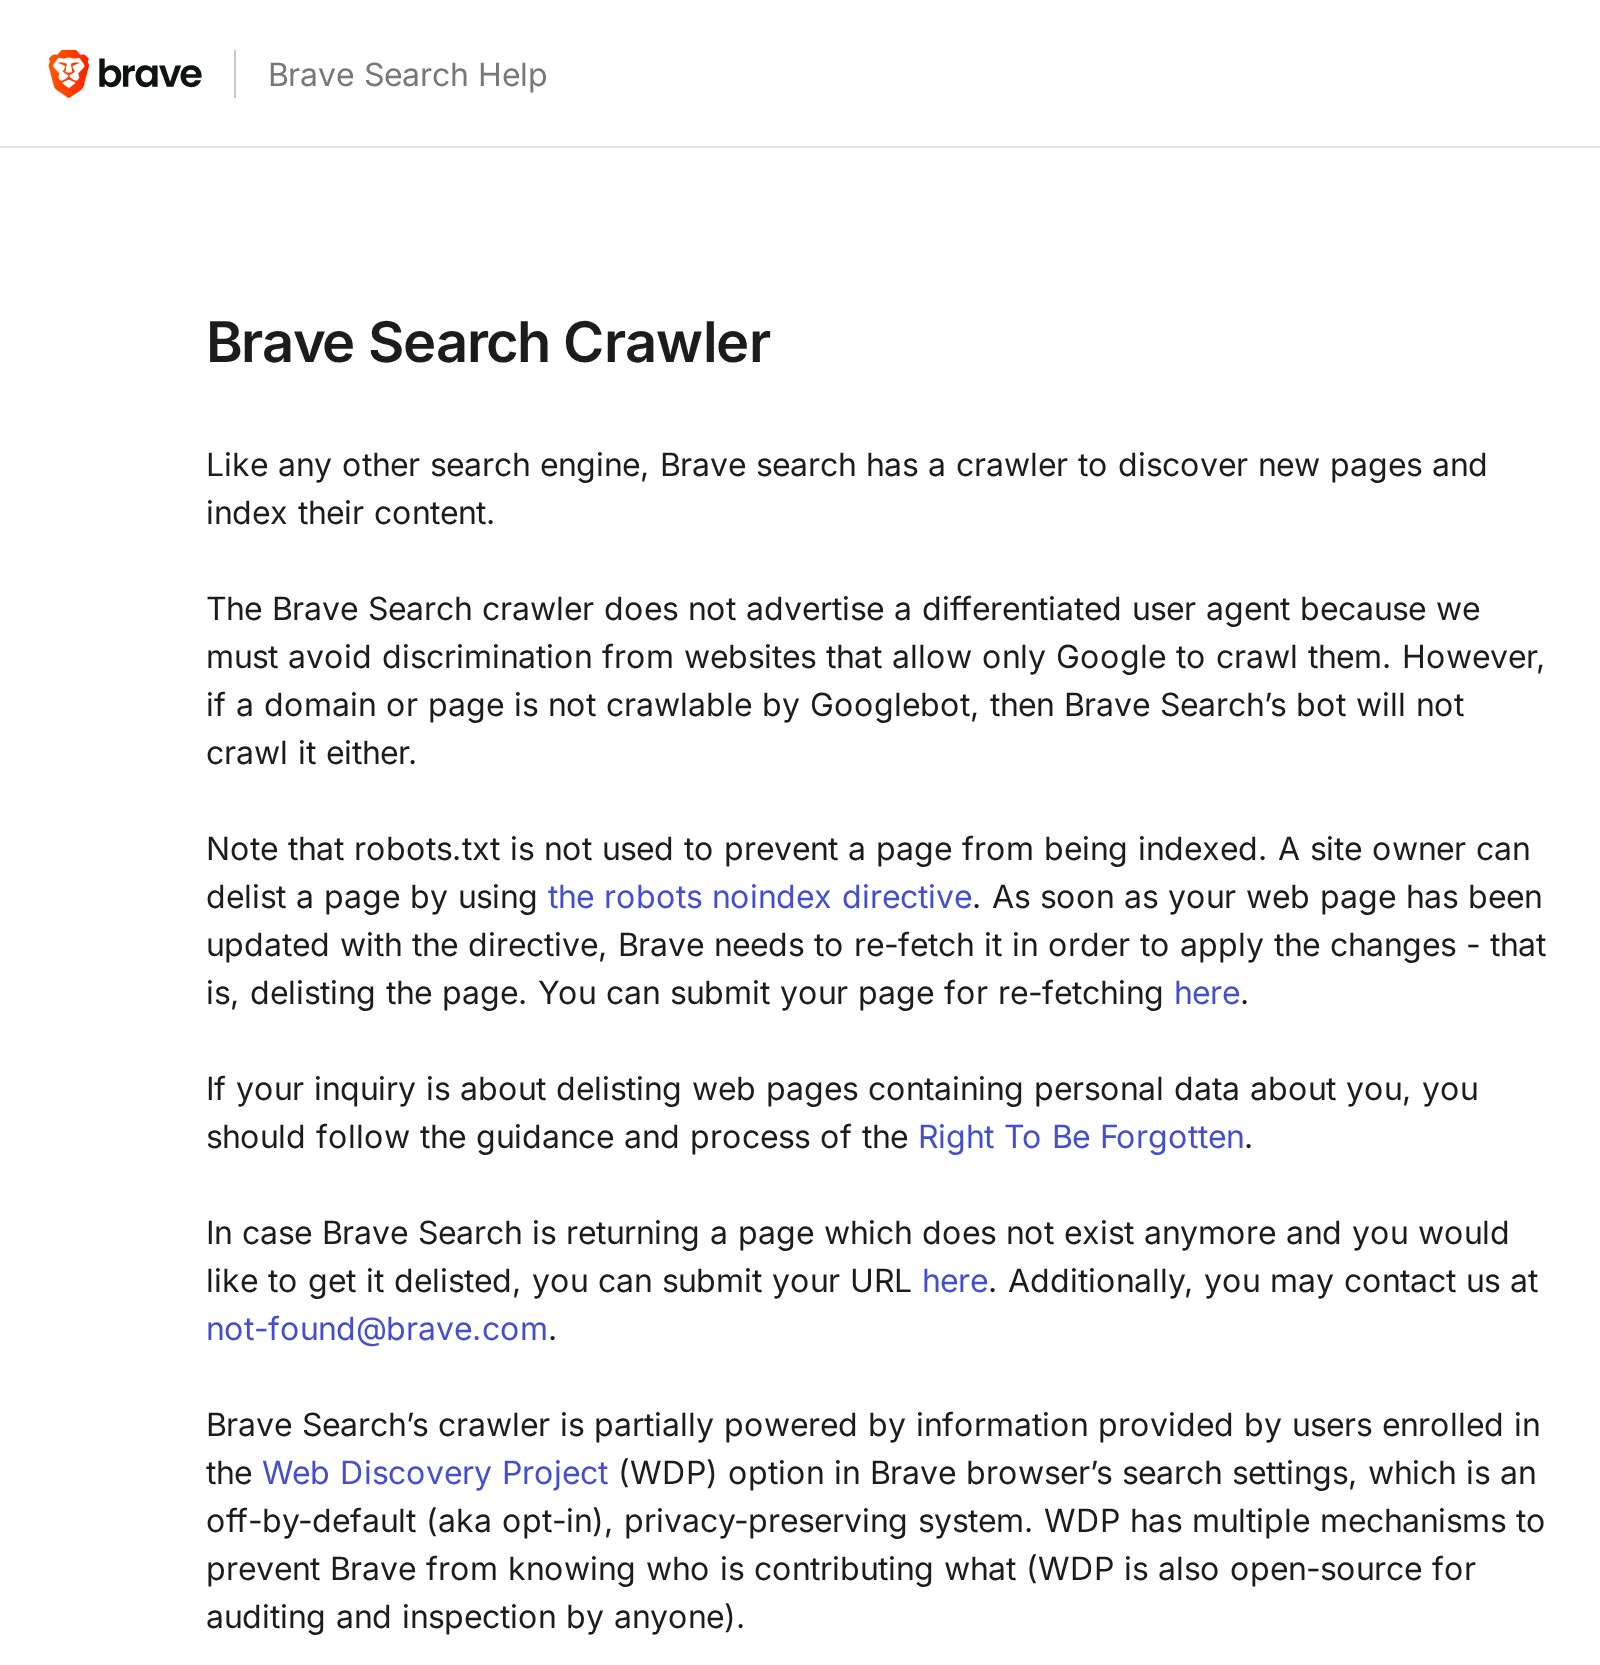
En pratique, note PPC Land, robots.txt n’offre aucune consigne propre à Brave : un éditeur qui veut écarter ce robot doit aussi écarter Googlebot. Brave ne fait pas partie des quatre entreprises (Google, Microsoft, OpenAI et Anthropic) qui ont annoncé le 30 octobre qu’elles respecteraient un même signal robots.txt contre l’entraînement des modèles.
Perplexity réplique, Brave n’a pas répondu
Graham James, porte-parole du Times, a déclaré à The Verge vouloir « obliger Brave à rendre des comptes » pour avoir « volé » ses contenus. Chez Perplexity, le directeur de la communication, Jesse Dwyer, a répliqué que « le New York Times paie trop ses avocats et pas assez ses journalistes » (notre traduction). Brave, Anthropic, Mistral et Cohere n’avaient pas répondu à The Verge.
En mars 2025, après une mise en demeure de News Corp, propriétaire du Wall Street Journal et du New York Post, Brave avait pris les devants en demandant à un tribunal fédéral de San Francisco de déclarer ses pratiques légales. « Des décennies de jurisprudence et de pratique confirment qu’indexer le contenu d’un site pour faire fonctionner un moteur de recherche n’est pas une contrefaçon du droit d’auteur. C’est un usage loyal (fair use) », écrivait Brave, cité par The Register.
News Corp a riposté le 21 juillet 2026 par une demande reconventionnelle devant le tribunal fédéral d’Oakland, selon une dépêche de Reuters reprise par The Spokesman-Review. Le Times poursuit déjà OpenAI, Microsoft et Perplexity, rappellent TechCrunch et PPC Land.
Des accusations encore à prouver
Aucun juge ne s’est prononcé. Plusieurs des questions rédigées par les plaignants demandent à Ask Brave de proposer le texte intégral, avant qu’il en restitue de longs passages. Rien n’indique, relève PPC Land, à quelle fréquence des utilisateurs ordinaires obtiennent des articles entiers.
Les deux plaintes affirment que Brave a gagné « plus de 100 millions de dollars » (environ 89 millions d’euros) en copiant et en revendant le travail des éditeurs, sans en citer la source. Le seul autre montant de 100 millions de dollars que citent les plaintes, note PPC Land, est une estimation de tiers du chiffre d’affaires total de Brave en 2025, toutes activités confondues ; Brave, société non cotée, ne publie pas ses comptes.
Les plaintes ne disent pas quels services de Brave les clients cités utilisent aujourd’hui, ni si l’un d’eux a reçu des articles des journaux, ajoute le site. Selon la plainte des trois quotidiens, le cinquième chef de demande, qui « ne dépend d’aucune copie », porte sur les recettes que Brave tirerait en remplaçant les publicités des journaux. Selon PPC Land, les captures jointes montrent des emplacements vidés, sans annonce de Brave à la place.
Notre analyse
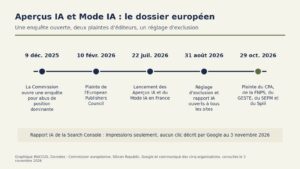
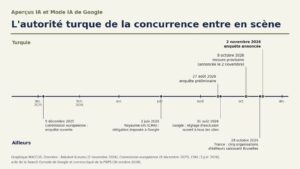
Les éditeurs remontent la chaîne d’approvisionnement de l’IA. Après les fabricants de modèles et les moteurs de réponse, la cible est un fournisseur d’index qui loue le web aux entreprises d’IA. Si la thèse des plaignants tient, les demandes de licences pourraient s’étendre aux fournisseurs d’API de recherche et à leurs clients. En Europe et en Turquie, éditeurs et autorités visent encore surtout Google : cinq organisations françaises ont saisi la Commission européenne contre les Aperçus IA le 29 octobre, et l’autorité turque de la concurrence a imposé des conditions provisoires au profit de la presse.
Le dossier fait aussi de l’absence de nom distinct du robot d’exploration une question judiciaire : les plaignants y voient une manière d’échapper aux blocages, Brave une protection contre les sites qui n’ouvrent leurs portes qu’à Google. S’il était retenu, le raisonnement du cinquième chef de demande, qui vise les recettes qu’un navigateur tirerait en substituant ses annonces à celles d’un site, sans exiger de copie, pourrait être repris par d’autres sites financés par la publicité.
Plusieurs points restent ouverts : la défense de Brave, qui invoquait l’usage loyal face à News Corp ; la question de savoir si un filtre de navigateur contourne une protection « efficace » au sens du DMCA ; l’usage actuel de l’API par les clients cités.
La prochaine étape est la réponse de Brave aux deux plaintes, qui pourrait prendre la forme d’une demande de rejet. Le dossier News Corp, lui, suit son cours en Californie.
Sources
- The New York Times Company v. Brave Software, Inc., complaint, No. 1:26-cv-09549, The New York Times Company, 2 novembre 2026
- Daily News, LP et al. v. Brave Software, Inc., complaint, No. 1:26-cv-09554, CourtListener, 2 novembre 2026
- Brave Search Crawler, Brave, consulté le 3 novembre 2026
- Leo, Brave’s AI browser assistant that preserves users’ privacy, is now available to desktop users, Brave, 2 novembre 2023
- The New York Times sues Brave web browser for AI scraping and bypassing paywalls, The Verge, 2 novembre 2026
- New York Times and other outlets sue web browser Brave over alleged content scraping, TechCrunch, 2 novembre 2026
- New York Times and three papers sue Brave over AI answers and ad blocking, PPC Land, 3 novembre 2026
- Brave wants court to endorse scraping of News Corp content, The Register, 13 mars 2025
Image d’en-tête : schéma MACCUS des accusations. Données : plaintes 1:26-cv-09549 et 1:26-cv-09554 (2 novembre 2026) et page « AI » de Brave, consultées le 3 novembre 2026.