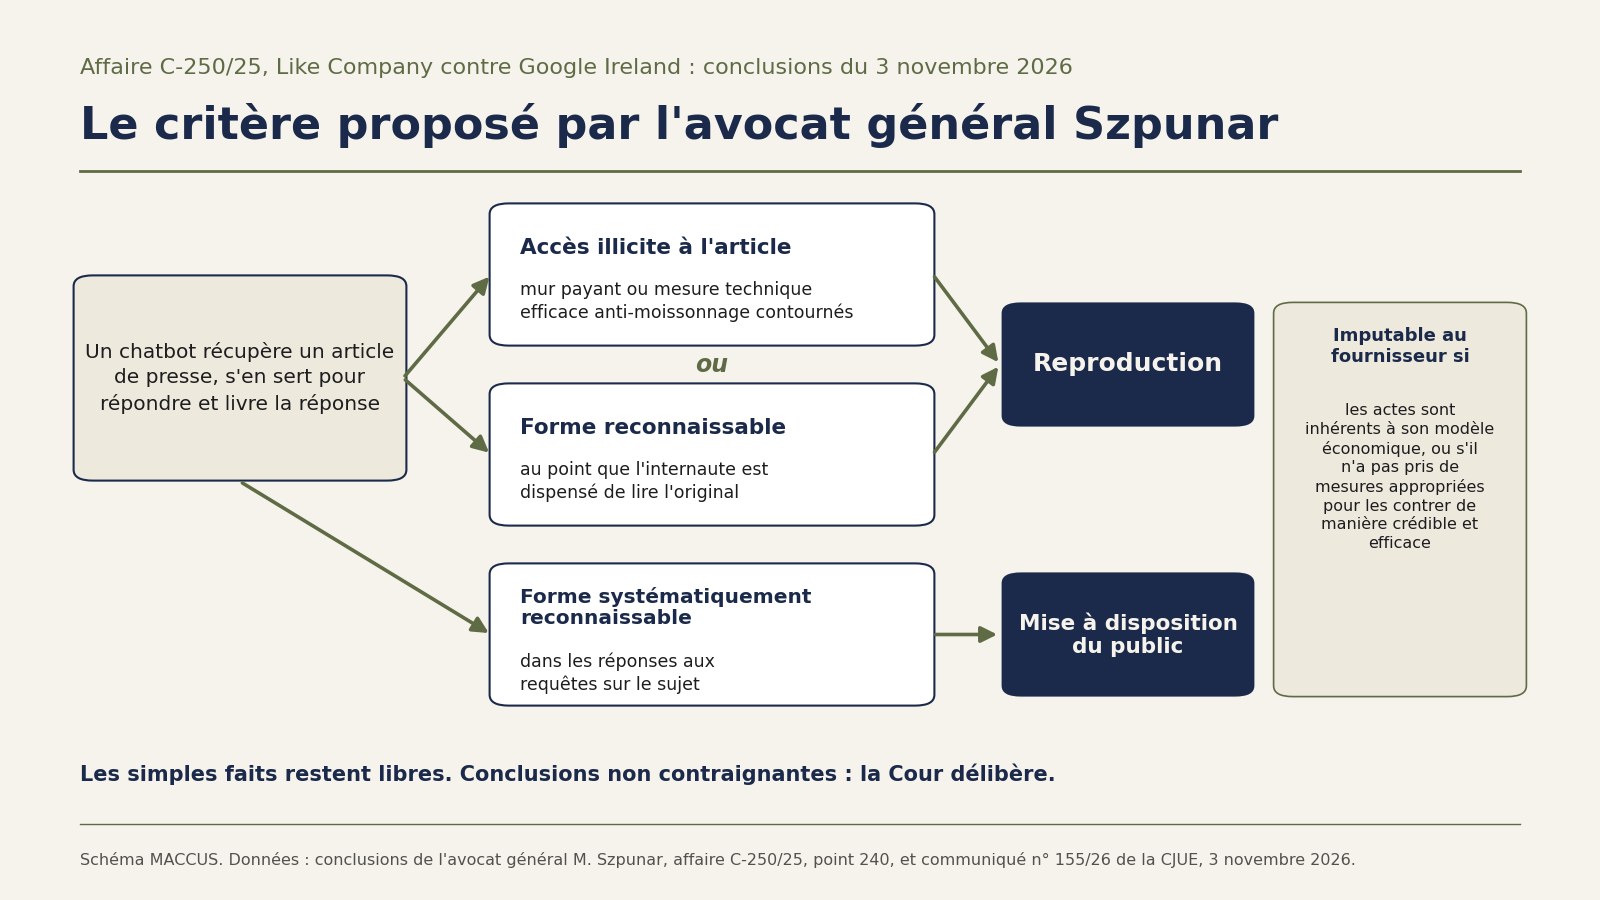

L’avocat général Maciej Szpunar a proposé le 3 novembre 2026 à la Cour de justice de l’Union européenne de juger qu’un agent conversationnel comme Gemini peut, dans certaines circonstances, porter atteinte au droit voisin des éditeurs de presse quand il récupère un article en temps réel pour répondre. Il retient deux cas : un accès illicite à l’article, par exemple par le contournement d’un mur payant, ou une réponse qui reprend la forme de l’article au point que l’internaute n’a plus besoin de lire l’original. L’affaire C-250/25, qui oppose l’opérateur hongrois de portails Like Company à Google Ireland, est la première relative à l’IA générative portée devant la Cour.
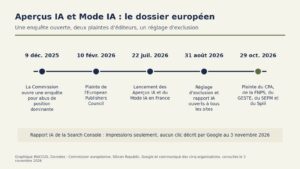
Sur l’entraînement des modèles, l’avocat général propose de déclarer irrecevables les deux questions posées, et ajoute que cet usage est, « en règle générale », librement autorisé par l’exception pour la fouille de textes et de données. Ces conclusions ne lient pas la Cour, qui commence à délibérer. Elles arrivent cinq jours après la plainte d’organisations d’éditeurs français contre les Aperçus IA de Google auprès de la Commission européenne.
Un portail hongrois face à Google
Like Company a assigné Google devant la cour de Budapest-agglomération au nom du droit voisin créé par la directive européenne 2019/790. Elle soutient que Google a utilisé ses articles pour « entraîner » les modèles Gemini, et les a reproduits et mis à la disposition du public à plusieurs reprises par le chatbot entre le 13 juin 2023 et le 31 mai 2024.
Pour répondre sur l’actualité, Gemini utilise la technique dite RAG (génération augmentée par récupération) et, selon le communiqué de la Cour, « récupère (ou « moissonne ») souvent des articles de presse disponibles en ligne ». Par une demande déposée le 3 avril 2025, la juridiction hongroise a posé quatre questions à la Cour : deux sur l’entraînement, deux sur les réponses du chatbot.
Les faits restent libres, la forme est protégée
Le droit de l’éditeur, souligne l’avocat général, « ne protège pas les simples faits rapportés dans les publications de presse, mais uniquement la forme d’expression spécifique de ces publications ». Le texte intégral des conclusions, rédigé en anglais, définit cette forme comme la manière dont un article est agencé, structuré et rédigé (point 199). Une analyse fouillée, ajoute l’avocat général, sera plus facile à reconnaître dans une réponse qu’un compte rendu purement factuel (point 206).
Deux cas de reproduction
Selon le communiqué, l’avocat général fait dépendre la reproduction de « deux facteurs ». Le premier est de savoir si l’agent conversationnel « a accédé de manière illicite à la publication de presse en cause, notamment en contournant des mesures techniques efficaces (telles qu’un mur payant) destinées à restreindre l’accès à cette publication ou à empêcher son moissonnage sur l’Internet ». Le second, si la réponse « réutilise la forme d’expression de cette publication d’une manière reconnaissable, à tel point que l’utilisateur, en lisant cette réponse, est entièrement dispensé d’accéder à la publication originale ».
Le communiqué ne dit pas s’il faut les réunir. Le texte intégral les relie par un « or » (« ou ») dans la réponse proposée à la Cour (point 240) : un seul suffit. Reformuler ne met pas le chatbot à l’abri si la forme de l’article reste reconnaissable : limité à la copie mot pour mot, le droit de reproduction serait trop facile à contourner, comme le soutenaient notamment Like Company et la France (point 205).
Le droit de mise à disposition du public serait, selon l’avocat général, violé « en règle générale » lorsque la forme de l’article est « systématiquement reconnaissable » dans les réponses sur le sujet. Ce scénario lui paraît « plutôt improbable » (notre traduction), car les réponses varient d’une requête à l’autre, et c’est aux éditeurs de le démontrer, exemples à l’appui (point 214).
La responsabilité du fournisseur
Quand un internaute demande expressément à un chatbot de reprendre un article, la responsabilité première devrait en principe revenir à cet internaute, estime l’avocat général (point 219). Le fournisseur en répondrait pourtant lorsque ces actes sont « inhérents au modèle économique de ce fournisseur », ou lorsqu’il n’a pas mis en place les mesures appropriées pour les contrer « de manière crédible et efficace ». Les conclusions citent parmi ces mesures des robots qui respectent les restrictions d’accès des éditeurs et des filtres qui écartent les réponses trop proches des articles récupérés (point 222).
L’argument du consentement tacite rejeté
L’avocat général rejette l’argument de Google selon lequel un éditeur qui laisse ses articles en libre accès, sans mur payant ni blocage des robots, consent implicitement à leur réutilisation par les chatbots (points 224 à 228). Un mur payant est un choix commercial, et bloquer les robots n’est « pas aussi simple qu’il y paraît » (notre traduction) : Google semble utiliser les mêmes robots pour indexer les sites et alimenter les réponses de son chatbot.
Une interdiction dans le fichier robots.txt, dont notre guide sur les robots IA détaille le fonctionnement, peut donc coûter de la visibilité dans les moteurs de recherche, comme Like Company l’a expliqué à l’audience. En France, l’Autorité de la concurrence avait relevé ce problème le 20 mars 2024, en annonçant une amende de 250 millions d’euros contre Google dans le dossier des droits voisins. Jusqu’au lancement de Google-Extended, le 28 septembre 2023, un éditeur qui refusait que Bard, devenu Gemini, utilise ses contenus devait interdire toute exploration par Google, Search, Discover et Google News compris.
Google affirme que cet outil permet de bloquer l’entraînement et l’ancrage des réponses de Gemini sans effet sur la visibilité dans Google. Pour l’avocat général, cela « devrait être vérifié » (note 236, notre traduction).
Pour Maciej Szpunar, l’entraînement sort du litige
Les questions sur l’entraînement sont hypothétiques, selon l’avocat général : rien ne prouve que les modèles Gemini ont été entraînés sur les articles de Like Company, et l’entraînement n’est pas une « utilisation en ligne » de publications de presse. L’exception pour la fouille de textes et de données, qu’il examine « dans un souci d’exhaustivité », suppose un accès licite (points 141 et 142), et les titulaires de droits peuvent s’y opposer, pour les contenus en ligne, par des procédés lisibles par machine (article 4 de la directive).
L’avocat général range robots.txt et Google-Extended parmi ces procédés (point 149), tout en notant que robots.txt « n’empêche pas techniquement » le moissonnage (note 153, notre traduction). Le 30 octobre, Google, OpenAI, Microsoft et Anthropic ont annoncé un signal robots.txt commun contre l’entraînement.
Le cas Like Company vu par l’avocat général
Sous réserve des constatations du juge hongrois, l’avocat général estime que les conditions ne semblent pas réunies (point 239). Il apparaît que Like Company n’avait mis en place aucune mesure technique efficace contre l’accès ou le moissonnage. Les reprises ne paraissent pas inhérentes au modèle économique de Google, qui semble avoir pris des mesures appropriées.
L’exemple produit par Like Company est une réponse de Gemini à une requête demandant le résumé d’un article de Like Company sur le projet d’un chanteur hongrois d’amener des dauphins au lac Balaton. En dehors de mots isolés, seule la première phrase de l’article s’y retrouve (point 204).
Selon l’AFP, un porte-parole de Google affirme que Gemini « apprend des schémas linguistiques pour créer des contenus originaux plutôt que de reproduire des contenus », et salue des conclusions qui reconnaissent que le droit de l’Union autorise l’entraînement de l’IA « sur des informations publiquement accessibles » (nos traductions).
Les questions encore ouvertes
La Cour peut s’écarter des conclusions, et son communiqué n’annonce aucune date d’arrêt. Son interprétation liera la juridiction hongroise comme toute autre juridiction saisie d’une question similaire.
Le communiqué ne mentionne ni les Aperçus IA (AI Overviews) ni le Mode IA de Google, que le texte intégral cite comme fondés sur la même technologie et visés par les mêmes griefs des éditeurs (points 156 à 159). Les questions posées portent toutefois sur le chatbot Gemini, et rien ne dit comment un arrêt s’appliquerait à ces fonctions du moteur.
Restent aussi à préciser ce qui compte comme mesure technique « efficace » contre les robots, et la frontière entre un résumé libre et une reprise reconnaissable, une « zone grise » à apprécier au cas par cas selon l’avocat général (point 209, notre traduction).
Notre analyse
L’avocat général sépare deux sujets que les plaintes récentes des éditeurs mêlent souvent. L’entraînement serait libre en règle générale, sauf opposition lisible par machine. Les réponses construites en temps réel seraient jugées sur la manière dont le robot a obtenu l’article et sur ce qu’il en reste.
Ce test protège mieux les éditeurs à accès payant et les contenus d’analyse que les sites gratuits d’actualité factuelle. Maciej Szpunar estime que cet équilibre laisse les éditeurs en position de force pour négocier des licences, parce que les chatbots ont besoin de leurs articles pour répondre sur l’actualité (point 236).
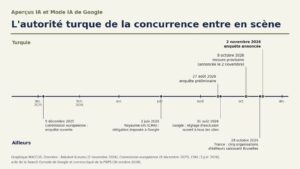
Pour les sites qui vivent du trafic de Google, le dilemme du blocage reste entier : interdire les robots coûte de la visibilité si les mêmes servent la recherche et les réponses générées. L’autorité turque a traité ce point par une mesure provisoire en octobre.
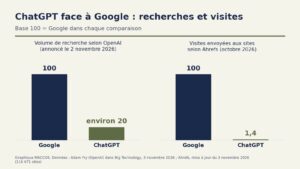
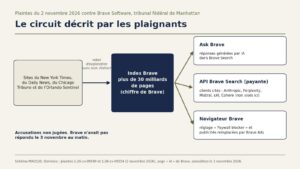
Le droit voisin ne compense pas la perte de clics quand une réponse reprend seulement les faits : il n’a jamais visé, rappelle l’avocat général, à protéger les éditeurs contre la concurrence en tant que telle (point 208). Les éditeurs français ont choisi à Bruxelles le droit de la concurrence, ceux des États-Unis le droit d’auteur, comme le New York Times contre Brave depuis le 2 novembre.
Pour Like Company, la suite tient en deux étapes : l’arrêt de la Cour de justice, attendu dans environ six mois selon l’AFP, puis la décision de la juridiction hongroise.
Sources
- Communiqué de presse n° 155/26, conclusions de l’avocat général Maciej Szpunar dans l’affaire C-250/25, Like Company, Cour de justice de l’Union européenne, 3 novembre 2026
- Opinion of Advocate General Szpunar, Case C-250/25, Like Company v Google Ireland Limited (texte provisoire, ECLI:EU:C:2026:919), CURIA, 3 novembre 2026
- Google AI chatbot may break press copyright rules: EU legal adviser, AFP, repris par The Post, 4 novembre 2026
- Related rights: the Autorité fines Google €250 million for non-compliance with some of its commitments made in June 2022, Autorité de la concurrence, 20 mars 2024
Image d’en-tête : schéma MACCUS du critère proposé. Données : conclusions de l’avocat général M. Szpunar, affaire C-250/25, point 240, et communiqué n° 155/26 de la CJUE, 3 novembre 2026