Le 16 novembre 2026, le groupe chinois Alibaba a lancé Qwen4-Max, le nouveau modèle d’intelligence artificielle phare de son équipe Qwen. Il est facturé 25 % de moins que Qwen3.8-Max, le modèle qu’il remplace en haut de gamme. Le graphique publié par Alibaba le place pourtant derrière Claude Opus 5.5, un modèle concurrent d’Anthropic, sur 10 tests sur 16.
Le modèle reste fermé : Alibaba ne publie pas ses poids, les valeurs numériques qui le constituent. Il s’utilise seulement à distance, dans les applications d’Alibaba (Qwen Studio, QwenWork et Qoder) ou par l’API de QwenCloud, son service en ligne. Cette interface de programmation permet aux logiciels d’une entreprise d’appeler le modèle. La néobanque Revolut a fait le choix inverse pour son code : elle dit payer dix fois moins depuis qu’elle a remplacé Claude Code par GLM, un modèle chinois qu’elle fait tourner sur ses propres serveurs.
Le token (ou jeton), un fragment de mot, est l’unité dans laquelle les modèles comptent et facturent le texte. Qwen4-Max coûte 1,50 dollar par million de tokens envoyés et 4,50 dollars par million de tokens produits, soit environ 1,36 et 4,07 euros.
Dans le billet de lancement de l’équipe Qwen, Alibaba met surtout en avant les économies face à Qwen3.8-Max : jusqu’à environ deux fois moins de tokens consommés.
Une nouvelle architecture, toujours 2 400 milliards de paramètres
Selon le billet, Qwen4-Max compte 2 400 milliards de paramètres dans sa structure principale. Les paramètres, ou poids, sont ajustés pendant l’entraînement ; leur nombre donne une idée de la taille d’un modèle. Le modèle n’en active que 71 milliards pour chaque token traité. Ce principe, appelé mélange d’experts (MoE en anglais), réduit le calcul nécessaire à chaque réponse.
Le modèle compte aussi 328 milliards de paramètres d’un autre genre : des tables qui répertorient de courtes suites de tokens. Selon Alibaba, elles augmentent la capacité du modèle pour peu de calcul.
Qwen4-Max lit également les images et les vidéos. Sa fenêtre de contexte, la quantité de texte qu’il peut traiter en une fois, atteint un million de tokens, comme celle de Qwen3.8-Max.
La taille, elle, ne change pas : sur QwenCloud, la fiche de Qwen3.8-Max annonce déjà 2 400 milliards de paramètres. Selon l’agence Dow Jones Newswires, ce chiffre pourrait décevoir les marchés, car certains avaient avancé que Qwen4 pourrait dépasser 3 000 milliards. Moonshot AI revendique ce cap pour son modèle Kimi K3.1 Pro.
Le billet ne dit pas sur quelles puces le modèle a été entraîné. Un chercheur a retrouvé dans les poids de modèles chinois la trace de puces Nvidia interdites d’exportation. Sa méthode suppose des poids publiés : elle ne peut donc pas s’appliquer à Qwen4-Max.
Des prix inférieurs à ceux de Qwen3.8-Max et d’Opus 5.5
Voici les prix par million de tokens envoyés (entrée) et produits (sortie), affichés le 16 novembre par QwenCloud et Anthropic. Les euros sont calculés au cours de la Banque centrale européenne du 13 novembre 2026.
| Modèle | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| Qwen4-Max (Alibaba) | 1,50 $ (1,36 €) | 0,075 $ (0,07 €) | 4,50 $ (4,07 €) |
| Qwen3.8-Max (Alibaba) | 2 $ (1,81 €) | 0,25 $ (0,23 €) | 6 $ (5,43 €) |
| Claude Opus 5.5 (Anthropic) | 4 $ (3,62 €) | 0,20 $ (0,18 €) | 20 $ (18,10 €) |
Le tarif d’entrée en cache s’applique quand une requête reprend un début de texte déjà envoyé, comme de longues instructions répétées à chaque appel. Pour Qwen4-Max, il baisse de 70 % par rapport à Qwen3.8-Max. Les prix d’Opus 5.5 sont détaillés dans notre guide des modèles Claude.
Une réponse de Qwen4-Max peut compter jusqu’à 393 000 tokens, contre 131 000 pour Qwen3.8-Max. Sa fiche indique en revanche que le traitement par lots (des requêtes groupées, traitées en différé) n’est pas disponible. Qwen3.8-Max le facture moitié prix.
Jusqu’à deux fois moins de tokens, sur les tests d’Alibaba
Sur Work360, un test conçu par Alibaba qui couvre 26 grands domaines professionnels, Qwen4-Max consomme environ 24 % de tokens de moins que Qwen3.8-Max. Ce chiffre vaut au niveau d’effort le plus élevé testé, « Xhigh ». L’effort fixe combien le modèle réfléchit avant de répondre. Au niveau « High » (élevé), la baisse atteint 35 %.
Sur Terminal-Bench 4.0, où le modèle travaille dans un terminal (l’écran où l’on tape des commandes), la baisse atteint environ 48 % au niveau « Xhigh » et 49 % au niveau « High ». Le compte de Qwen sur X en tire un « jusqu’à environ 50 % de tokens en moins » (notre traduction).
Sur Work360, le coût moyen d’une tâche passe de 4,43 à 1,67 dollar (de 4,01 à 1,51 euro), soit 62 % de moins. Ce coût combine la baisse des prix et celle des tokens consommés. Le score monte de 47,74 à 52,69.
Seize tests face à Anthropic, OpenAI et Moonshot
Le même billet compare Qwen4-Max à quatre concurrents : Claude Opus 5.5 (Anthropic), GPT-6.1 Sol et GPT-6 Astra (OpenAI), et Kimi K3.1 (Moonshot AI). Ni Claude Fable 5.2, en tête du classement de la société d’évaluation indépendante Artificial Analysis, ni les modèles Gemini de Google n’y figurent. Face à Qwen3.8-Max, le nouveau modèle progresse sur les 15 tests où l’ancien figure. Selon les notes de bas de page du billet, les scores de sept des seize tests sont repris de classements publics tenus par d’autres, dont Artificial Analysis, Arena et Mercor.
Qwen4-Max obtient le meilleur score sur 4 des 16 tests. Sur DeepSWE, où la programmation est confiée à un agent (une IA qui travaille seule, par étapes), il marque 75,7 contre 74,2 pour Opus 5.5. Il mène aussi, toujours face à Opus 5.5, sur Agents’ Last Exam, sur des tâches longues (46,7 contre 43,4), HLAB-Vals, sur le travail juridique (21,3 contre 9,2), et BioMysteryBench, en bio-informatique (85,0 contre 81,9).
Opus 5.5 fait mieux que Qwen4-Max sur 10 tests sur 16, et deux des trois plus gros écarts portent sur la programmation. Sur ProgramBench, où il faut reproduire un logiciel sans voir son code, il marque 65,0 contre 31,5. Sur Terminal-Bench 4.0, c’est 59,6 contre 48,5, et le meilleur score revient à Kimi K3.1, avec 67,2. Sur Humanity’s Last Exam, un questionnaire de niveau expert, Opus 5.5 marque 59,8, contre 51,7.
Selon Dow Jones Newswires, Alibaba a revendiqué dans un communiqué des classements de premier plan, en particulier en programmation, en tâches d’agent et en raisonnement visuel. Sur le graphique du billet, Qwen4-Max ne mène pourtant que sur un des quatre tests de programmation (DeepSWE, CodeArena, Terminal-Bench 4.0 et ProgramBench). Sur les deux tests de compréhension visuelle, Chartography (lecture de graphiques, 54,2 contre 66,3 pour Opus 5.5) et Video-Index (vidéo), il est derrière les trois modèles d’Anthropic et d’OpenAI.
38e sur 81 au classement d’Artificial Analysis
Artificial Analysis réunit neuf évaluations dans un indice d’intelligence. Dans son classement publié le jour du lancement, Qwen4-Max obtient 43 points et arrive 38e sur 81, juste au-dessus de la médiane des modèles comparables, à 41.
Sur la fiche de Qwen4-Max, qui compare dix modèles de premier plan, il est neuvième. Il est notamment derrière Claude Fable 5.2 (65 points), Claude Opus 5.5 (59), GPT-6.1 Sol (55) et Kimi K3.1 Pro (46), et ne devance que Grok 4.7 (35). Le site autrichien Trending Topics titre que le modèle géant d’Alibaba « reste derrière Claude, GPT et Moonshot AI » (notre traduction).
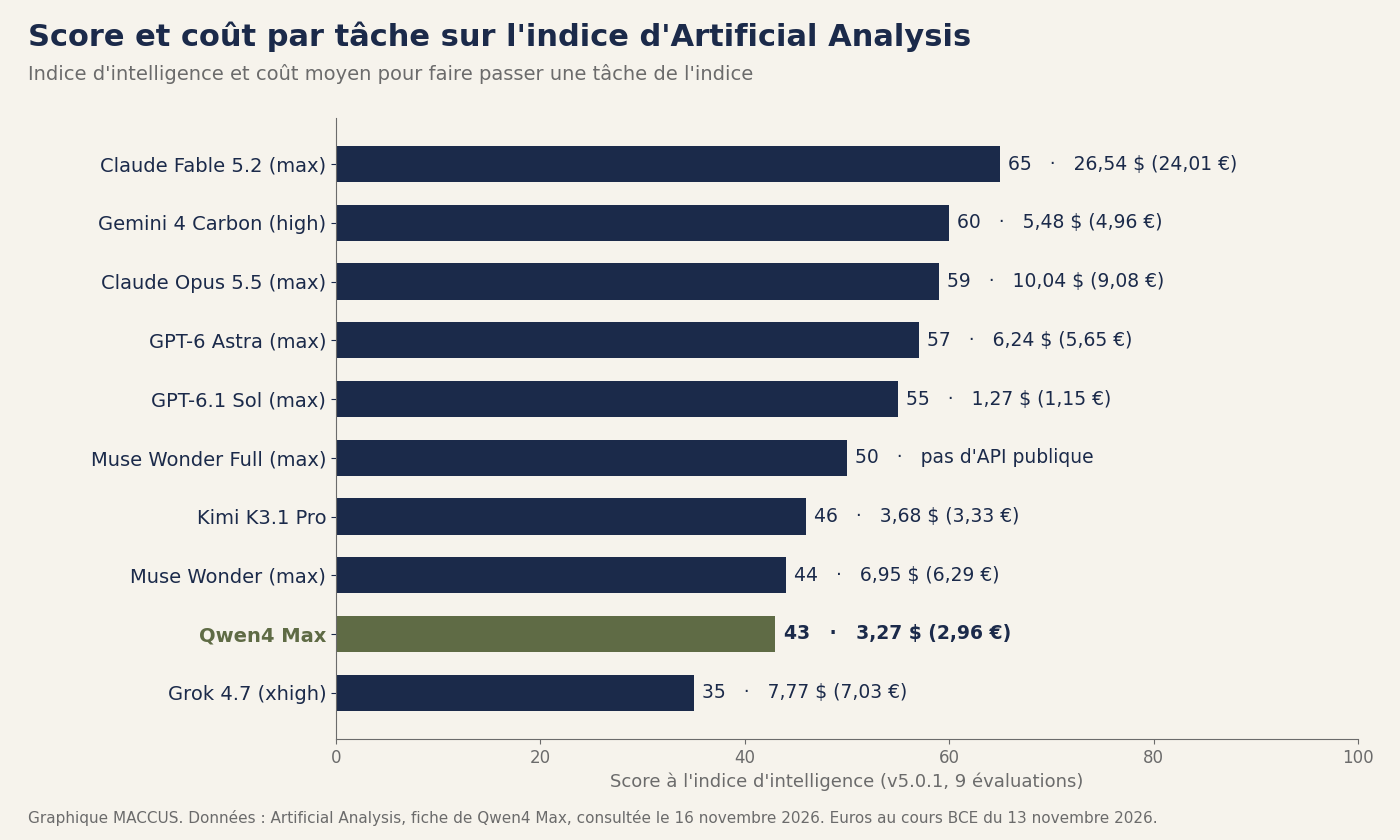
Artificial Analysis mesure aussi le coût moyen d’une tâche de son indice. Pour Qwen4-Max, il est de 3,27 dollars (2,96 euros), contre 10,04 dollars pour Claude Opus 5.5. GPT-6.1 Sol coûte 1,27 dollar par tâche et obtient pourtant 12 points de plus.
Qwen4-Max a produit 127 millions de tokens pour passer l’indice, contre une médiane de 78,6 millions. Artificial Analysis le classe parmi les modèles « très verbeux » (notre traduction). Un modèle plus bavard perd une partie de l’avantage de son prix au token.
Le coût par tâche est devenu un argument de lancement. Le 9 novembre, Meta l’a mis en avant pour son modèle Muse Ember, qu’il dit aussi efficace que Claude Haiku 5.5 pour environ un tiers du coût par tâche.
Les chiffres d’Alibaba et leurs limites
Les exemples d’utilisation du billet sont présentés par l’entreprise, sans vérification indépendante. Dans des usines de SANF et Pacific Union, deux entreprises de l’automobile, le travail manuel pour programmer l’usinage d’une pièce serait passé d’environ 475 à 24 minutes.
Les résultats de sécurité viennent aussi d’Alibaba. Sur le test Last Secure Code Bench, la part de fonctions (des blocs de code) correctes et sûres passe de 22,0 % pour Qwen3.8-Max à 31,8 %. Les propres experts en sécurité d’Alibaba disent n’avoir observé « aucune capacité présentant des risques de cybersécurité à grande échelle » (notre traduction).
Des poids ouverts, téléchargeables par tous, sont promis pour plus tard et pour d’autres modèles. Selon le compte de Qwen sur X, ceux de modèles Qwen4 plus petits « seront publiés », sans date, taille ni licence. Trending Topics note qu’Alibaba réserve ses modèles Max à son propre service en ligne depuis Qwen2.5-Max.
Côté hébergement, la fiche de QwenCloud s’affiche pour sa région de Singapour, et ni la fiche ni le billet ne mentionnent de serveurs en Europe.
Notre analyse
Alibaba mise d’abord sur le prix. Le token de Qwen4-Max coûte un quart de moins que celui de son prédécesseur, et nettement moins que celui d’Opus 5.5. Ses gains d’efficacité ne sont mesurés que face à Qwen3.8-Max, sur des tests choisis par Alibaba.
Face aux concurrents, les propres données de l’entreprise sont moins flatteuses. Qwen4-Max ne finit premier que sur 4 tests sur 16, et reste derrière Opus 5.5 dans la plupart des tests de programmation et de vision. L’indice indépendant d’Artificial Analysis le place au milieu du peloton.
Le prix au token et le coût d’une tâche sont deux mesures différentes. Sur l’indice d’Artificial Analysis, Qwen4-Max coûte environ trois fois moins qu’Opus 5.5 par tâche, pour 16 points de moins. Il revient en revanche plus de deux fois plus cher par tâche que GPT-6.1 Sol, pourtant mieux classé.
Le lancement concerne d’abord les entreprises qui paient l’IA à l’usage, par API, et que l’absence de serveurs annoncés en Europe ne gêne pas. Pour celles qui veulent faire tourner un modèle chez elles, comme Revolut, Qwen4-Max n’est pas une option. Seuls les petits modèles Qwen4 promis en poids ouverts pourraient l’être.
Restent à suivre des résultats indépendants en programmation et l’éventuelle ouverture de serveurs européens pour Qwen4-Max. Pour les petits modèles Qwen4 ouverts, il faudra connaître la date, la taille et la licence.
Sources
- Qwen4-Max: Your New Teammate Has Arrived, équipe Qwen (Alibaba), 16 novembre 2026
- Annonce de Qwen4-Max, compte Qwen (@Alibaba_Qwen) sur X, 16 novembre 2026
- Qwen4-Max, fiche du modèle et tarifs, QwenCloud, consultée le 16 novembre 2026
- Qwen3.8-Max, fiche du modèle et tarifs, QwenCloud, consultée le 16 novembre 2026
- Qwen4 Max: Intelligence, Performance & Price Analysis, Artificial Analysis, consultée le 16 novembre 2026
- Pricing, Anthropic, consultée le 16 novembre 2026
- Alibaba Unveils AI Model With Stronger Performance at Lower Cost, Dow Jones Newswires (Tracy Qu), 16 novembre 2026
- Alibaba’s Giant Qwen4-Max Model Trails Claude, GPT and Moonshot AI, Trending Topics, 16 novembre 2026
Image d’en-tête : graphique MACCUS. Données : Alibaba (équipe Qwen), billet du 16 novembre 2026