Le 9 novembre 2026, Meta a lancé Muse Ember, qu’il présente comme le plus petit et le plus efficace de ses modèles d’IA. Pour les requêtes courtes, il coûte le même prix que les petits modèles d’Anthropic et d’OpenAI, Claude Haiku 5.5 et GPT-6 Luna. Meta affirme pourtant qu’Ember atteint le meilleur score de Haiku 5.5 pour environ un tiers du coût par tâche, et qu’il offre plus de performance par dollar que Luna à tous les réglages de celui-ci.
Ces chiffres viennent de l’indice d’Artificial Analysis, une société qui évalue les modèles d’IA. À tarif par token égal, l’écart se joue sur la facture totale de chaque tâche.
Un token, ou jeton, est un fragment de mot : c’est l’unité dans laquelle les modèles d’IA comptent et facturent le texte. Ember est accessible par l’API de Meta, l’interface qui permet aux développeurs de brancher ses modèles dans leurs logiciels. Il y coûte 0,10 dollar par million de tokens envoyés et 0,50 dollar par million de tokens produits. Cela fait environ 0,09 € et 0,45 € au cours de la Banque centrale européenne (BCE) du 9 novembre 2026, où 1 € valait 1,1193 $.
Meta Superintelligence Labs, un laboratoire de Meta, a conçu Ember pour les agents IA, des programmes qui enchaînent seuls des actions. Meta le présente comme l’exécutant de Muse Wonder, son modèle haut de gamme lancé le 12 octobre. Il résume la répartition ainsi : « Muse Wonder planifie, Muse Ember se charge du volume. »
Un modèle pour les petites tâches répétées
Meta le destine à ce que ces agents répètent toute la journée : appeler des outils logiciels, traiter des sous-tâches de code, aiguiller des demandes, extraire des données, lire de longs documents. Dans son exemple, Ember classe un ticket de support client en facturation, bug ou demande de fonctionnalité.
Dans ce schéma, un modèle plus gros découpe le travail et confie chaque morceau à un sous-agent, un agent secondaire chargé de cette seule partie. Notre guide sur l’organisation d’un travail entre plusieurs agents décrit ce fonctionnement.
La documentation de Meta explique aussi comment brancher ses modèles dans Claude Code, l’outil de programmation d’Anthropic, à la place des modèles maison. Muse Wonder y remplace Opus. Muse Spark, le modèle intermédiaire de Meta, y remplace Sonnet. Muse Ember prend la place de Haiku et sert aussi de modèle aux sous-agents.
Le modèle lit du texte, des images, de l’audio, de la vidéo et des PDF, et répond en texte. Sa fenêtre de contexte, la quantité de texte qu’il peut traiter en une fois, atteint un million de tokens. Six niveaux de raisonnement règlent combien il réfléchit avant de répondre, de « minimal » à « max », le réglage par défaut. Selon Meta, c’est le premier modèle entraîné à l’aide de Muse Wonder Full, la version haut de gamme de Wonder.
Les tarifs face à Haiku 5.5 et GPT-6 Luna
Les tarifs distinguent l’entrée, le texte envoyé au modèle, et la sortie, le texte qu’il produit. Pour les requêtes courtes, les trois modèles facturent l’une et l’autre au même prix. Chacun passe à un tarif plus élevé au-delà d’une certaine longueur de requête, un seuil qui varie d’un éditeur à l’autre.
| Modèle | Entrée | Entrée en cache | Sortie | Tarif plus élevé au-delà de |
|---|---|---|---|---|
| Muse Ember (Meta) | 0,10 $ (0,09 €) | 0,004 $ (0,004 €) | 0,50 $ (0,45 €) | 200 000 tokens |
| Claude Haiku 5.5 (Anthropic) | 0,10 $ (0,09 €) | 0,01 $ (0,009 €) | 0,50 $ (0,45 €) | 100 000 tokens |
| GPT-6 Luna (OpenAI) | 0,10 $ (0,09 €) | 0,01 $ (0,009 €) | 0,50 $ (0,45 €) | 272 000 tokens |
Prix par million de tokens, hors TVA, pour les requêtes sous le seuil. Sources : grilles de Meta et d’Anthropic, relevé du développeur Simon Willison du 10 novembre 2026 pour GPT-6 Luna. Conversion au cours de la BCE du 9 novembre 2026.
L’entrée « en cache » correspond aux instructions réutilisées d’une requête à l’autre, comme le mode d’emploi fixe d’une automatisation. Meta la facture deux fois et demie moins cher que ses deux concurrents.
Sur les longues requêtes, Ember se place entre ses deux concurrents, selon le relevé de Simon Willison. Au-delà de 200 000 tokens envoyés, il passe à 0,30 dollar par million de tokens en entrée et 1,50 dollar en sortie, soit environ 0,27 € et 1,34 €. Toute la requête est alors facturée à ce tarif.
Haiku 5.5 passe à 0,50 et 2,50 dollars au-delà de 100 000 tokens. Pour Luna, Simon Willison, qui suit les modèles de langage sur son blog, relève 0,20 et 0,75 dollar au-delà de 272 000 tokens.
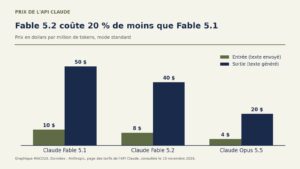
Haiku 5.5 a adopté son tarif de 0,10 et 0,50 dollar le 7 octobre, en coûtant 90 % de moins que Haiku 4.5 pour les requêtes courtes. À l’autre bout de la gamme, Claude Fable 5.2, lancé par Anthropic le même 9 novembre, coûte 8 dollars en entrée et 40 dollars en sortie par million de tokens. C’est 80 fois le prix d’Ember, note Simon Willison.
Le coût par tâche, l’argument central de Meta
Artificial Analysis soumet les modèles à neuf évaluations et en tire une note globale, son indice d’intelligence. La société calcule aussi le coût moyen d’une tâche de ces évaluations, au prix public de chaque modèle. Meta a repris ces résultats, publiés le 9 novembre, pour plusieurs niveaux de raisonnement : deux pour Ember, quatre pour Haiku 5.5 et trois pour Luna.
Au réglage maximal, Ember et Haiku 5.5 sont à égalité une fois les scores arrondis : 36 points chacun, contre 28 pour Luna. Avant arrondi, Ember obtient 35,8 points pour 0,136 dollar par tâche (environ 0,12 €). Haiku 5.5 obtient 36,2 points pour 0,411 dollar (environ 0,37 €) : il coûte trois fois plus cher par tâche pour 0,4 point de plus. GPT-6 Luna plafonne à 27,8 points pour 0,152 dollar.
À tarif par token égal, l’écart de coût par tâche dépend de ce que chaque modèle consomme : un modèle qui raisonne plus longtemps avant de répondre coûte plus cher. Le cache moins cher d’Ember peut aussi jouer, tout comme son seuil de longue requête, fixé à 200 000 tokens contre 100 000 pour Haiku. Ni Meta ni Artificial Analysis ne détaillent la part de chaque facteur.
La fiche qu’Artificial Analysis consacre au modèle confirme les chiffres repris par Meta : 36 points et 0,14 dollar par tâche. Elle indique aussi qu’Ember met 3,2 minutes par tâche, contre une médiane de 7,5 minutes pour les modèles comparables. Elle le juge en revanche « assez verbeux » : il a produit 115 millions de tokens pour passer l’indice, contre une médiane de 90 millions.
Dans son annonce, Meta compare aussi Ember à Muse Spark 1.3 sur l’indice d’Artificial Analysis : Spark obtient un point de plus, 37 contre 36, mais coûte 2,39 dollars par tâche, contre 0,14 dollar pour Ember.
Les résultats publiés par Meta
Le tableau de résultats de Meta reprend plusieurs tests d’Artificial Analysis, tous au réglage maximal. Ember y mène nettement sur AutomationBench-AA, qui simule des processus d’entreprise de bout en bout. Son taux de réussite y atteint 37,8 %, contre 20,2 % pour Luna et 13,9 % pour Haiku 5.5. Sur l’indice consacré aux agents de programmation, il obtient 46 points, contre 37 pour Haiku et 31 pour Luna.
Haiku 5.5 l’emporte en revanche sur FrontierCode 2.0, avec 34,9 % contre 27,2 % pour Ember. Ce test juge si du code écrit sur de vrais projets pourrait y être intégré. Sur GDP.pdf, un test de travail professionnel sur de longs documents, Ember et Luna font jeu égal à 22,8 %, devant Haiku à 20,8 %.
Sur les quatre tests menés par Meta lui-même, Ember devance ses deux concurrents. L’écart est mince sur OSWorld 2.1, qui mesure la capacité à se servir d’un ordinateur : 69,5 % contre 68,9 % pour Haiku. Ce score accorde un crédit partiel : une tâche réussie en partie rapporte déjà des points.
Terminal-Bench 4.0 évalue la programmation en ligne de commande, où l’on pilote l’ordinateur en tapant des instructions. Ember y obtient 40,9 %, contre 39,2 % pour Haiku et 16,4 % pour Luna. Meta y retient pour chaque modèle le logiciel qui donne son meilleur résultat publié, différent à chaque fois : mini-swe-agent pour Ember, Claude Code pour Haiku et Codex, l’outil de programmation d’OpenAI, pour Luna.
Les premiers essais hors de Meta
Meta cite cinq entreprises qui ont testé le modèle avant sa sortie. Chez Cloudflare, fournisseur d’infrastructure web, le directeur technique Dane Knecht dit qu’Ember a été jusqu’à 30 % plus rapide sur les requêtes les plus lentes. La comparaison porte sur « le modèle comparable » testé par l’entreprise, qu’il ne nomme pas.
Chez You.com, un moteur de recherche fondé sur l’IA, Chak Pothina est responsable de l’inférence, l’étape où le modèle calcule ses réponses. Selon lui, 95 % des requêtes ont reçu une réponse en 2,2 secondes au plus. Il décrit Ember comme environ 4 à 13 fois plus rapide que les principaux modèles à poids ouverts, avec 36 à 48 % de tokens produits en moins. Les poids sont les paramètres d’un modèle : publiés, ils permettent à chacun de le faire tourner chez soi.
Simon Willison a fait dessiner à Ember un pélican à vélo à chacun des six niveaux de raisonnement. Monter le niveau n’améliorait pas nettement le dessin. Il juge pourtant la qualité comparable à celle de Muse Wonder, qui coûte 40 fois plus cher.
Disponibilité et usage des données
Muse Ember est disponible depuis le 9 novembre dans l’API de Meta et dans Muse Code, l’outil de programmation de Meta, sous l’identifiant muse-ember-1.0. Meta annonce aussi Ember, Spark et Wonder sur les plateformes Google Cloud et Oracle Cloud. Le modèle reste fermé : Meta n’en a pas publié les poids, contrairement à Muse Spark Open, dont les poids sont publics depuis le 15 octobre.
Sur l’API, Muse Ember fonctionne uniquement en mode Standard. Selon la grille de Meta, les contenus envoyés dans ce mode ne servent pas à entraîner ses modèles. Le mode Contributor, qui accorde une remise en échange de ce droit d’entraînement, n’existe pas pour Ember sur l’API.
Dans un abonnement Muse Code, la politique de Meta applique toutefois le mode Contributor par défaut, quel que soit le modèle choisi. Ce réglage se change dans le compte.
La politique d’usage géographique de l’API, qui liste les territoires exclus, a été mise à jour le 12 octobre. Elle ne compte ni la France ni la Belgique parmi ces territoires. Elle précise que le service n’est pas ouvert partout et ne mentionne pas Muse Ember.
Les réserves de l’annonce
L’annonce de Meta comporte elle-même plusieurs limites. La légende de son graphique qualifie les coûts d’Ember d’« estimations au prix proposé ». La mention de source du même graphique et la note de bas de page parlent pourtant de prix public. Le graphique ne dit donc pas clairement sur quel prix reposent ses coûts.
Quatre des dix lignes du tableau de résultats viennent des tests internes de Meta. Les témoignages de partenaires portent eux aussi sur des essais retenus par Meta.
Dans le volet sécurité de l’annonce, Meta indique qu’Ember reste sous les seuils de risque élevé de son cadre d’évaluation. Ces seuils portent sur les risques chimiques et biologiques, la cybersécurité et la perte de contrôle. Meta dit aussi avoir testé la résistance du modèle aux instructions cachées dans des pages web ou des documents, sans publier de chiffres.
Notre analyse
Avec Muse Ember, trois grands éditeurs vendent désormais un petit modèle au même prix par token pour les requêtes courtes. La concurrence entre eux se joue donc ailleurs : le nombre de tokens qu’il faut pour finir une tâche, le prix du cache et le seuil à partir duquel une longue requête coûte plus cher. OpenAI avait déjà mis en avant le coût par tâche le 26 octobre, en présentant GPT-6.1 Terra comme environ neuf fois moins cher par tâche que Claude Opus 5.5 sur l’un de ses tests.
Le changement concerne d’abord les entreprises qui font tourner des agents par l’API : selon Meta, un agent dépense l’essentiel de ses tokens en nombreuses petites étapes structurées. La fiche indépendante d’Artificial Analysis confirme le score d’Ember et son coût de 0,14 dollar par tâche. Le reste de l’avance affichée repose sur une sélection de tests faite par Meta, dont quatre menés en interne.
Trois points ne sont pas encore établis : l’accès réel depuis la France et la Belgique, le comportement du modèle en français et ses résultats à des tests indépendants autres que ceux d’Artificial Analysis. Sur le français, l’annonce ne donne aucun chiffre. Meta écrit avoir « des modèles encore plus efficaces en entraînement ». Il reste à voir si Anthropic et OpenAI répondront par le prix ou par la consommation de tokens.
Sources
- Introducing Our Smallest, Most Efficient Model: Muse Ember, Meta, 9 novembre 2026
- Muse Ember, documentation de Meta Model API, consultée le 10 novembre 2026
- Choose a model, documentation de Meta Model API, consultée le 10 novembre 2026
- Pricing and rate limits, documentation de Meta Model API, consultée le 10 novembre 2026
- Meta Model API Model Designation and Geographic Use Policy, Meta, 12 octobre 2026
- Muse Ember (Max) Intelligence, Performance & Price Analysis, Artificial Analysis, consultée le 10 novembre 2026
- Pricing, Anthropic, consultée le 10 novembre 2026
- Introducing Our Smallest, Most Efficient Model: Muse Ember, Simon Willison’s Weblog, 10 novembre 2026
Image d’en-tête : graphique MACCUS. Données : Meta, annonce de Muse Ember, 9 novembre 2026, d’après les résultats d’Artificial Analysis