Les nouvelles politiques d’utilisation d’OpenAI, l’éditeur de ChatGPT, sont entrées en vigueur le 20 novembre 2026. Elles interdisent d’utiliser ses modèles d’intelligence artificielle (IA), ou leurs réponses, pour préparer, noter ou trier les données d’entraînement d’un modèle conçu pour remplacer les siens. L’interdiction vaut même pour qui n’entraîne pas ce modèle lui-même. Les plateformes qui donnent à des tiers un accès direct aux modèles d’OpenAI doivent aussi obtenir son accord préalable.
Le même jour, OpenAI a publié un billet sur la « distillation adversariale », la copie d’un modèle à partir de ses réponses, sans autorisation. Selon ses tests internes, une attaque visant le raisonnement caché de ses modèles réussissait 54 % du temps sur GPT-6 Astra avec ses anciennes protections, contre 0,2 % sur le nouveau GPT-6.2 Astra. L’entreprise dit aussi sanctionner chaque semaine jusqu’à quelques dizaines de milliers de comptes.
Une nouvelle section sur l’entraînement des modèles
La version précédente des politiques, du 29 octobre 2025, ne contenait aucune section sur l’entraînement d’autres modèles. Un autre document, les conditions d’utilisation, interdisait déjà en une ligne d’utiliser les résultats des modèles d’OpenAI pour développer des modèles concurrents. OpenAI avait annoncé la mise à jour le 21 octobre 2026, dans un billet intitulé « Un accès élargi grâce à des normes cohérentes ».
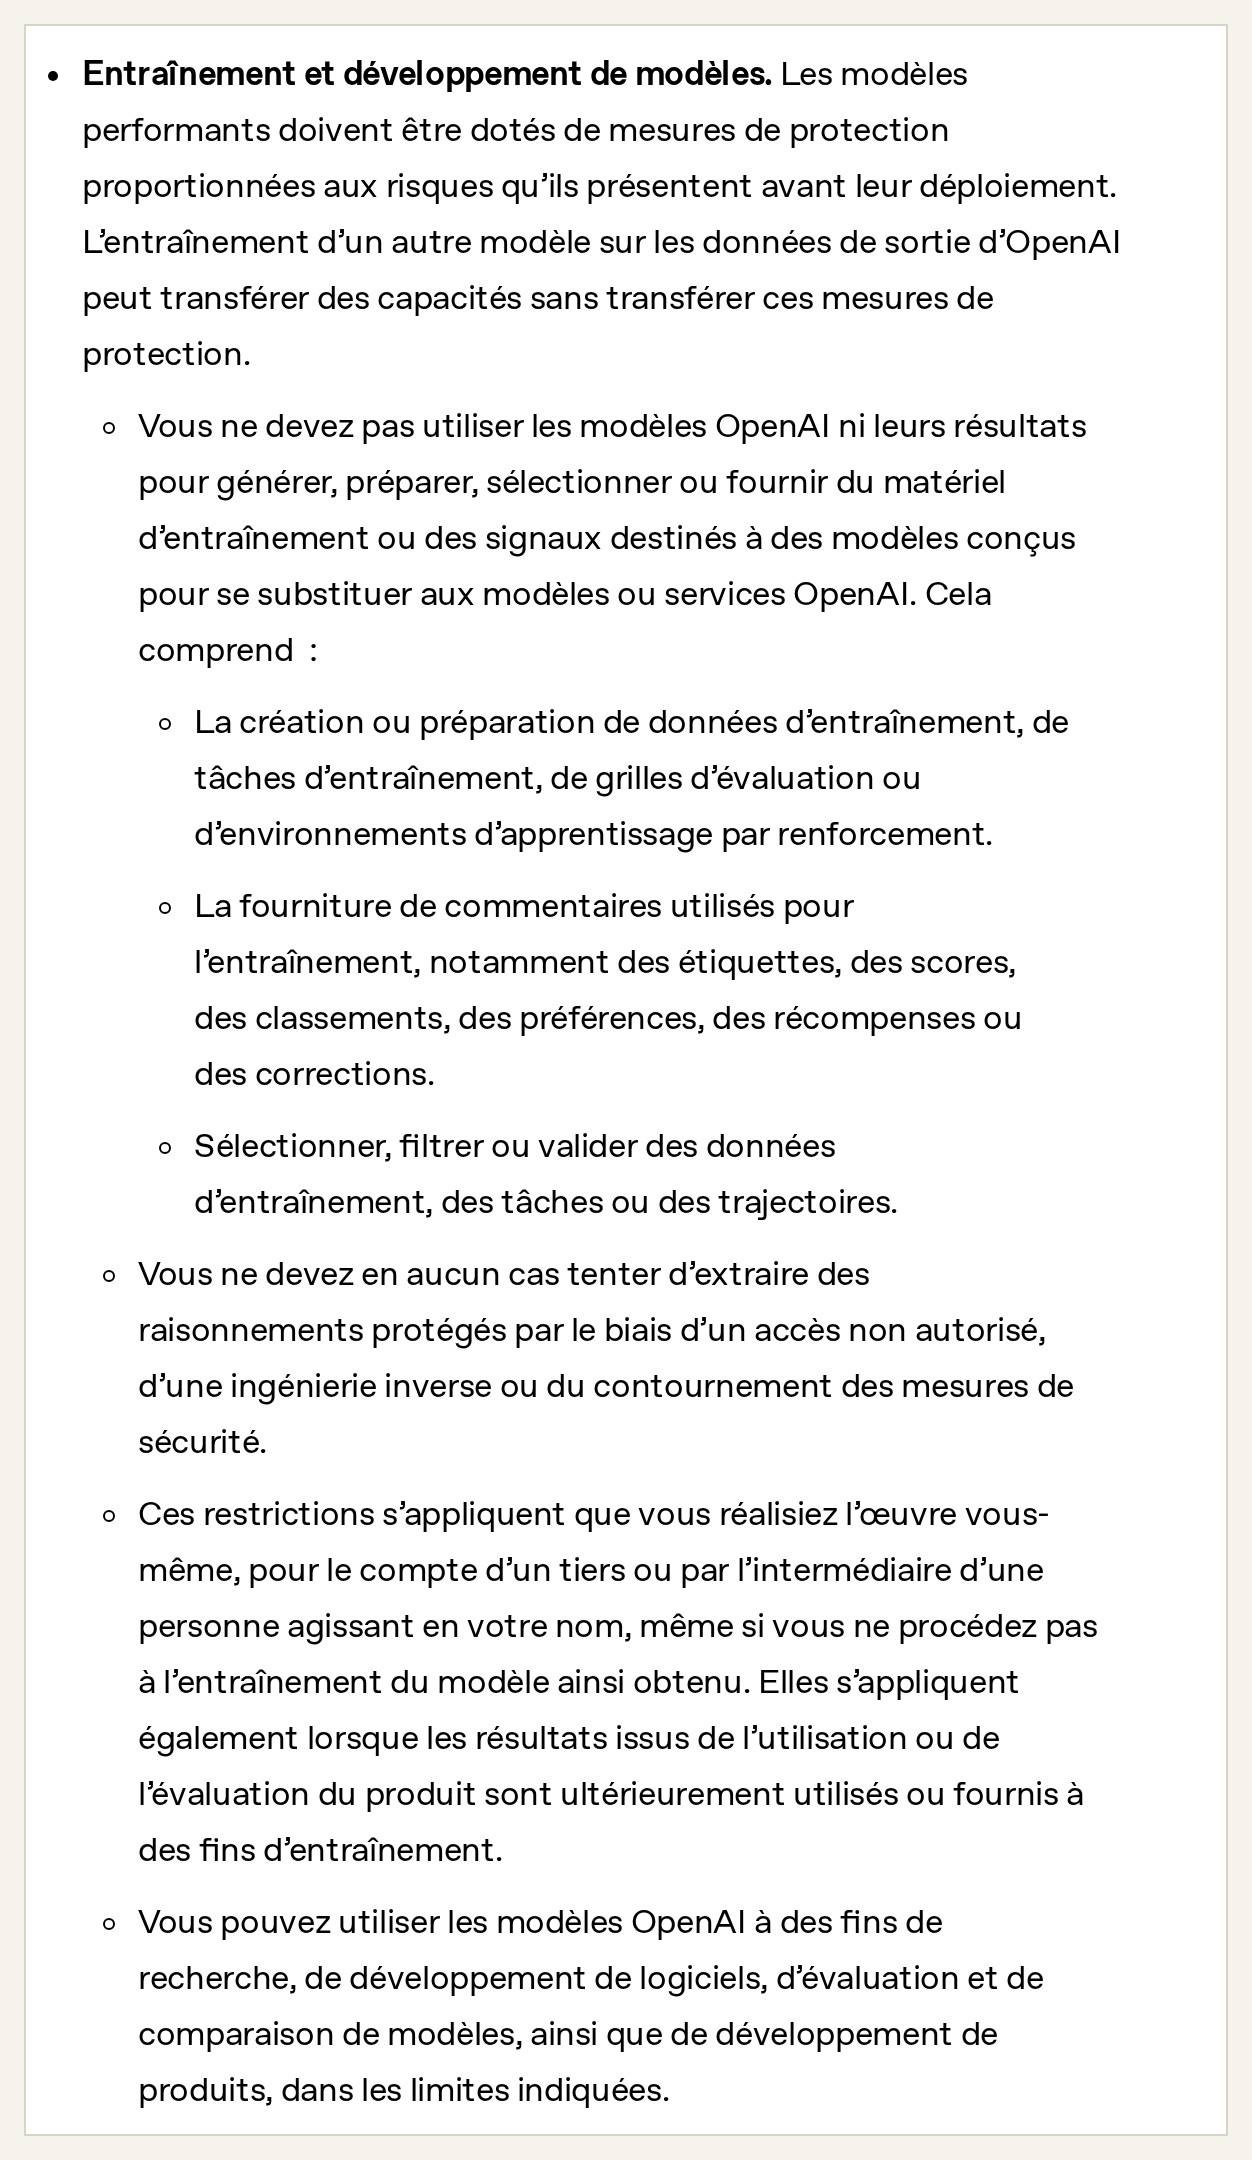
La nouvelle section s’intitule « Entraînement et développement de modèles ». Elle interdit d’utiliser les modèles d’OpenAI ou leurs résultats pour « générer, préparer, sélectionner ou fournir du matériel d’entraînement ou des signaux ». La règle porte sur les modèles « conçus pour se substituer aux modèles ou services OpenAI ».
Le texte vise la création de données d’entraînement, de grilles d’évaluation ou d’environnements d’apprentissage par renforcement, des exercices où un modèle apprend par récompenses. Il vise aussi les étiquettes, scores, classements et préférences fournis pour l’entraînement, ainsi que le tri et le filtrage des données.
La règle s’applique aussi au travail fait pour le compte d’un tiers, ou confié à quelqu’un qui agit au nom de l’utilisateur. Elle vise enfin les résultats d’un usage normal ou d’une évaluation, s’ils servent plus tard à entraîner un tel modèle.
Le texte autorise, « dans les limites indiquées », la recherche, le développement de logiciels et de produits, ainsi que l’évaluation et la comparaison de modèles. Le contrat applicable avec OpenAI peut aussi prévoir des exceptions.
Les plateformes d’accès soumises à approbation
Les politiques ajoutent une règle pour les plateformes intermédiaires entre OpenAI et les utilisateurs de ses modèles. Leurs exploitants doivent obtenir « au préalable notre examen et notre approbation » pour laisser des tiers utiliser directement ces modèles. Le billet du 21 octobre cite les routeurs de modèles et les passerelles IA, des services qui donnent accès à plusieurs modèles par une seule interface. Le seul fait d’intégrer les modèles d’OpenAI dans une application, pour ses propres fonctions, ne suffit pas à la soumettre à cette règle.
Les pages d’OpenAI consultées le 21 novembre ne donnent ni liste des services approuvés, ni procédure de demande. Le billet du 21 octobre indique seulement que ces partenaires doivent maintenir des protections cohérentes avec celles d’OpenAI, enquêter sur les violations potentielles, prendre les mesures appropriées et coordonner l’application des règles. Le 21 novembre à 1 h 14 (heure de Paris), le catalogue public d’OpenRouter, l’un de ces routeurs, affichait GPT-6.2 Astra et GPT-6.2 Sol, les deux modèles sortis le 17 novembre.
Chez Anthropic, l’éditeur de Claude, une règle voisine est entrée en vigueur le 12 novembre. Sa nouvelle politique d’utilisation interdit de revendre ou de fournir l’accès à Claude par des moyens non autorisés, comme des services qui font passer les demandes par des abonnements grand public. Elle interdit aussi d’entraîner un modèle d’IA, quel qu’il soit, avec les résultats de Claude sans autorisation préalable.
Une interdiction élargie aux actions à haut risque
La version de 2025 des politiques interdisait d’automatiser sans vérification humaine les décisions à fort enjeu (« high-stakes decisions » dans le texte anglais) dans des domaines sensibles. Le nouveau texte remplace les décisions par les actions : la version française parle d’« automatisation des actions à haut risque ».
Ces actions incluent les décisions, transactions, soumissions et autres démarches qui affectent de manière significative une personne : ses droits, sa sécurité, son accès aux services essentiels ou d’autres intérêts importants. La liste des domaines sensibles change peu : elle cite notamment l’emploi, le logement, le crédit, l’assurance, le juridique et le médical.
Contre la distillation, OpenAI protège le raisonnement de ses modèles
Le billet du 20 novembre porte sur la distillation, une technique courante où un modèle apprend à partir des réponses d’un autre. OpenAI la dit « adversariale » quand elle se fait sans autorisation, pour reproduire un modèle sans ses protections. L’entreprise prend l’exemple de la cybersécurité : un modèle copié pourrait aider à mener une attaque que l’original aurait refusée. Les nouvelles politiques interdisent d’ailleurs de « tenter d’extraire des raisonnements protégés », par un accès non autorisé, par ingénierie inverse ou en contournant les protections.
OpenAI dit protéger en priorité le raisonnement de ses modèles : les étapes intermédiaires qu’un modèle produit avant de répondre, que l’utilisateur ne voit pas en entier. Selon OpenAI, ces traces de raisonnement peuvent contenir des informations absentes de la réponse finale, ce qui en fait des données d’entraînement précieuses.
OpenAI décrit une étude interne sur la cybersécurité. Un modèle nourri des traces exactes y faisait en général mieux qu’un modèle qui n’avait vu que ce que voit un utilisateur. Après une phase d’apprentissage par renforcement, cet avantage ne restait qu’avec la plus grande quantité de calcul testée pour répondre. Avec moins de calcul, le modèle privé des traces faisait mieux.
OpenAI a testé ses protections avec six modèles d’IA attaquants, qui adaptent leur méthode et ne voient que ce que voit un utilisateur extérieur. Sur GPT-6 Astra et ses anciennes protections, l’extraction du raisonnement d’une demande précédente réussissait en moyenne dans 54,0 % des cas, contre 0,2 % sur GPT-6.2 Astra. Pour le raisonnement de la demande en cours, le taux passe de 22,9 % à 0,9 %. OpenAI dit appliquer une partie de ces protections à GPT-6 Astra.
Un raisonnement effacé quand l’historique change
Plusieurs de ces protections touchent les développeurs qui passent par l’API, l’interface qui permet à un logiciel d’utiliser les modèles d’OpenAI. Avec GPT-6.2 Astra et Sol, le raisonnement reste lié à l’historique de la conversation qui l’a produit. Si un message antérieur est réécrit, l’API supprime le raisonnement qui suivait. Les familles de modèles plus anciennes, moins protégées, ne peuvent plus lire le raisonnement protégé de GPT-6.2.
Selon la documentation d’OpenAI, l’historique change aussi quand on raccourcit d’anciennes données renvoyées par un outil, qu’on réécrit les consignes du développeur ou qu’on résume d’anciens échanges. Le modèle peut alors devoir refaire une partie de son raisonnement. Cela peut augmenter le nombre de jetons consommés (les unités de texte facturées), le coût et le temps de réponse, et parfois faire baisser la qualité. La fonction de compression de contexte d’OpenAI conserve en revanche ce raisonnement.
Des filtres automatiques, appelés classificateurs, repèrent aussi les tentatives d’extraction. D’autres peuvent bloquer les fuites présumées de raisonnement dans les réponses du modèle et dans ses appels d’outils. OpenAI dit avoir fermé une voie qui pouvait exposer le raisonnement chiffré d’un autre utilisateur.
Des réseaux de comptes sanctionnés chaque semaine
OpenAI dit avoir repéré plusieurs campagnes de distillation non autorisées sur sa plateforme cette année. Ses sanctions hebdomadaires ont visé de quelques milliers à quelques dizaines de milliers de comptes, avec une forte hausse l’été dernier. En février, OpenAI a informé le Congrès américain d’une activité indiquant que DeepSeek, un éditeur chinois d’IA, tentait de distiller des modèles américains.
Le 30 septembre, OpenAI a décrit une campagne commencée le 1er juillet : les 24 et 25 juillet, plus de 4 000 utilisateurs y ont envoyé 16 000 requêtes. OpenAI l’a arrêtée le 28 juillet, après avoir relié l’activité à un groupe de plus de 15 000 utilisateurs. L’entreprise attribue une partie centrale de cette activité à des personnes liées à Moonshot AI, l’éditeur des modèles Kimi. Ces chiffres décrivent des tentatives, réussies ou non, précise OpenAI.
Des chiffres mesurés par OpenAI elle-même
Les taux de réussite des attaques viennent d’une évaluation interne. OpenAI ne publie ni les attaques utilisées, ni de résultats de tests menés par des chercheurs extérieurs. Son tableau ne donne aucun chiffre pour GPT-6.2 Sol. Le nombre de comptes sanctionnés est donné en fourchette hebdomadaire, sans total ni répartition par pays.
L’attribution d’une partie centrale de l’activité à Moonshot AI repose sur l’enquête d’OpenAI, dont le billet de septembre ne publie pas les éléments techniques. Ce même billet reconnaît qu’il n’est pas certain que tous les opérateurs observés dépendent d’un seul acteur.
Les politiques laissent aussi une question ouverte : elles visent les modèles « conçus pour se substituer aux modèles ou services OpenAI », sans dire où commence cette substitution.
La portée de l’annonce
La règle sur l’entraînement change surtout d’échelle : une interdiction d’une ligne, dans les conditions d’utilisation, devient une liste de tâches précises. Noter des réponses, les classer ou trier des données reste permis pour évaluer ou comparer des modèles. Ces travaux deviennent interdits quand ils servent à entraîner un modèle destiné à remplacer ceux d’OpenAI, sauf exception prévue au contrat.
Les entreprises qui accèdent aux modèles GPT par un routeur dépendent désormais de l’approbation de ce service par OpenAI. Réécrire l’historique d’une conversation peut aussi coûter plus cher sur GPT-6.2, pour des réponses plus lentes et parfois moins bonnes.
Plusieurs points restent à suivre : la publication d’une procédure ou d’une liste de plateformes approuvées, les premières sanctions au titre de la nouvelle section, et les détails sur des campagnes de distillation récentes qu’OpenAI dit vouloir partager « bientôt ».
Sources
- Politiques d’utilisation, OpenAI, 20 novembre 2026
- Usage policies (version du 29 octobre 2025), OpenAI, 29 octobre 2025
- Un accès élargi grâce à des normes cohérentes, OpenAI, 21 octobre 2026
- Combatting adversarial distillation, OpenAI, 20 novembre 2026
- Keep the prefix unchanged, OpenAI (documentation de l’API), consultée le 21 novembre 2026
- Déjouer une campagne coordonnée de distillation de modèles, OpenAI, 30 septembre 2026
- Usage Policy, Anthropic, 12 novembre 2026
Image d’en-tête : graphique MACCUS, données d’OpenAI (« Combatting adversarial distillation », 20 novembre 2026)