Du 8 au 10 novembre 2026, chez Prime Intellect, un tiers non autorisé a remplacé un modèle d’IA par une copie modifiée pour réduire ou supprimer ses refus. Pendant 53 heures, des clients ont reçu les réponses de cette copie. Testée ensuite par l’entreprise, elle avait les mêmes scores de compétence que l’original, mais ne refusait presque plus les demandes dangereuses. Prime Intellect, qui entraîne et héberge des modèles d’IA ouverts, a révélé l’incident le 19 novembre dans un avis de sécurité.
Le modèle visé, DeepSeek V4.1 Flash, est un modèle de langage publié en accès libre par l’entreprise DeepSeek. La copie n’avait rien de secret : c’est une version dite « abliterated », dont on a retiré le mécanisme de refus sans réentraîner le modèle. Des dizaines de copies de ce genre sont téléchargeables sur Hugging Face, la principale plateforme de partage de modèles d’IA. L’affaire touche donc les modèles à poids ouverts, dont les fichiers, les « poids », sont publiés et que chacun peut faire tourner sur ses propres machines.
Un modèle remplacé pendant plus de deux jours
Prime Intellect vend l’accès à des modèles ouverts comme GLM, DeepSeek ou Kimi, facturé au volume de texte traité. Ce service s’appelle Prime Inference. Les logiciels des clients l’interrogent de la même façon que le service d’OpenAI, l’éditeur de ChatGPT. L’avis, référencé PI-SA-2026-001, porte sur le point d’accès deepseek/deepseek-v4.1-flash, c’est-à-dire l’entrée par laquelle les clients appellent ce modèle.
Selon l’avis, l’intrus a remplacé « un déploiement » rattaché à ce point d’accès par une copie modifiée du modèle, déjà disponible publiquement. Un déploiement est une installation du modèle sur des serveurs de l’entreprise. La substitution a duré du 8 novembre à 2 h 24 au 10 novembre à 7 h 35, heure de Paris (1 h 24 et 6 h 35 en temps universel). Pendant ces 53 heures et 11 minutes, les requêtes traitées par cette installation ont reçu les réponses de la copie.
L’avis précise que le format des conversations et les réglages du serveur n’ont pas été modifiés. Le tokenizer n’a pas changé non plus : c’est l’outil qui découpe le texte en jetons, les petites unités de texte que le modèle lit et produit. Pour les clients, le nom du modèle et la forme des échanges restaient donc identiques.
Prime Intellect dit avoir contacté tous les clients concernés. À ceux dont l’usage reposait sur les refus du modèle, elle a recommandé de relire les réponses reçues pendant cette période.
Une copie publique parmi des dizaines
DeepSeek a mis le modèle en ligne sur Hugging Face le 10 septembre 2026, sous licence MIT, une licence qui autorise l’usage commercial et la modification. Selon sa fiche de présentation, sa partie principale compte 552 milliards de paramètres, les valeurs numériques réglées pendant l’entraînement. Il peut lire jusqu’à un million de jetons à la fois.
La méthode « abliteration » s’appuie sur les travaux du chercheur Andy Arditi et de ses coauteurs. Dans les modèles de conversation qu’ils ont étudiés, le refus dépend d’un seul motif dans les calculs internes du modèle, qu’ils appellent une « direction ». Si on neutralise cette direction, le modèle cesse de refuser, sans nouvel entraînement.
Les auteurs ont d’abord publié un billet de blog, puis un article mis en ligne le 17 juin 2024 sur arXiv, un site d’articles scientifiques en accès libre. Quatre jours plus tôt, le 13 juin, le chercheur Maxime Labonne avait décrit la technique sous ce nom sur Hugging Face, en citant ce billet.
Le 22 novembre 2026, une recherche sur Hugging Face recensait 67 dépôts publics dont le nom associe « V4.1-Flash » et « abliterated ». La plupart proposent une copie modifiée au téléchargement. Dix-sept sont tirés du modèle de septembre, celui que vise l’avis. Les cinquante autres sont tirés d’une version plus récente, publiée par DeepSeek le 17 octobre.
Le premier de ces dépôts date du 10 septembre 2026 à 10 h 59, temps universel, soit moins de neuf heures après la mise en ligne du modèle par DeepSeek. L’avis de Prime Intellect ne dit pas quelle copie publique a été chargée, ni d’où elle venait.
Les mêmes scores de compétence, presque plus aucun refus
Prime Intellect a ensuite testé les poids modifiés. Sur deux tests de compétence, la copie a obtenu les mêmes résultats que l’original. Le premier, GPQA Diamond, est une série de questions de sciences de haut niveau. Le second, τ-bench, mesure si un modèle sait se servir d’outils logiciels dans des conversations simulées avec des clients.
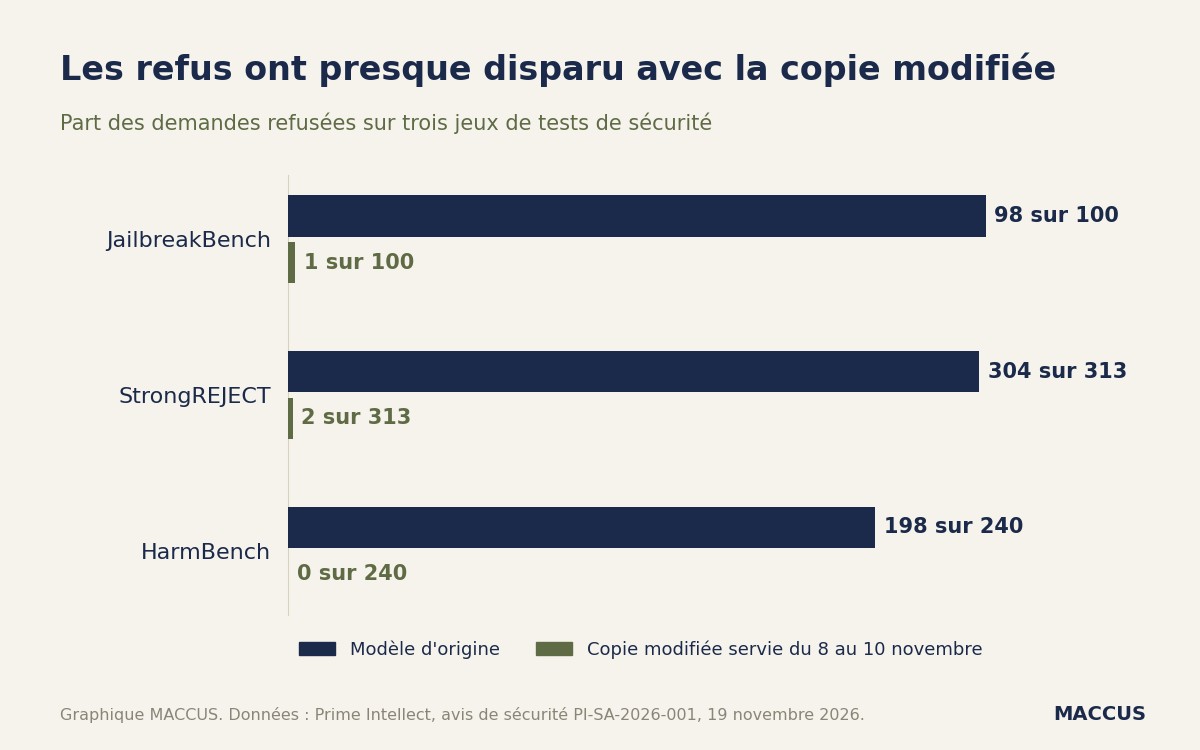
L’entreprise a aussi soumis la copie à trois tests de sécurité, JailbreakBench, StrongREJECT et HarmBench. Ces tests posent au modèle des demandes dangereuses pour vérifier qu’il les refuse. Les refus y ont presque disparu : sur JailbreakBench, l’original refusait 98 demandes sur 100, la copie une seule. Sur StrongREJECT, on passe de 304 refus sur 313 demandes à 2, et sur HarmBench de 198 refus sur 240 à aucun.
Le site d’actualité de l’IA Superpower Daily en tire une leçon dans son compte rendu du 19 novembre. Selon lui, des scores de compétence inchangés ne garantissaient pas que le modèle se comportait de la même façon. Un contrôle limité à ces deux tests de compétence n’aurait donc rien signalé.
Aucune trace de fuite, selon l’entreprise
Prime Intellect dit n’avoir trouvé aucune trace d’enregistrement des requêtes ou des réponses. Elle affirme aussi n’avoir vu aucun signe de leur sortie du groupe de serveurs qui fait tourner ce modèle, ni d’un accès au-delà de ce groupe. Selon l’avis, aucun autre modèle de la plateforme n’a été modifié, et aucune clé d’accès ni aucun identifiant de client n’a été touché.
L’entreprise ajoute que ses points d’accès ne conservent pas les données, un réglage appelé « zero data retention », et n’enregistrent aucune requête. Elle dit avoir récupéré toutes les versions du proxy de l’intrus, un programme qui relaie les requêtes, et examiné les disques et la mémoire de chaque machine concernée. Elle détient aussi des relevés détaillés des sessions de l’intrus, processus par processus. Selon elle, aucune version de ce proxy ne lit ni ne transfère le contenu des requêtes.
L’incident diffère du piratage subi en octobre par Fireworks AI, un autre hébergeur de modèles. En novembre, l’éditeur du logiciel de prise de notes Notion a confirmé que des conversations avec son assistant Notion AI avaient fuité chez Fireworks AI. Chez Prime Intellect, l’intrus a changé le modèle qui répondait, et l’entreprise dit n’avoir trouvé aucune sortie de données.
Les questions laissées ouvertes
L’avis n’explique pas comment l’intrus a obtenu l’accès nécessaire pour changer le modèle. Pour Superpower Daily, c’est la principale limite de ce que l’on sait. L’avis ne donne ni le nombre de requêtes servies par la copie, ni le nombre de clients touchés, ni la façon dont l’échange a été repéré. L’enquête est en cours, et Prime Intellect promet de mettre l’avis à jour si son évaluation change.
Notre analyse
L’incident montre une faiblesse propre aux modèles ouverts utilisés chez un hébergeur et payés à l’usage. Le client choisit un nom de modèle, mais il ne voit jamais le fichier de poids chargé sur le serveur. Les poids d’un modèle fermé ne sont pas publiés : ils restent chez l’éditeur et chez les quelques partenaires qu’il choisit. Ceux d’un modèle ouvert peuvent être chargés par n’importe quel hébergeur, et des copies modifiées circulent librement.
Le nombre d’intermédiaires aggrave le problème. Le 22 novembre 2026, OpenRouter, un service qui aiguille les requêtes vers différents hébergeurs, listait 37 points d’accès chez 28 hébergeurs pour le seul DeepSeek V4.1 Flash. Le même nom de modèle recouvre donc des dizaines d’installations, dont le client ne voit pas les fichiers. La chaîne s’allonge encore : depuis le 16 novembre, Hugging Face confie à OpenRouter l’aiguillage des requêtes que ses clients envoient aux modèles de langage.
Les tests publiés montrent bien que la copie se comportait autrement que l’original. Les assurances sur les données, elles, reposent sur l’enquête interne de l’entreprise, et l’avis ne mentionne aucun audit extérieur. L’autre risque touche les applications qui comptaient sur les refus du modèle. Pendant 53 heures, elles ont pu transmettre des réponses que le modèle d’origine aurait refusées.
Faire tourner les poids soi-même donne un moyen de contrôle qu’un client d’hébergeur n’a pas. Hugging Face publie une empreinte SHA-256 pour chacun des 48 fichiers de poids de DeepSeek V4.1 Flash. Cette empreinte, une suite de caractères calculée à partir du fichier, permet de vérifier qu’un fichier téléchargé est bien celui de DeepSeek. Elle ne protège pas d’un intrus qui prend la main sur le serveur.
Le logiciel qui fait tourner le modèle a aussi ses failles. Le projet vLLM, un logiciel libre qui fait tourner des modèles, a publié 58 avis de sécurité entre le 1er septembre et le 16 novembre. L’avis de Prime Intellect ne dit pas quel logiciel l’entreprise utilise.
Deux réponses manquent encore à l’avis : comment l’intrus est entré, et combien de clients ont reçu les réponses de la copie. Reste à savoir si d’autres hébergeurs de modèles ouverts vérifient les poids qu’ils servent, et s’ils le diront à leurs clients.
Sources
- Notice regarding deepseek/deepseek-v4.1-flash, 8 to 10 November 2026, Prime Intellect, 19 novembre 2026
- Prime Inference, Prime Intellect, consulté le 22 novembre 2026
- DeepSeek-V4.1-Flash, DeepSeek sur Hugging Face, 10 septembre 2026
- Recherche « DeepSeek-V4.1-Flash-abliterated », Hugging Face, consultée le 22 novembre 2026
- Refusal in Language Models Is Mediated by a Single Direction, Andy Arditi et al., arXiv, 17 juin 2024
- Uncensor any LLM with abliteration, Maxime Labonne, Hugging Face, 13 juin 2024
- Prime Intellect discloses unauthorized DeepSeek model swap that sharply reduced refusals, Superpower Daily, 19 novembre 2026
- DeepSeek: DeepSeek V4.1 Flash, providers, OpenRouter, consulté le 22 novembre 2026