
Une IA locale est un modèle de langage installé sur un ordinateur de votre cabinet ou de votre entreprise. Vos courriers, vos contrats et vos notes sont traités sur cette machine et ne partent chez aucun fournisseur. Au 10 octobre 2026, un Mac mini à 1 709 € TTC (32 Go de mémoire) fait tourner un modèle ouvert de taille moyenne pour une petite équipe ; pour des modèles plus gros ou plus de personnes, il faut un Mac Studio, un PC équipé d’une carte graphique ou un serveur.
Ce guide sert à décider avant d’acheter : protection offerte par chaque option, tâches réalistes et limites, un calculateur qui traduit votre équipe et vos usages en machine et en euros, puis l’installation, la maintenance et quatre cas par métier.
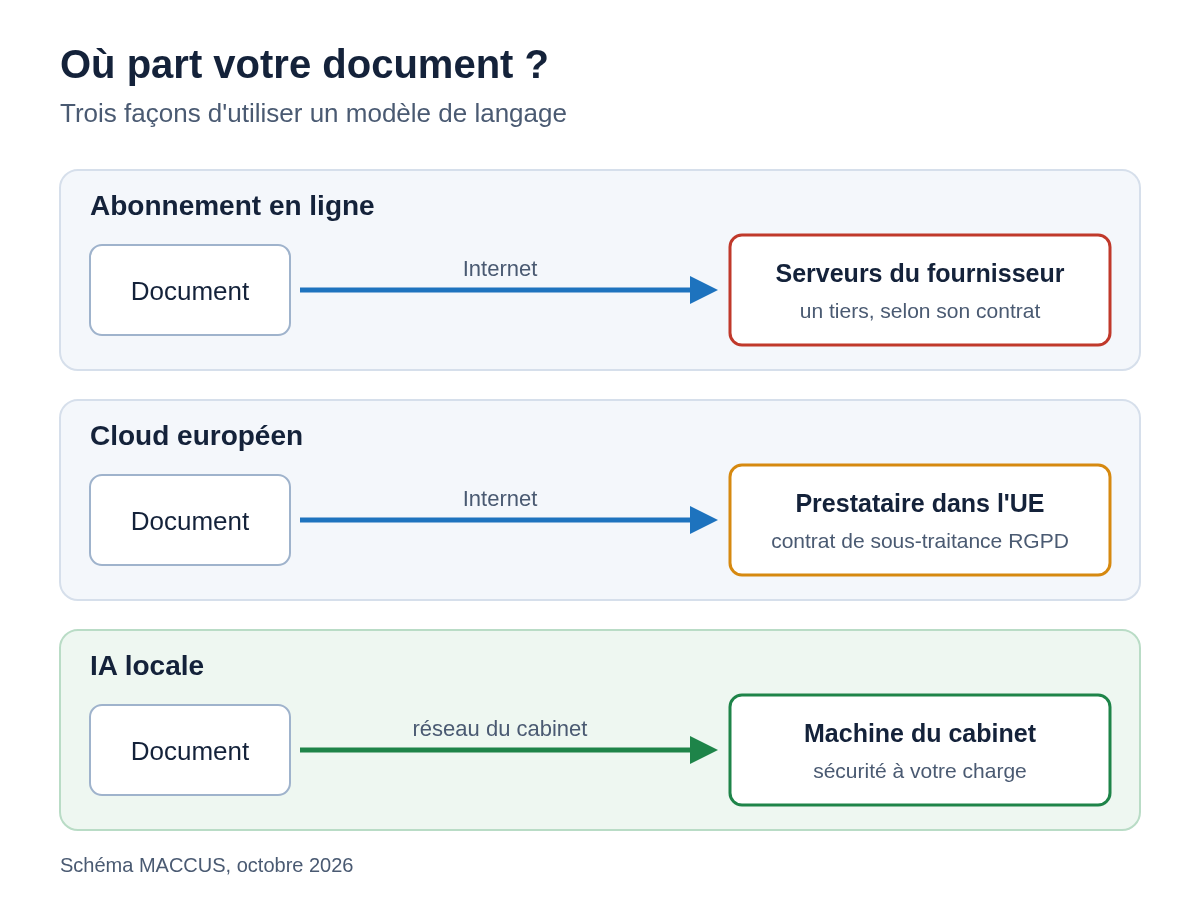
Local, cloud européen ou abonnement : le niveau de protection de chaque option
Pour chacune des trois options, posez la même question : qui, en dehors de vous, peut lire ce que vous envoyez ?
Avec un abonnement à un assistant en ligne (ChatGPT, Claude, Gemini, Copilot), chaque question et chaque pièce jointe partent sur les serveurs du fournisseur. Le texte est traité chez un tiers, aux conditions de son contrat et de ses réglages de confidentialité. Pour comparer les formules d’un de ces services, notre guide quel abonnement Claude choisir détaille les offres.
Avec un cloud européen, le modèle tourne chez un fournisseur établi dans l’Union européenne. Mistral AI, société française, propose par exemple une offre Team à 29,99 € TTC par utilisateur et par mois au 10 octobre 2026. Les données restent traitées par un tiers : il vous faut un contrat de sous-traitance au sens de l’article 28 du RGPD et une lecture attentive des conditions.
Avec une IA locale, le modèle et les documents restent sur une machine que vous possédez. Personne d’autre ne les reçoit, à condition de couper les fonctions en ligne du logiciel. Ollama, un des logiciels gratuits qui font tourner ces modèles, propose aussi des modèles « cloud » exécutés sur ses propres serveurs ; sa documentation indique comment les désactiver.
Dans ses questions-réponses sur l’IA générative publiées le 18 juillet 2024, la CNIL écrit que, pour des données personnelles ou une documentation sensible, « il semble généralement plus opportun et plus sécurisé de privilégier le déploiement de solutions « sur site » ». Elle reconnaît aussi que le coût d’une installation sur site rendra souvent plus simple le recours à un système hébergé, à condition de l’encadrer par un contrat de sous-traitance.
Le local déplace la responsabilité sans la supprimer. Le RGPD s’applique toujours : registre des traitements, sécurité des données (article 32), droits des personnes. En Belgique, l’Autorité de protection des données joue le rôle de la CNIL, avec le même règlement. Le règlement européen sur l’IA demande aussi aux déployeurs, depuis le 2 février 2025, de prendre des mesures pour la maîtrise de l’IA de leur personnel (article 4). Depuis le 27 juillet 2026, le règlement (UE) 2026/1744 a assoupli ce texte : il s’agit de « favoriser le développement de la maîtrise de l’IA », sans garantir un niveau précis pour chaque personne. Un cabinet qui installe un modèle sur son propre Mac pour son activité professionnelle est un déployeur. La sécurité de la machine devient votre affaire : accès, chiffrement du disque, mises à jour, sauvegardes.
Les tâches à confier à un modèle local en 2026
Plusieurs modèles ouverts publiés en 2025 et 2026 couvrent le travail de bureau courant. Gemma 4 de Google prend en charge plus de 140 langues et lit jusqu’à 256 000 tokens par demande, soit plusieurs centaines de pages. Mistral Small 3.2 et Ministral 3 viennent d’un éditeur français. Les modèles gpt-oss d’OpenAI sont publiés sous licence Apache 2.0, qui autorise l’usage commercial.
Les usages réalistes pour un cabinet ou une PME tiennent en quelques familles :
- rédiger un brouillon de courrier ou de mail à partir de vos notes, dans votre ton ;
- résumer un dossier de trente pages en une page, avec les points à vérifier ;
- extraire les dates, montants et parties d’un contrat vers un tableau ;
- classer des mails entrants par type de demande ;
- lire une facture ou un document scanné, puisque Gemma 4, Mistral Small 3.2 et Ministral 3 acceptent des images en entrée ;
- répondre à des questions sur vos propres documents, à condition d’ajouter un outil de recherche documentaire devant le modèle.
Sur chacune de ces tâches, la relecture humaine reste la règle : le modèle prépare le premier jet, la décision et la signature restent les vôtres.
Les limites à connaître avant de commencer
Un modèle local ne consulte pas Internet par défaut. Il ne connaît que ses données d’entraînement : il ignore la jurisprudence du mois dernier et les taux en vigueur. Certaines options de recherche web existent, mais elles font sortir vos requêtes de la machine, ce qui annule l’intérêt du local pour ces demandes.
La longueur des documents se règle. Ollama lit 4 096 tokens par défaut, soit quelques pages ; un document plus long est tronqué tant que vous n’augmentez pas ce réglage. Le calculateur ci-dessous vous rappelle la valeur à indiquer.
La lecture et la rédaction ne coûtent pas la même chose. La documentation technique de NVIDIA décrit deux phases : la lecture du texte fourni, qui sollicite la puissance de calcul, puis la production de la réponse mot après mot, limitée par la bande passante mémoire. Un long document peut donc faire attendre avant le premier mot, même sur une machine qui rédige vite : mesurez-le avec vos fichiers.
Un modèle local ne lit pas votre messagerie ni votre logiciel métier sans un travail d’intégration. Préparer les données, les accès et les règles est un chantier en soi, décrit dans notre guide pour préparer un agent IA en entreprise. Les assistants en ligne passent pour cela par des connecteurs, recensés dans notre annuaire des connecteurs MCP par outil métier.
Le calculateur : votre équipe, vos usages, la machine et son coût
Le calculateur choisit un modèle selon votre usage (vous pouvez en imposer un autre), estime la mémoire nécessaire et propose la moins chère des sept configurations Apple de référence qui suffit, avec un équivalent PC, une vitesse indicative et un coût mensuel comparé à un abonnement cloud.
Calculateur : matériel et coût d’une IA locale
Renseignez votre équipe et vos usages. Le calcul se fait dans votre navigateur : rien n’est envoyé, rien n’est enregistré.
Résultat
Le résultat s’affiche ici dès que JavaScript est actif.
Estimation, pas un devis. Prix Apple TTC relevés dans le configurateur d’apple.com/fr et tailles de modèles relevées sur ollama.com le 10 octobre 2026. Électricité : plafond calculé à la consommation maximale indiquée par Apple. Hors temps d’installation et de maintenance.
La méthode de calcul et ses hypothèses
Le choix automatique retient Gemma 4 26B A4B pour les trois premiers usages : il rédige vite sur une petite machine et lit jusqu'à 256 000 tokens. Pour le raisonnement exigeant, il passe à gpt-oss 120B. Ce sont des points de départ à tester sur vos documents, pas un classement.
La mémoire nécessaire additionne deux postes. Le premier est la taille du fichier du modèle telle qu'affichée sur ollama.com le 10 octobre 2026, dans sa version compressée par défaut. Pour traduire des pages en tokens, nous comptons environ 800 tokens par page de texte, une hypothèse à ajuster selon vos documents. Le second est la mémoire de contexte, qui grandit avec la longueur du document et le nombre de demandes traitées en même temps. Nous la comptons à 0,164 Mo par token : c'est la formule publiée par NVIDIA appliquée à la configuration de Mistral Small 3.2 (40 couches, 8 têtes clé-valeur de 128 dimensions, stockage sur 16 bits). C'est une valeur prudente pour les autres modèles du calculateur, sauf Mistral Medium 3.5 : sa configuration publiée (88 couches) donne 0,36 Mo par token, valeur que le calculateur utilise pour ce modèle. Ollama permet de compresser cette mémoire (réglage q8_0), ce qui la divise environ par deux selon sa documentation.
Le nombre de demandes simultanées est votre effectif multiplié par la part qui interroge l'IA au même instant. Les 20 % proposés par défaut sont une hypothèse : un cabinet où tout le monde lance ses résumés à 9 heures doit monter ce chiffre. Sur un Mac, nous ne comptons que les trois quarts de la mémoire pour le modèle, le reste allant à macOS et à vos applications.
La vitesse de rédaction dépend surtout de la bande passante mémoire, publiée par Apple pour chaque puce (pour la M5 Pro 18 cœurs, nous reprenons les 307 Go/s qu'Apple publie pour cette puce). À chaque mot produit, la machine relit les paramètres actifs du modèle. Le calculateur divise donc la bande passante par la taille des paramètres actifs, puis applique un rendement compris entre 35 % et 70 %, d'où une fourchette plutôt qu'un chiffre. Les modèles « à experts » comme gpt-oss ou Gemma 4 26B A4B n'activent qu'une petite partie de leurs paramètres à chaque mot : ils rédigent bien plus vite qu'un modèle dense de même taille.
L'électricité est un plafond : la consommation maximale en continu indiquée par Apple (155 W pour le Mac mini, 480 W pour le Mac Studio), multipliée par vos heures d'allumage et le prix du kWh. Le prix par défaut est celui du tarif réglementé français (Tarif Bleu d'EDF) en option Base, 0,2001 € TTC le kWh pour 3 à 6 kVA depuis le 1er août 2026 ; en Belgique, saisissez le prix de votre contrat. Le coût mensuel ajoute l'achat amorti sur la durée choisie. Le temps d'installation et de maintenance reste hors calcul ; la section sur la maintenance en donne la mesure.
Les configurations de référence au 10 octobre 2026
Le tableau suivant reprend les sept configurations Apple utilisées par le calculateur, avec 512 Go de stockage quand Apple le propose. Les Mac partagent une mémoire unifiée entre le processeur et la puce graphique : un modèle de 65 Go tient entier dans un Mac Studio de 128 Go, alors que la plus grosse carte GeForce de NVIDIA, la RTX 5090, compte 32 Go.
| Configuration | Mémoire | Bande passante | Prix TTC | Consommation maximale |
|---|---|---|---|---|
| Mac mini M6 (CPU 12 cœurs, GPU 12 cœurs), 256 Go | 16 Go | 153 Go/s | 1 049 € | 155 W |
| Mac mini M6 (CPU 12 cœurs, GPU 12 cœurs), 512 Go | 24 Go | 170 Go/s | 1 489 € | 155 W |
| Mac mini M6 (CPU 12 cœurs, GPU 12 cœurs), 512 Go | 32 Go | 170 Go/s | 1 709 € | 155 W |
| Mac mini M5 Pro (CPU 18 cœurs, GPU 20 cœurs), 512 Go | 48 Go | 307 Go/s | 2 879 € | 155 W |
| Mac mini M5 Pro (CPU 18 cœurs, GPU 20 cœurs), 512 Go | 64 Go | 307 Go/s | 3 319 € | 155 W |
| Mac Studio M5 Max (CPU 18 cœurs, GPU 40 cœurs), 512 Go | 128 Go | 614 Go/s | 5 859 € | 480 W |
| Mac Studio M5 Ultra (CPU 30 cœurs, GPU 64 cœurs), 1 To | 256 Go | 1 200 Go/s | 10 999 € | 480 W |
Méthode : prix relevés dans le configurateur de la boutique Apple France (les versions 512 Go des Mac mini M5 Pro et du Mac Studio M5 Max correspondent au prix 1 To diminué des 330 € affichés par le configurateur), bande passante et consommation maximale en continu relevées sur les fiches techniques d’Apple, le 10 octobre 2026. Nous revérifions ces chiffres à chaque mise à jour du guide, au moins une fois par an.
Apple annonce sur sa boutique une option de 512 Go pour la puce M5 Ultra, disponible fin octobre 2026. Elle n'est pas dans le calculateur faute de prix publié à ce jour.
Mac, PC à carte graphique ou boîtier dédié
Sur un PC, c'est la mémoire de la carte graphique qui compte. Pour garder la vitesse, le modèle et sa mémoire de contexte doivent y tenir entiers. NVIDIA annonce 32 Go de mémoire GDDR7 sur la GeForce RTX 5090 et 96 Go sur la carte professionnelle RTX PRO 6000 Blackwell, avec une bande passante de 1 792 Go/s pour cette dernière. Cette bande passante dépasse celle du Mac Studio M5 Ultra (1 200 Go/s). Un tel PC se monte sur devis. Nous n'avons pas retenu de prix de carte graphique : saisissez celui de votre devis dans le calculateur.
Deux familles de boîtiers compacts visent aussi ce marché. Le DGX Spark de NVIDIA embarque jusqu'à 128 Go de mémoire unifiée à 273 Go/s, pour une alimentation de 240 W ; NVIDIA le donne capable de faire tourner des modèles jusqu'à 200 milliards de paramètres. Le Framework Desktop, à processeur AMD Ryzen AI Max, existe en versions de 32 à 192 Go de mémoire. Dans les deux cas, comparez la bande passante annoncée à celle des Mac du tableau, puisqu'elle fixe la vitesse de rédaction.
Sept modèles ouverts à essayer
Ces modèles se téléchargent gratuitement depuis la bibliothèque d'Ollama.
| Modèle | Éditeur | Licence | Taille | Contexte maximal (tokens) | Paramètres |
|---|---|---|---|---|---|
| Ministral 3 8B | Mistral AI | Apache 2.0 | 6 Go | 256 000 | 8 milliards |
| gpt-oss 20B | OpenAI | Apache 2.0 | 14 Go | 128 000 | 21 milliards, dont 3,6 actifs |
| Mistral Small 3.2 | Mistral AI | Apache 2.0 | 15 Go | 128 000 | 24 milliards |
| Gemma 4 26B A4B | Google DeepMind | Apache 2.0 | 16 Go (QAT) | 256 000 | 25,2 milliards, dont 3,8 actifs |
| Gemma 4 31B | Google DeepMind | Apache 2.0 | 19 Go (QAT) | 256 000 | 30,7 milliards |
| gpt-oss 120B | OpenAI | Apache 2.0 | 65 Go | 128 000 | 117 milliards, dont 5,1 actifs |
| Mistral Medium 3.5 | Mistral AI | MIT modifiée | 80 Go | 256 000 | 128 milliards |
Méthode : tailles des versions compressées proposées par défaut dans la bibliothèque d’Ollama (version QAT pour Gemma 4), licences et nombres de paramètres relevés sur les fiches publiées par les éditeurs, le 10 octobre 2026.
La licence compte pour une entreprise. Apache 2.0 autorise l'usage commercial et la modification. La licence de Mistral Medium 3.5 est une licence MIT modifiée, avec une exception pour les entreprises à très gros chiffre d'affaires : lisez-la avant de l'utiliser. Pour choisir entre plusieurs modèles selon la tâche, notre guide choisir son modèle IA propose une méthode de test.
Installation pas à pas pour un non-informaticien
Pour une seule personne sur son propre ordinateur, l'installation tient en six étapes. Faites-la d'abord sur une machine existante, avant d'en acheter une.
- Vérifiez la machine. LM Studio demande un Mac à puce Apple et macOS 14 ou plus récent, avec 16 Go de mémoire recommandés ; sur un PC Windows, 16 Go de mémoire et une carte graphique d'au moins 4 Go sont recommandés.
- Téléchargez Ollama sur ollama.com (fichier .dmg sur Mac, OllamaSetup.exe sur Windows) ou LM Studio sur lmstudio.ai. Ollama est gratuit, et LM Studio l'est aussi pour un usage professionnel depuis le 8 juillet 2025.
- Téléchargez un modèle adapté à votre mémoire. Avec 16 Go, commencez par Ministral 3 8B (6 Go) ; avec 32 Go, essayez Gemma 4 26B A4B ou Mistral Small 3.2. Dans un terminal, la commande
ollama pull mistral-small3.2télécharge le second. - Coupez les fonctions en ligne. Pour Ollama, la documentation donne le réglage
OLLAMA_NO_CLOUD=1, ou la ligne"disable_ollama_cloud": truedans le fichier~/.ollama/server.json. - Réglez la longueur de contexte selon vos documents, par exemple
OLLAMA_CONTEXT_LENGTH=32000pour une quarantaine de pages. - Testez sur des documents fictifs. Un contrat type, un courrier inventé, une facture d'exemple : dix questions dont vous connaissez la réponse, et une note des erreurs.
Comptez 6 à 80 Go d'espace disque par modèle (dossier ~/.ollama/models sur Mac).
Partager la machine avec toute l'équipe
Par défaut, Ollama n'écoute que l'ordinateur sur lequel il tourne (adresse 127.0.0.1, port 11434). Pour le rendre accessible aux postes du cabinet, il faut changer ce réglage, par exemple avec OLLAMA_HOST=0.0.0.0:11434. Tout appareil du réseau peut alors l'interroger : réseau séparé, pare-feu et interface avec des comptes individuels deviennent nécessaires. C'est le moment de faire appel à un informaticien.
Ollama traite par défaut une demande à la fois par modèle. Le réglage OLLAMA_NUM_PARALLEL augmente ce nombre, et chaque demande en parallèle réserve sa propre mémoire de contexte : sa documentation précise qu'un contexte de 2K tokens servi à quatre demandes parallèles équivaut à un contexte de 8K tokens. Le calculateur en tient compte.
Combien de temps demande la maintenance ?
Une IA locale demande une personne responsable, même à temps très partiel, et quelques gestes réguliers.
Les logiciels et les modèles évoluent vite. Qwen a publié sa série 3.5 en février 2026, puis ses premiers modèles 3.6. Mettez à jour Ollama ou LM Studio régulièrement ; un changement de modèle, lui, se teste à nouveau sur vos dix documents de référence avant d'être adopté par l'équipe.
Côté machine : mises à jour de macOS ou de Windows, chiffrement du disque, sauvegarde des historiques de conversation si votre interface les conserve, puisqu'ils contiennent le texte de vos dossiers. Prévoyez aussi l'espace disque : trois modèles de taille moyenne occupent vite 50 Go.
Notez le traitement dans votre registre RGPD, fixez par écrit ce que l'on peut soumettre au modèle, et formez l'équipe, dans l'esprit de l'article 4 du règlement sur l'IA. Un créneau d'une heure par mois pour relire les usages et les erreurs constatées évite les mauvaises habitudes.
Avocat, médecin, psychologue, fiduciaire : quatre cas
Cabinet d'avocats
Le Conseil national des barreaux est clair dans son guide pratique de septembre 2024 : « l'avocat ne doit jamais communiquer des données couvertes par le secret professionnel à des intelligences artificielles génératives ». Son guide « La déontologie et l'intelligence artificielle », publié en avril 2026, recommande la pseudonymisation ou l'anonymisation des données et mentionne les systèmes d'IA fermés développés par des cabinets, qui permettent de travailler dans le respect du secret. Il liste aussi les points de sécurité à vérifier, y compris lorsque les modèles sont hébergés en local.
Un modèle local répond à cette exigence de confinement, à condition que la machine soit protégée et l'accès limité aux personnes habilitées. Les tâches de départ sont celles de notre page IA pour avocats : relance d'honoraires, extraction des données clés d'un contrat, chronologie factuelle d'un dossier, toujours relues. En Belgique, vérifiez les recommandations de votre ordre.
Cabinet médical
En France, la loi impose une certification d'hébergeur de données de santé (HDS) à toute personne qui héberge des données de santé pour le compte d'un professionnel, d'un établissement ou d'un patient (article L. 1111-8 du code de la santé publique). Au regard de ce texte, une machine installée au cabinet et gérée par le médecin lui-même n'est pas un hébergement pour le compte d'un tiers. Si un prestataire administre la machine à distance, faites vérifier sa situation au regard de cette certification. La certification HDS est une règle française ; en Belgique, ce sont le RGPD et le secret médical qui encadrent le sujet.
Commencez par l'administratif, comme le propose notre page IA en cabinet médical : documents d'information du cabinet, tri des messages du secrétariat, analyse des rejets de facturation. Le diagnostic et la prescription restent hors du champ de l'outil.
Psychologue en libéral
Les notes de séance sont des données de santé au sens du RGPD, qui vise expressément la santé physique ou mentale (article 4). Un modèle local évite qu'elles quittent le cabinet, mais la règle de prudence reste la même : ne soumettre que le nécessaire, sans nom ni détail identifiant.
Les usages raisonnables sont organisationnels : courrier de liaison au médecin, tri des messages, proposition de créneaux, documents administratifs. Notre page IA pour psychologues détaille ces tâches sans exposer les dossiers.
Fiduciaire et expertise comptable
Une fiduciaire manipule les données financières et salariales de ses clients, souvent à partir de documents scannés. Les modèles qui lisent les images, comme Gemma 4 ou Mistral Small 3.2, servent à extraire montants, dates et numéros de TVA d'une facture fournisseur vers un tableau, à rapprocher ensuite des pièces originales. Le contrôle d'un rapprochement bancaire et les relances de pièces manquantes suivent le même principe.
Le contrôle reste humain et chiffré : chaque montant extrait se compare au document source, jamais à l'avis d'un second modèle. Les tâches et les contrôles sont décrits dans notre page IA en fiduciaire.
Avant d'acheter la machine
Écrivez trois tâches précises que l'IA locale doit accomplir. Rassemblez vingt documents de test sans données réelles. Faites tourner le calculateur avec votre effectif et la taille de vos documents, puis essayez un modèle sur un ordinateur que vous avez déjà : un Mac à puce Apple de 16 Go suffit pour Ministral 3 8B. Pour situer ces tâches dans votre métier, notre guide l'IA par métier donne un point de départ par profession.
Une machine locale demande de l'installation et du suivi. Si vos usages n'exigent pas que les données restent au cabinet et que vous préférez ne pas gérer de matériel, l'assistant IA de MACCUS fonctionne sur Telegram, en français, en anglais ou en néerlandais : l'installation et l'hébergement sont pris en charge, et il se branche sur vos outils selon vos besoins.