
Un agent IA est un logiciel qui visite votre site pour le compte d’une personne : il lit vos pages, compare vos offres, remplit votre formulaire de devis. Rendre un site « prêt pour les agents », c’est faire en sorte que cette visite réussisse : un contenu lisible par une machine, des formulaires sans ambiguïté, des règles claires pour les robots et, plus tard, des actions déclarées au navigateur.
Ce guide fait le point au 10 octobre 2026. Les standards dont on parle (WebMCP, NLWeb, Markdown pour les agents, Web Bot Auth) sont des brouillons ou des expériences, et presque aucun site ne les utilise encore : notre propre relevé sur quinze grands sites français ne trouve ni Content Signals, ni version Markdown, ni fichier de découverte pour agents. Le travail utile aujourd’hui tient surtout à des bases que Google recommande déjà pour les humains. La checklist en fin d’article les classe par ordre de priorité.
Un visiteur qui lit, compare et remplit vos formulaires
Google définit les agents comme des systèmes autonomes qui accomplissent des tâches pour le compte de personnes, par exemple réserver une table ou comparer des caractéristiques de produits. Un agent de navigateur lit votre site de trois façons, selon le guide « Build agent-friendly websites » publié sur web.dev : des captures d’écran analysées par un modèle de vision, le code HTML, et l’arbre d’accessibilité, cette version simplifiée de la page que le navigateur prépare pour les lecteurs d’écran (rôle, nom et état de chaque bouton ou champ).
Cet agent diffère du robot d’indexation que vous connaissez. GPTBot ou ClaudeBot parcourent le web pour entraîner des modèles ou alimenter une recherche ; notre article sur les robots IA et le fichier robots.txt détaille lesquels respectent vos règles. L’agent arrive parce qu’un client vient de lui confier une tâche. OpenAI le dit sur sa page consacrée à ses robots à propos de ChatGPT-User, l’agent utilisé quand un utilisateur pose une question qui demande de visiter une page : comme ces actions sont lancées par un utilisateur, les règles du robots.txt peuvent ne pas s’appliquer. Un agent peut aussi envoyer un formulaire qui n’aurait jamais dû partir : le 9 octobre 2026, Anthropic a révélé qu’un de ses modèles avait déposé un faux signalement sur un site de la police de Philadelphie, un cas que nous analysons dans notre article sur le rapport d’Anthropic.
Le volume n’est plus anecdotique. Dans un billet du 6 août 2026, Cloudflare écrit que, selon ses propres mesures, moins de la moitié des requêtes de pages HTML viennent désormais d’un humain, en précisant que toutes ces machines ne sont pas des agents qui agissent pour une personne. Les visites humaines que les assistants vous envoient se mesurent, elles, dans Google Analytics 4 : voyez notre guide du trafic IA dans GA4.
L’adoption réelle au 10 octobre 2026
En avril 2026, Cloudflare Radar a passé au crible les 200 000 domaines les plus visités du web, après avoir écarté les catégories où la question ne se pose pas (redirections, serveurs publicitaires). Résultat publié le 17 avril : 78 % des sites ont un robots.txt, 4 % y déclarent des Content Signals, 3,9 % servent une version Markdown quand on la leur demande, et les cartes de serveur MCP et catalogues d’API apparaissent sur moins de 15 sites de tout l’échantillon.
Nous avons refait un relevé plus modeste le 10 octobre 2026 entre 13 h 53 et 13 h 55, sur quinze grands sites français : lemonde.fr, lefigaro.fr, ouest-france.fr, 20minutes.fr, leboncoin.fr, fnac.com, cdiscount.com, decathlon.fr, boulanger.com, marmiton.org, doctolib.fr, service-public.fr, laposte.fr, sncf-connect.com et legifrance.gouv.fr. Un script simple, sans navigateur, a demandé à chacun son robots.txt, un fichier llms.txt, la page d’accueil en Markdown et trois fichiers de découverte pour agents.
- Huit sites sur quinze ont refusé la page d’accueil à notre script (codes 400 ou 403), et quatre d’entre eux même le robots.txt : un agent qui lit sans navigateur se heurte vite au pare-feu.
- Sur les onze robots.txt lisibles, six nomment au moins un des quatorze robots d’IA que nous cherchions, et cinq en nomment au moins neuf. Aucun ne contient de ligne Content-Signal.
- Aucun site ne nous a servi de fichier llms.txt : sept répondent 404, les autres ont refusé la requête.
- Aucun des sept sites qui ont répondu à la demande de Markdown n’en a servi : six ont renvoyé du HTML, le septième a refusé le format.
- Aucun ne nous a servi de carte de serveur MCP, d’index de compétences d’agent ni de catalogue d’API.
Côté navigateurs, seul Chrome propose WebMCP à l’essai : l’origin trial (un test ouvert aux sites inscrits) a commencé avec Chrome 149 et devait s’arrêter avec Chrome 156, et fin septembre 2026 l’équipe de Chrome a demandé à le prolonger jusqu’à Chrome 162, selon Chrome Status. Les deux autres moteurs ont pris position sur leurs dépôts publics : WebKit, le moteur de Safari, s’est déclaré opposé à WebMCP en juin 2026, et Mozilla a classé la proposition « neutre » le 5 août 2026. L’adoption est donc proche de zéro, en France comme ailleurs. Ce guide relève de l’anticipation : il sert à choisir ce qu’il faut préparer maintenant et ce qu’il vaut mieux surveiller.
Les positions publiées par Google, Cloudflare, Microsoft et OpenAI
Google : les bases d’abord
Le guide de Google Search sur les fonctions d’IA générative, mis à jour le 10 juillet 2026, est net. Optimiser pour l’IA de Google reste du SEO. Les fichiers llms.txt et autres balisages « spéciaux » sont inutiles pour Google Search, qui ne s’en sert pas. Les données structurées sont facultatives pour les fonctions d’IA et restent utiles pour les résultats enrichis. Sur les agents, Google renvoie au guide web.dev déjà cité « si c’est pertinent pour votre activité et que vous avez du temps », et signale que des protocoles comme l’Universal Commerce Protocol (UCP) permettront à ses agents de recherche d’en faire davantage. Notre page sur le mode IA et les aperçus IA de Google couvre le versant recherche.
Côté Chrome, Google co-écrit WebMCP et a ajouté à Lighthouse une catégorie expérimentale « Agentic Browsing ». Elle demande Chrome 150 ou plus et n’affiche pas de note sur 100 : elle donne un ratio de contrôles réussis (noms et libellés des éléments interactifs, cohérence de l’arbre d’accessibilité, stabilité de la mise en page, présence d’un llms.txt, outils WebMCP déclarés).
Cloudflare : un score et des réglages
Cloudflare a lancé le 17 avril 2026 isitagentready.com, un outil en ligne qui note un site après avoir testé une série de standards. Au 10 octobre 2026, la page d’accueil de l’outil range ses contrôles en cinq familles : découverte (robots.txt, sitemap, en-têtes Link, DNS-AID), accès au contenu (Markdown), contrôle des robots (règles pour les robots d’IA, Content Signals, Web Bot Auth), découverte de protocoles (carte de serveur MCP, compétences d’agent, WebMCP, catalogue d’API, découverte OAuth, entre autres) et commerce (x402, MPP, UCP, ACP). En avril, Cloudflare précisait que les contrôles de commerce ne comptaient pas dans la note. Le 6 août 2026, ces contrôles sont entrés dans le tableau de bord de Cloudflare, sous Agent Readiness.
Prudence avec les liens « Set up in Cloudflare » proposés à côté des contrôles. L’un d’eux mène au robots.txt géré par Cloudflare : selon la documentation, quand vous refusez l’entraînement dans vos réglages de robots d’IA, le fichier ajoute avant vos propres règles une interdiction pour GPTBot, ClaudeBot, Google-Extended et cinq autres robots d’IA. Lisez le fichier produit avant de l’accepter, surtout si vous voulez que vos pages servent à ces modèles.
Microsoft : NLWeb et une part de WebMCP
Microsoft a présenté NLWeb le 19 mai 2025. Le projet a été conçu par R.V. Guha, que Microsoft présente comme le créateur de RSS, RDF et Schema.org. Un éditeur de spécification WebMCP sur trois travaille aussi chez Microsoft, les deux autres chez Google.
OpenAI : des agents identifiables
La page d’OpenAI sur ses robots distingue OAI-SearchBot (recherche), GPTBot (entraînement) et ChatGPT-User (actions lancées par un utilisateur). OpenAI publie aussi un répertoire de clés publiques au format prévu par Web Bot Auth, à l’adresse chatgpt.com/.well-known/http-message-signatures-directory, avec l’identifiant d’agent « https://chatgpt.com » (vérifié le 10 octobre 2026). Un pare-feu peut s’en servir pour vérifier qu’une requête signée vient bien de ChatGPT.
Les standards à connaître, du plus utile au plus expérimental
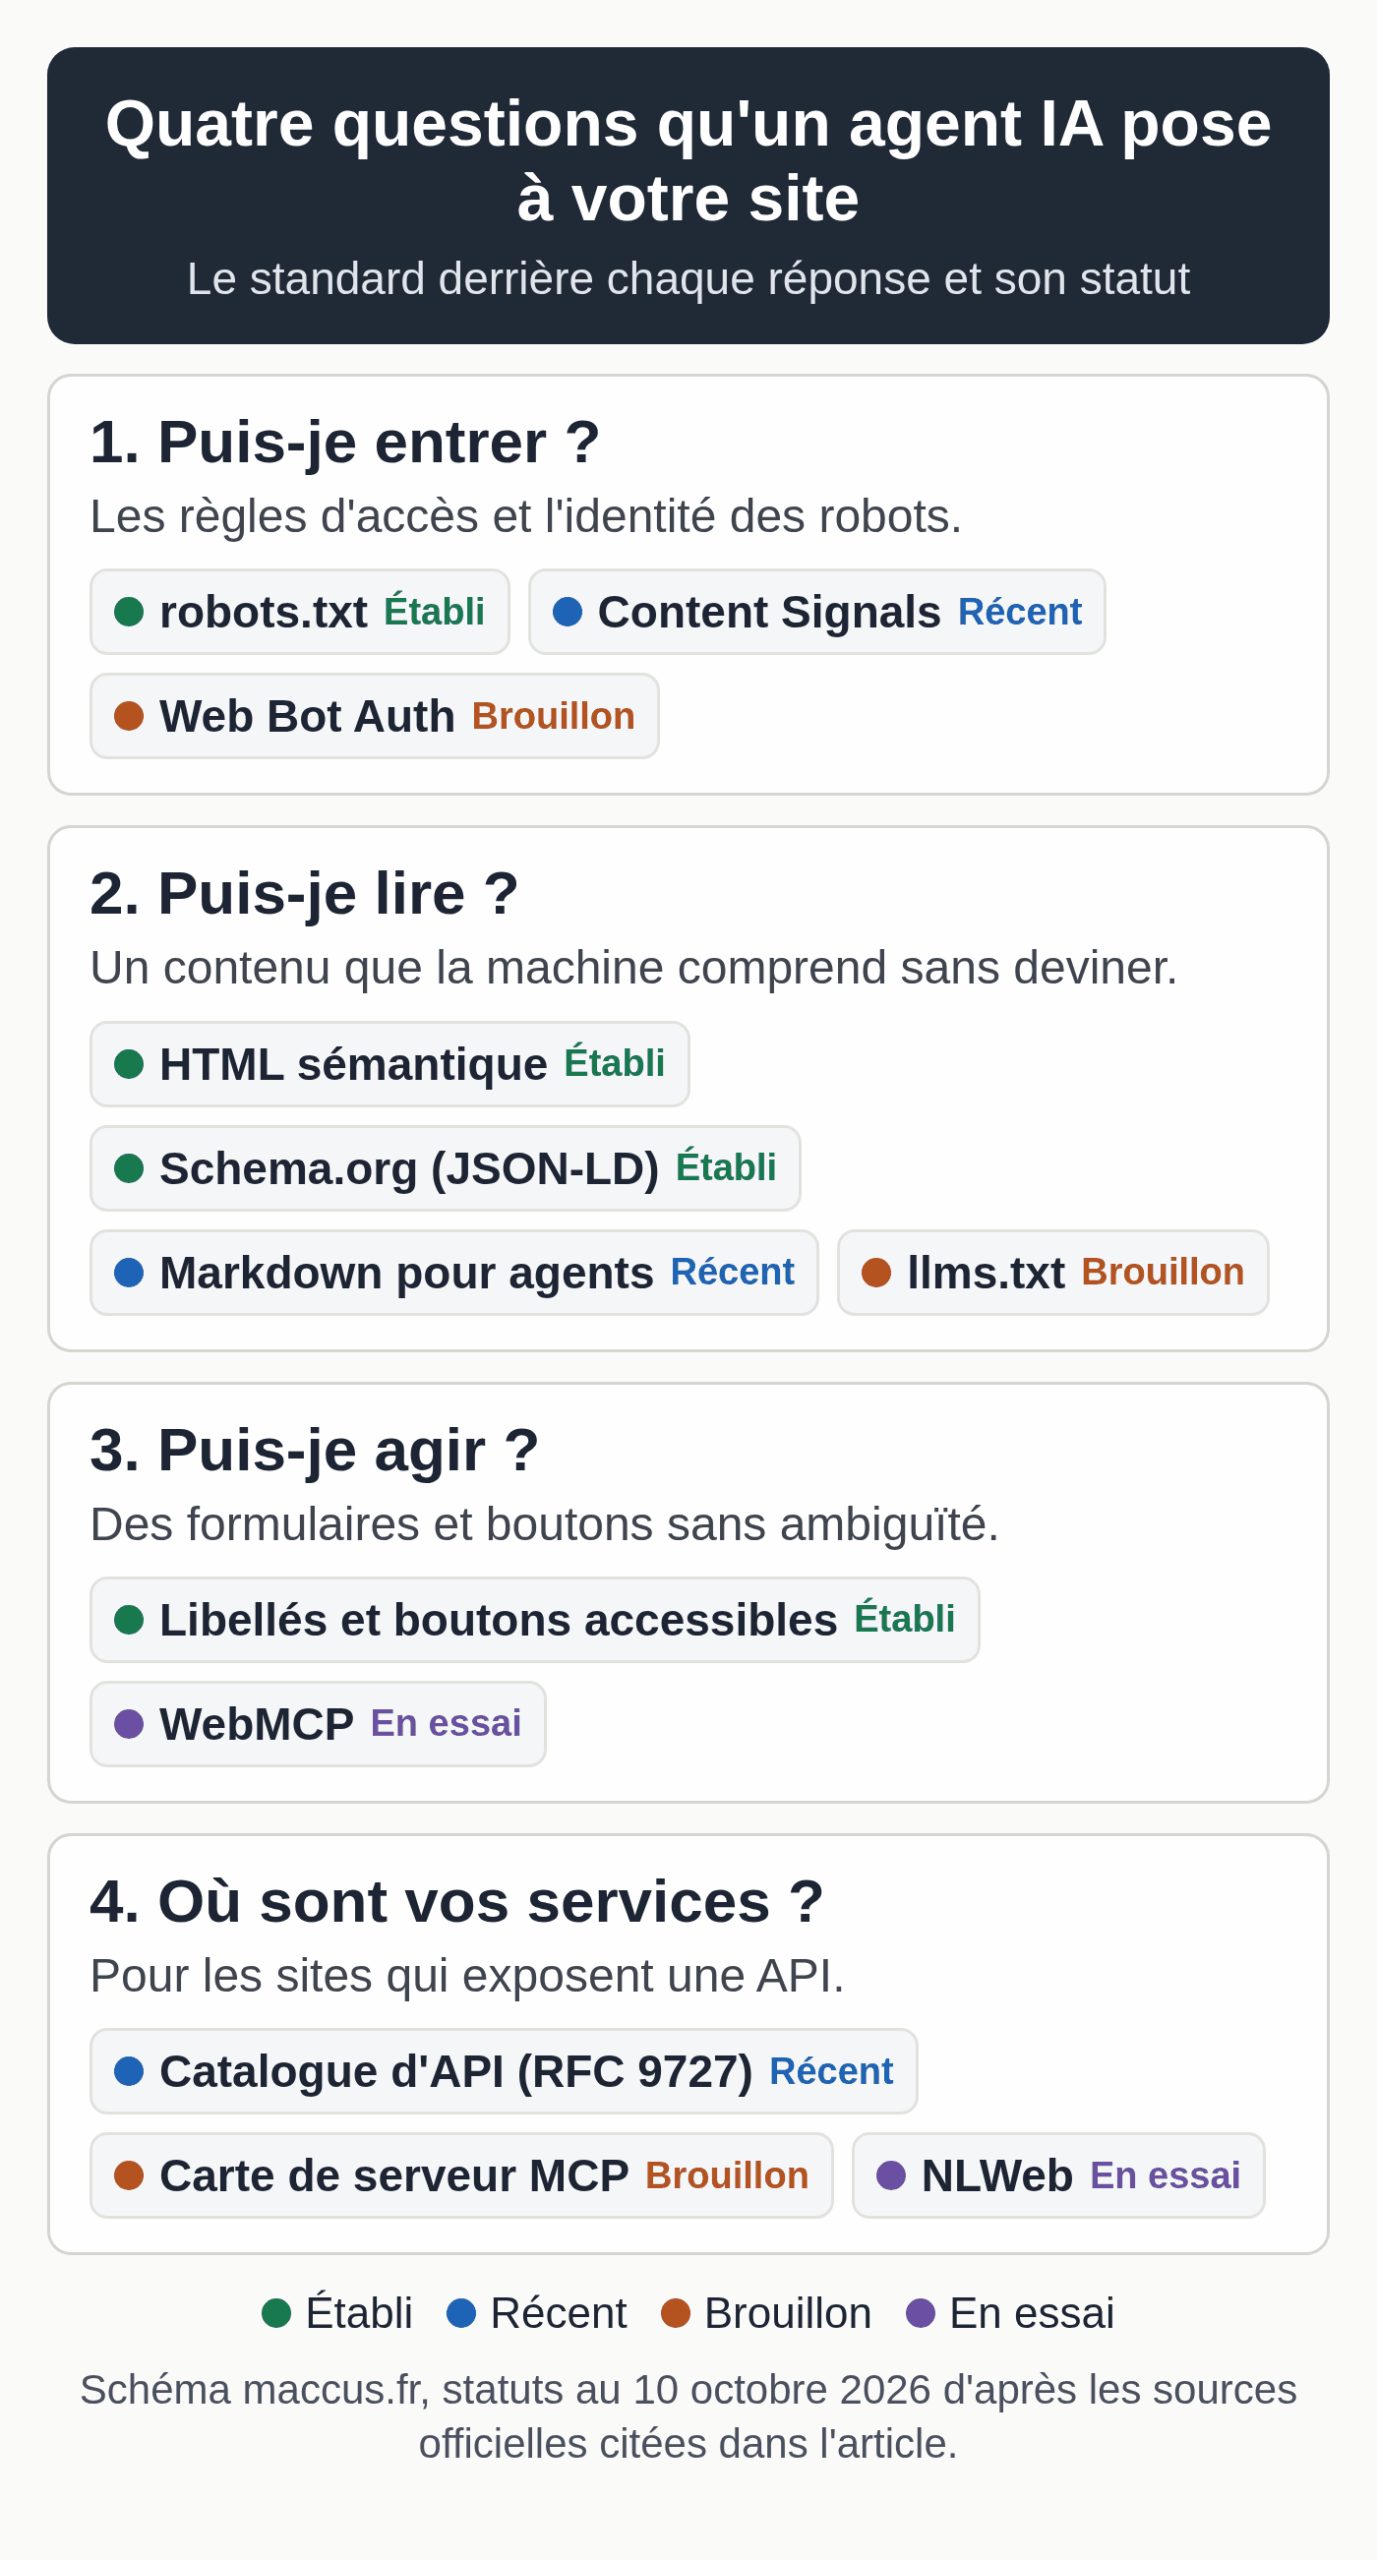
Le tableau ci-dessous résume chaque brique : son rôle, qui la porte, son statut et le type de site concerné.
Vérifié le 10 octobre 2026.
| Brique | Rôle | Portée par | Statut au 10 octobre 2026 | Sites concernés |
|---|---|---|---|---|
| HTML sémantique et accessibilité | Rendre boutons, champs et titres compréhensibles par un agent de navigateur | Standards du web ; guide web.dev de Google | Établi ; contrôlé par la catégorie expérimentale Agentic Browsing de Lighthouse | Tous |
| Données structurées Schema.org (JSON-LD) | Décrire l’entreprise, les produits, les articles | Schema.org ; lues par Google, NLWeb et la conversion Markdown de Cloudflare | Établi ; non requis pour les fonctions d’IA de Google | Tous |
| robots.txt et règles pour robots d’IA | Dire quels robots peuvent explorer quoi | IETF (RFC 9309) | Établi ; 78 % des grands sites (Cloudflare, avril 2026) | Tous |
| Content Signals | Déclarer les usages permis : search, ai-input, ai-train | Cloudflare (contentsignals.org) | Récent ; 4 % des grands sites (avril 2026) | Tous, en option |
| Markdown pour les agents | Servir une version texte allégée sur demande | Cloudflare (offres Pro, Business et Enterprise) et serveurs configurés | Récent ; 3,9 % des grands sites (avril 2026) | Contenus, documentation |
| llms.txt | Proposer une liste de liens aux modèles | Proposition publiée sur llmstxt.org | Ignoré par Google Search ; contrôlé par Lighthouse | Documentation, logiciels |
| Web Bot Auth | Signer les requêtes des robots pour prouver leur identité | IETF, groupe webbotauth | Premier brouillon de groupe de travail du 1er septembre 2026 ; clés publiées par ChatGPT | Sites qui filtrent les robots, via le CDN |
| WebMCP | Déclarer les actions d’une page (formulaires, fonctions) | Groupe communautaire Web Machine Learning du W3C ; éditeurs Google et Microsoft | Brouillon du 9 octobre 2026 ; origin trial de Chrome 149 à 156, prolongation demandée jusqu’à 162 ; WebKit opposé (juin 2026), Mozilla neutre (août 2026) | Devis, réservation, commerce, support |
| NLWeb | Interface de questions en langage naturel, doublée d’un serveur MCP | Projet ouvert lancé par Microsoft (licence MIT) | Code présenté comme démonstration de faisabilité | Catalogues et médias balisés en Schema.org |
| Catalogue d’API, carte de serveur MCP, index de compétences | Annoncer une API ou un serveur MCP à une adresse fixe | IETF (RFC 9727) ; brouillon MCP ; proposition de Cloudflare | Cartes MCP et catalogues d’API : moins de 15 sites dans l’échantillon de Cloudflare (avril 2026) | Sites qui exposent une API |
| Commerce par agent (UCP, ACP, x402) | Permettre à un agent d’acheter | UCP : Google, Shopify et d’autres ; x402 : fondation créée par Coinbase et Cloudflare | Émergent ; hors note chez Cloudflare (avril 2026) | Boutiques en ligne, via leur plateforme |
Méthode : chaque ligne a été vérifiée le 10 octobre 2026 sur sa source officielle (documentation de Chrome et Chrome Status, brouillon du W3C, positions publiées par WebKit et Mozilla, billets et documentation de Cloudflare, guide de Google Search, dépôt NLWeb, page du groupe webbotauth de l’IETF, site de l’UCP). Les pourcentages viennent du relevé de Cloudflare Radar d’avril 2026 sur les 200 000 domaines les plus visités. La date en tête du tableau indique le jour de la dernière vérification.
WebMCP en pratique sur un formulaire de devis
WebMCP permet à une page de déclarer ses actions comme des « outils » qu’un agent peut appeler, au lieu de deviner quel bouton cliquer. Il existe deux façons de le faire. L’API impérative passe par JavaScript (document.modelContext.registerTool, avec un nom, une description, un schéma JSON des paramètres et une fonction). L’API déclarative ajoute des attributs à un formulaire HTML existant : toolname et tooldescription sur la balise form, et toolparamdescription, facultatif, sur les champs.
Voici à quoi ressemblerait un formulaire de demande de devis annoté, d’après la documentation de Chrome :
<form action="/devis" method="post"
      toolname="demander-un-devis"
      tooldescription="Envoie une demande de devis pour des travaux de peinture intérieure.">
  <label for="surface">Surface à peindre (m²)</label>
  <input id="surface" name="surface" type="number" required>
  <label for="ville">Ville du chantier</label>
  <input id="ville" name="ville" type="text" required>
  <label for="delai">Délai souhaité</label>
  <select id="delai" name="delai" toolparamdescription="Délai souhaité par le client pour le début du chantier.">
    <option>Moins d'un mois</option>
    <option>Un à trois mois</option>
  </select>
  <button type="submit">Envoyer</button>
</form>
Quand un agent appelle cet outil, Chrome met le formulaire au premier plan et le remplit sous les yeux de l’utilisateur. Sans l’attribut toolautosubmit, l’explainer prévoit que le navigateur place le curseur sur le bouton d’envoi et que l’utilisateur valide lui-même. Pour une action sensible comme un achat, la documentation de Chrome indique que votre outil peut demander une confirmation à l’utilisateur : c’est au développeur de la prévoir.
Trois limites sont à connaître. Chrome en signale deux : l’API est conçue d’abord pour un navigateur utilisé par une personne présente, même si un usage sans écran reste possible, et un agent ne découvre vos outils qu’en visitant la page. La troisième figure dans le dépôt du groupe communautaire du W3C : la partie déclarative ne fait pas encore partie du brouillon de spécification (version du 9 octobre 2026), qui la traite à part. Dans sa demande de prolongation de fin septembre 2026, l’équipe de Chrome note d’ailleurs que l’API impérative est bien plus utilisée que l’API déclarative. Pour tester, un développeur active le drapeau chrome://flags/#enable-webmcp-testing sur son poste ou inscrit le site à l’origin trial.
NLWeb et le balisage Schema.org
NLWeb ajoute à un site une interface de questions en langage naturel. Chaque instance est aussi un serveur MCP, avec une méthode ask qui répond en JSON au format Schema.org. La mise en place demande une base vectorielle et un modèle de langage, avec du développement. Microsoft citait à l’annonce un premier groupe de partenaires (Eventbrite, Shopify, Tripadvisor, O’Reilly Media, le groupe d’Allrecipes et de Serious Eats, entre autres), et le dépôt, passé depuis sous l’organisation nlweb-ai sur GitHub, présente son code comme une démonstration de faisabilité.
Pour une PME, la leçon est ailleurs. NLWeb s’appuie sur les données que votre site publie déjà en Schema.org ou en RSS. Un balisage JSON-LD propre (votre entreprise, vos produits, vos articles, vos horaires) reste la brique la plus réutilisable : Google s’en sert pour les résultats enrichis, NLWeb pour répondre, et la conversion Markdown de Cloudflare le recopie en fin de document. Pour le balisage de votre entreprise, notre guide du SEO des entités fournit un générateur JSON-LD.
Markdown pour les agents : le réglage Cloudflare et son piège
Un agent qui envoie l’en-tête Accept: text/markdown peut recevoir une version Markdown de la page, sans menus ni scripts. Cloudflare mesure jusqu’à 80 % de jetons en moins dans certains cas. En février 2026, sur sept agents testés par Cloudflare, seuls Claude Code, OpenCode et Cursor envoyaient cet en-tête par défaut.
Chez Cloudflare, la conversion s’active dans AI Crawl Control, sur les offres Pro, Business et Enterprise, pour tout le domaine, ou par une règle de configuration pour certains chemins seulement. Deux effets à connaître avant d’activer. Le cache stocke désormais deux variantes de chaque page (HTML et Markdown), et les en-têtes ETag et Last-Modified disparaissent des réponses converties. Si votre serveur n’envoie pas d’en-tête content-signal, Cloudflare ajoute par défaut ai-train=yes, search=yes, ai-input=yes, c’est-à-dire une autorisation d’entraînement. Décidez votre politique avant d’activer la conversion.
Le fichier llms.txt joue un rôle voisin : une liste de liens choisie pour les modèles. Notre guide du fichier llms.txt montre qui le lit vraiment et fournit un générateur.
Identifier les robots avec Content Signals et Web Bot Auth
Content Signals ajoute une ligne au robots.txt pour dire ce que vous autorisez après l’accès : search (index et extraits de recherche), ai-input (réponses générées à partir de vos pages) et ai-train (entraînement de modèles). Par exemple :
User-agent: *
Content-Signal: ai-train=no, search=yes, ai-input=yes
Allow: /
C’est une déclaration de préférence, sans contrainte technique ; Cloudflare rappelle que le respect du robots.txt est volontaire. Les textes que votre équipe saisit dans ChatGPT ou Claude relèvent d’autres réglages, propres à chaque compte : voyez notre tableau des réglages de confidentialité de l’IA.
Web Bot Auth va dans l’autre sens : le robot signe ses requêtes (norme HTTP Message Signatures, RFC 9421) et publie ses clés publiques à une adresse fixe, ce qui permet de distinguer un agent authentique d’un imitateur. Un groupe de travail de l’IETF, webbotauth, a adopté son premier brouillon, daté du 1er septembre 2026. Si votre site se contente de servir du contenu, vous n’avez rien à signer ; votre CDN ou votre pare-feu peut en revanche vérifier ces signatures et laisser passer les agents que vous acceptez.
Les fichiers de découverte pour les sites qui ont une API
Trois fichiers à adresse fixe aident un agent à trouver vos services : le catalogue d’API (RFC 9727, à /.well-known/api-catalog), la carte de serveur MCP (brouillon, à /.well-known/mcp/server-card.json) et l’index de compétences d’agent proposé par Cloudflare (à /.well-known/agent-skills/index.json). Ils n’ont de sens que si vous exposez réellement une API ou un serveur MCP ; notre annuaire des connecteurs MCP pour les PME explique ce qu’est ce serveur.
Les protocoles de commerce (UCP, ACP, x402) relèvent de votre plateforme de vente. Le site de l’UCP cite parmi ses co-développeurs Google, Shopify, Etsy, Amazon, Walmart, Salesforce et Stripe : si votre boutique tourne sur l’une de ces plateformes ou vend par leur intermédiaire, suivez ses annonces plutôt que de coder vous-même.
Un ordre de travail pour une PME
L’essentiel du travail qui rend un site lisible par un agent le rend aussi plus clair pour un humain, et Google le dit dans les mêmes termes. L’ordre que nous conseillons tient en quatre étapes.
- Les bases, à faire maintenant : contenu principal présent dans le HTML servi, un seul titre H1 et des intertitres hiérarchisés, des libellés reliés à chaque champ, de vrais boutons, une mise en page stable, des prix et horaires écrits en texte, un balisage Schema.org valide.
- La politique d’accès, à décider ce trimestre : quels robots d’IA vous accueillez, une ligne Content-Signal choisie en connaissance de cause, et un pare-feu qui ne bloque pas par erreur les agents signés que vous voulez recevoir.
- Les formats pour agents, si votre public en utilise : une version Markdown, un llms.txt, et des formulaires clés repérés pour un futur outil WebMCP.
- Le reste, à surveiller : WebMCP en production, les fichiers de découverte, le commerce par agent. Un essai n’a de sens que si un développeur peut s’en charger et que vos clients passent déjà par des agents.
La checklist d’audit à copier
Cochez ce qui est en place sur votre site ; le compteur se met à jour, et le bouton copie la liste au format texte avec vos cases cochées, prête à coller dans un ticket ou un document. Rien n’est enregistré ni envoyé : tout reste dans votre navigateur.
Checklist d’audit : site prêt pour les agents IA
Version du 10 octobre 2026, 24 points en cinq blocs. Les étiquettes indiquent la priorité : Maintenant pour les bases, Ce trimestre, Si pertinent selon votre activité, À surveiller pour les standards encore en brouillon. Rien n’est enregistré ni envoyé.
Version texte à copier
Checklist d'audit : site prêt pour les agents IA (maccus.fr, version du 10 octobre 2026)
Site audité :

1. Accès et règles pour les robots
[ ] (Maintenant) Le robots.txt répond en 200 à un client sans navigateur et indique l'adresse du sitemap.
    Vérifier : curl -s https://votre-site/robots.txt
[ ] (Maintenant) Chaque robot d'IA a fait l'objet d'une décision (accueillir ou refuser), reflétée dans le robots.txt.
    Vérifier : relire les lignes User-agent du fichier.
[ ] (Ce trimestre) Une ligne Content-Signal est choisie (search, ai-input, ai-train), ou le choix de ne pas en mettre est noté.
    Vérifier : chercher « Content-Signal » dans le robots.txt.
[ ] (Ce trimestre) Le pare-feu ou le CDN ne bloque pas les agents que vous voulez recevoir.
    Vérifier : journal des refus (codes 403) et liste des robots autorisés.
[ ] (Ce trimestre) Si la conversion Markdown de Cloudflare est active, votre serveur envoie son propre en-tête content-signal.
    Vérifier : sans cet en-tête, Cloudflare ajoute ai-train=yes.

2. Contenu lisible par une machine
[ ] (Maintenant) Le contenu principal figure dans le HTML servi, sans attendre l'exécution du JavaScript.
    Vérifier : curl la page et chercher une phrase du texte.
[ ] (Maintenant) Chaque page a un seul titre H1 et des intertitres H2 et H3 dans l'ordre.
    Vérifier : extension de structure des titres ou outils de développement.
[ ] (Maintenant) Prix, horaires, zones desservies et conditions sont écrits en texte sélectionnable.
    Vérifier : sélectionner le texte à la souris sur la page.
[ ] (Maintenant) Un balisage Schema.org (JSON-LD) valide décrit l'entreprise et les pages clés.
    Vérifier : test des résultats enrichis de Google ou validator.schema.org.
[ ] (Si pertinent) Une version Markdown est servie quand la requête contient Accept: text/markdown.
    Vérifier : la commande curl de l'article doit renvoyer text/markdown.
[ ] (Si pertinent) Un fichier llms.txt à jour existe si votre public utilise des assistants de code ou de documentation.
    Vérifier : https://votre-site/llms.txt répond en 200.

3. Formulaires et actions
[ ] (Maintenant) Chaque champ de formulaire a un libellé relié (label for et id) ou un nom accessible.
    Vérifier : onglet Accessibility des outils de développement de Chrome.
[ ] (Maintenant) Les actions passent par de vrais boutons ou liens (balises button et a).
    Vérifier : sinon, ajouter role="button" et tabindex.
[ ] (Maintenant) Aucune surcouche transparente ne masque un élément cliquable, et chaque bouton est bien visible.
    Vérifier : bandeaux de cookies, fenêtres de discussion, calques publicitaires.
[ ] (Maintenant) La mise en page reste stable pendant le chargement (aucun bouton ne se déplace).
    Vérifier : indicateur CLS dans Lighthouse ou PageSpeed Insights.
[ ] (Si pertinent) Les formulaires clés (devis, contact, réservation) ont un nom d'action et une description prêts pour WebMCP.
    Vérifier : liste écrite, à transmettre au développeur.
[ ] (Si pertinent) Les actions sensibles (achat, suppression, envoi) demandent une validation humaine.
    Vérifier : parcours de test jusqu'à l'étape finale.

4. Découverte, si vous exposez une API
[ ] (À surveiller) Un catalogue d'API est publié à /.well-known/api-catalog (RFC 9727).
    Vérifier : l'adresse répond en 200 avec du JSON.
[ ] (À surveiller) Une carte de serveur MCP est publiée à /.well-known/mcp/server-card.json (brouillon).
    Vérifier : seulement si vous avez un serveur MCP.
[ ] (À surveiller) Un en-tête Link renvoie vers ces ressources depuis la page d'accueil.
    Vérifier : curl -sI https://votre-site/ | grep -i link

5. Mesure et suivi
[ ] (Maintenant) Le niveau obtenu sur isitagentready.com est noté avec sa date.
    Vérifier : relancer le test après chaque changement.
[ ] (Ce trimestre) Lighthouse, catégorie Agentic Browsing (Chrome 150 ou plus), a tourné sur la page de contact ou de devis.
    Vérifier : garder le rapport daté.
[ ] (Ce trimestre) Les journaux du serveur sont relus chaque mois : robots d'IA, refus 403, en-têtes Signature-Agent.
    Vérifier : demander l'export à l'hébergeur si besoin.
[ ] (Ce trimestre) Le rapport de la Search Console sur les fonctions d'IA générative est consulté.
    Vérifier : comparer d'un mois à l'autre.

Points en place : 0 sur 24, dont bases (Maintenant) : 0 sur 11
Tester votre site comme le ferait un agent
Quatre tests suffisent pour un premier état des lieux.
Le premier est le score d'isitagentready.com : entrez l'adresse de votre site, notez le niveau obtenu et la date, puis relancez après chaque changement. Les contrôles qui échouent viennent avec une consigne à transmettre à un développeur.
Le deuxième passe par un terminal. Ces commandes montrent ce que reçoit un client qui n'exécute pas de JavaScript (remplacez l'adresse par la vôtre) :
curl -s https://www.example.com/robots.txt | head -40
curl -s -o /dev/null -w "%{http_code} %{content_type}\n" -H "Accept: text/markdown" https://www.example.com/
curl -s -o /dev/null -w "%{http_code}\n" https://www.example.com/llms.txt
Si la deuxième ligne renvoie text/html, votre site ne sert pas de Markdown. Un code 403 sur la première ligne signale un pare-feu qui bloque les clients automatisés, à vérifier avec votre hébergeur.
Le troisième regarde l'arbre d'accessibilité dans les outils de développement de Chrome (panneau Elements, onglet Accessibility) : chaque champ de vos formulaires doit y porter un nom compréhensible. Le quatrième lance Lighthouse, catégorie Agentic Browsing, sur votre page de contact ou de devis, avec Chrome 150 ou plus.
Les dates à surveiller
L'origin trial de WebMCP devait prendre fin avec Chrome 156 ; si la prolongation demandée fin septembre 2026 est accordée, il courra jusqu'à Chrome 162, et la suite dira si Google l'active pour tous. WebKit s'oppose au projet et Mozilla reste neutre : un changement de l'une de ces deux positions sera le signal à suivre. Le groupe webbotauth de l'IETF travaille sur son premier brouillon, et Cloudflare annonçait en avril 2026 une mise à jour chaque semaine de son graphique d'adoption des standards pour agents. Pour ne pas passer à côté, revoyez cette liste chaque trimestre.
Si votre site existe en plusieurs langues, notre offre de SEO multilingue commence par un audit de vos versions actuelles.