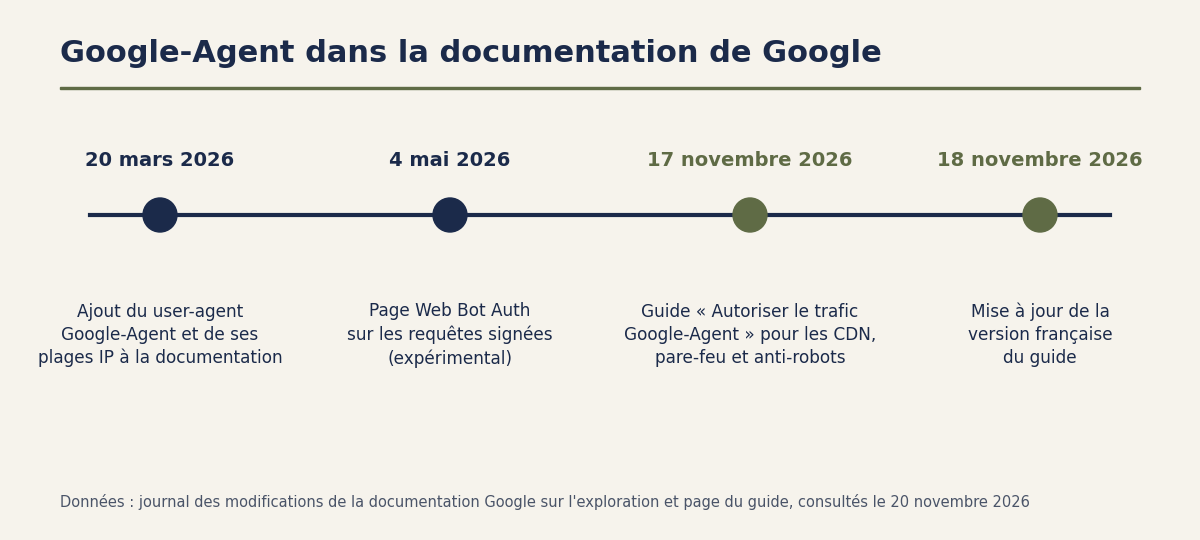
Le 17 novembre 2026, Google a publié un guide intitulé « Autoriser le trafic Google-Agent » (« Allow Google-Agent traffic » en anglais). Google-Agent est le nom que portent les agents IA de Google quand ils naviguent sur un site et y agissent à la demande d’un utilisateur. Les filtres de sécurité d’un site peuvent bloquer ces agents ; le guide explique comment les reconnaître et les laisser passer. Google ne dit pas quels produits utilisent ces agents, ni combien de visites ils représentent.
Le guide vise trois filtres placés entre les internautes et un site. Un CDN (réseau de diffusion de contenu) est un réseau de serveurs qui gardent des copies des pages près des internautes. Un pare-feu applicatif (WAF en anglais) filtre les requêtes, c’est-à-dire les demandes envoyées au site, avant qu’elles ne l’atteignent. Un service anti-robots repère et bloque les visites automatisées.
Une page de plus dans la documentation des robots de Google
Le guide figure dans la documentation technique que Google consacre à ses robots d’exploration, les programmes qui visitent automatiquement les pages des sites. Le journal des modifications de cette documentation le date du 17 novembre 2026. Il en donne aussi le but : « aider les éditeurs qui souhaitent activer Google-Agent pour leur site Web ».
Le matin même, Barry Schwartz a signalé le guide sur le site américain Search Engine Roundtable. Le site allemand Dr. Web en a parlé le même jour, et Abondance, en français, le 19 novembre.
La page tient en trois parties : comment Google-Agent s’identifie, comment l’autoriser, et que vérifier s’il reste bloqué. Elle arrive six jours après un billet du 11 novembre. Google y expliquait comment passer sur un CDN sans surcharger son serveur ni bloquer Googlebot, le robot qui parcourt le Web pour alimenter le moteur de recherche.
Un robot qui agit à la place d’un utilisateur
Google-Agent n’est pas nouveau. Google l’a ajouté le 20 mars 2026 à sa liste des « extracteurs déclenchés par l’utilisateur ». Ce sont les robots qui visitent une page parce qu’une personne l’a demandé dans un produit Google. Le journal des modifications annonçait alors un déploiement « au cours des prochaines semaines ».
Selon Search Engine Roundtable, qui reprenait le texte de la page le 23 mars, Google y donnait un exemple : Project Mariner, un prototype d’agent qui accomplit des tâches dans le navigateur. Sur la page actuelle, l’entrée de Google-Agent ne cite plus aucun produit.
La différence avec Googlebot tient à l’usage. Googlebot lit les pages pour les répertorier dans le moteur de recherche. Google-Agent les utilise pour agir à la demande de quelqu’un, comme les autres agents IA qui naviguent sur les sites. La liste de vérifications publiée par Google le montre : recherche interne d’un site, filtres, pages d’informations, ajout au panier, réservation.
Pour ces agents, le fichier robots.txt ne suffit pas. Ce fichier indique aux robots les pages qu’ils peuvent visiter. Google écrit que les extracteurs déclenchés par l’utilisateur « ignorent généralement les règles du fichier robots.txt », puisque la visite a été demandée par une personne. Notre article sur les robots IA et le fichier robots.txt détaille cette règle chez plusieurs entreprises d’IA.
Le guide du 17 novembre ne mentionne pas ce fichier : pour Google-Agent, le contrôle passe par les outils de sécurité du site.
Trois signaux pour reconnaître l’agent
Le premier signal est l’en-tête User-Agent, l’identifiant que chaque requête présente au serveur. Celui de l’agent contient la mention « Google-Agent », en version mobile et en version ordinateur. Google prévient, sur sa page consacrée aux extracteurs, que cette mention « peut être falsifiée » : n’importe quel robot peut se présenter sous ce nom.
Le deuxième signal est l’adresse IP, le numéro qui identifie une machine sur Internet. Les requêtes de Google-Agent viennent des plages d’adresses listées dans un fichier public, user-triggered-agents.json.
Téléchargé le 20 novembre, ce fichier compte 20 plages d’adresses, dans une version générée le 19 novembre. Douze sont au format IPv4, l’ancien format des adresses, et huit au format IPv6, le plus récent. Le guide demande de tenir les règles de filtrage à jour avec ce fichier.
Le troisième signal est une signature numérique, encore expérimentale : un code joint à la requête, qui prouve l’identité de son expéditeur. Google teste pour cela Web Bot Auth, un protocole en cours d’écriture à l’IETF, l’organisme qui établit les normes techniques d’Internet.
L’agent signe certaines requêtes selon la norme de l’IETF sur la signature des messages échangés sur le Web (RFC 9421). Les requêtes signées portent un en-tête Signature-Agent, qui renvoie à l’identité de l’agent, https://agent.bot.goog. Le site vérifie la signature avec les clés publiques que Google met en ligne pour cette identité. Le 20 novembre, l’annuaire de ces clés en listait cinq.
Toutes les requêtes ne sont pas signées, précise Google, qui demande de garder la vérification par adresse IP.
La règle proposée par Google et les six causes de blocage
La règle que propose Google tient en trois contrôles. Le site vérifie que l’en-tête User-Agent contient « Google-Agent » et que l’adresse IP figure dans le fichier de Google. Il vérifie aussi la signature quand la requête en porte une. Une requête qui passe ces contrôles ne doit plus recevoir de test anti-robots.
Selon Google, certains CDN, pare-feu et services anti-robots permettent déjà de vérifier Google-Agent. Google n’en nomme aucun et renvoie chaque site à son fournisseur pour la procédure exacte.
La partie dépannage du guide liste six raisons pour lesquelles l’agent peut rester bloqué malgré cette règle. Deux concernent la règle elle-même. Elle doit être prioritaire sur les blocages larges : réseaux entiers du cloud et des centres de données, règles anti-robots du fournisseur, blocage de toute la catégorie des agents IA.
La règle doit aussi dispenser l’agent de deux types de tests anti-robots. Le CAPTCHA demande au visiteur de prouver qu’il est humain ; le test JavaScript fait exécuter un petit programme au navigateur. La dispense vaut aussi pour les CAPTCHA intégrés à la page qui se déclenchent lors d’une recherche ou à l’envoi d’un formulaire.
Les quatre autres raisons portent sur le parcours de l’agent et sur la technique. L’autorisation doit couvrir les actions au-delà de la page d’accueil : recherche interne, filtres, pages d’informations, panier, réservation. Elle doit couvrir aussi les appels techniques qui font fonctionner ces actions, comme les API, les interfaces par lesquelles des programmes échangent des données.
Les limites de requêtes par adresse IP doivent tenir compte de Google-Agent. Elles plafonnent le nombre de demandes acceptées depuis une même adresse, alors que plusieurs utilisateurs de l’agent passent par les mêmes adresses IP. Les règles doivent aussi suivre les mises à jour du fichier d’adresses.
Les équilibreurs de charge, qui répartissent les visites entre plusieurs serveurs, et les serveurs intermédiaires, dits proxys, se placent entre l’internaute et le site. Ils doivent transmettre au site les signaux de l’agent : l’adresse IP d’origine, l’en-tête User-Agent et les en-têtes de signature.
Les angles morts du guide
Le guide ne donne aucun chiffre de trafic. Il ne dit pas combien de requêtes Google-Agent envoie, quelle part de ces requêtes est signée, ni quels produits utilisent l’agent. Abondance relève les mêmes manques, et Dr. Web note que Google ne dit pas à quelle fréquence l’agent visite les sites allemands.
Abondance ajoute que le guide ne donne aucune méthode pour bloquer l’agent. Le journal des modifications, de son côté, destine ce guide aux éditeurs qui souhaitent accueillir Google-Agent.
Le guide affirme qu’autoriser l’agent permet d’éviter de bloquer des requêtes légitimes « tout en préservant vos contrôles de sécurité existants ». Il demande pourtant que les limites par adresse IP tiennent compte des plages de Google, voire les exemptent, sans décrire comment Google limite lui-même le volume de ses agents. Il ne dit pas non plus si ces visites apparaissent dans les outils de mesure d’audience, ni si un blocage a un effet sur le référencement.
Notre analyse
Pour les robots des moteurs de recherche, comme Googlebot, un site garde la main avec le fichier robots.txt. Pour les agents qui agissent, Google renvoie aux outils de sécurité : CDN, pare-feu, services anti-robots.
La page de Google sur Web Bot Auth date du 4 mai et a été mise à jour en octobre. Elle expliquait déjà comment vérifier les agents IA de Google et les ajouter à une liste d’autorisation. Le guide du 17 novembre y ajoute l’en-tête User-Agent, les adresses IP et six causes de blocage.
Si l’on suit les étapes que cite Google, du panier à l’envoi d’un formulaire, les sites les plus concernés sont ceux où un agent aurait une tâche à accomplir : boutiques en ligne, sites de réservation, formulaires de demande. Pour ces sites, un blocage des réseaux de centres de données, premier cas cité dans le dépannage de Google, peut suffire à arrêter l’agent, même quand une règle d’autorisation existe.
Google montre peu de choses : un fichier de 20 plages d’adresses, cinq clés publiques et une liste de règles. Un site qui ouvre ses filtres accepte donc un trafic dont Google n’annonce ni le volume ni la valeur.
Plusieurs points restent à suivre : le nom des produits Google qui passent par Google-Agent, la part des requêtes signées et l’avancée de Web Bot Auth à l’IETF. Il faudra aussi voir si les fournisseurs de CDN et de services anti-robots ajouteront l’agent à leurs listes de robots vérifiés, et de quelle façon. Une dernière question reste ouverte : Google publiera-t-il un jour des chiffres sur ces visites ?
Sources
- Autoriser le trafic Google-Agent, Google, documentation sur l’exploration, 17 novembre 2026
- Journal des modifications (documentation sur l’exploration), Google, documentation sur l’exploration, 17 novembre 2026
- Liste des extracteurs Google déclenchés par l’utilisateur, Google, documentation sur l’exploration, 18 septembre 2026
- Authentifier des requêtes avec Web Bot Auth (état expérimental), Google, documentation sur l’exploration, 19 octobre 2026
- New Google Search Help Document On How To Allow Google-Agent Traffic, Search Engine Roundtable, 17 novembre 2026
- Google Adds Google-Agent User Agent, Search Engine Roundtable, 23 mars 2026
- Agents IA : Google demande aux sites d’ouvrir leurs CDN et pare-feu à Google-Agent, Abondance, 19 novembre 2026
- Google beschreibt die Firewall-Freigabe für den Google-Agent, Dr. Web, 17 novembre 2026
Image d’en-tête : schéma MACCUS, d’après le guide « Autoriser le trafic Google-Agent » de Google, 17 novembre 2026