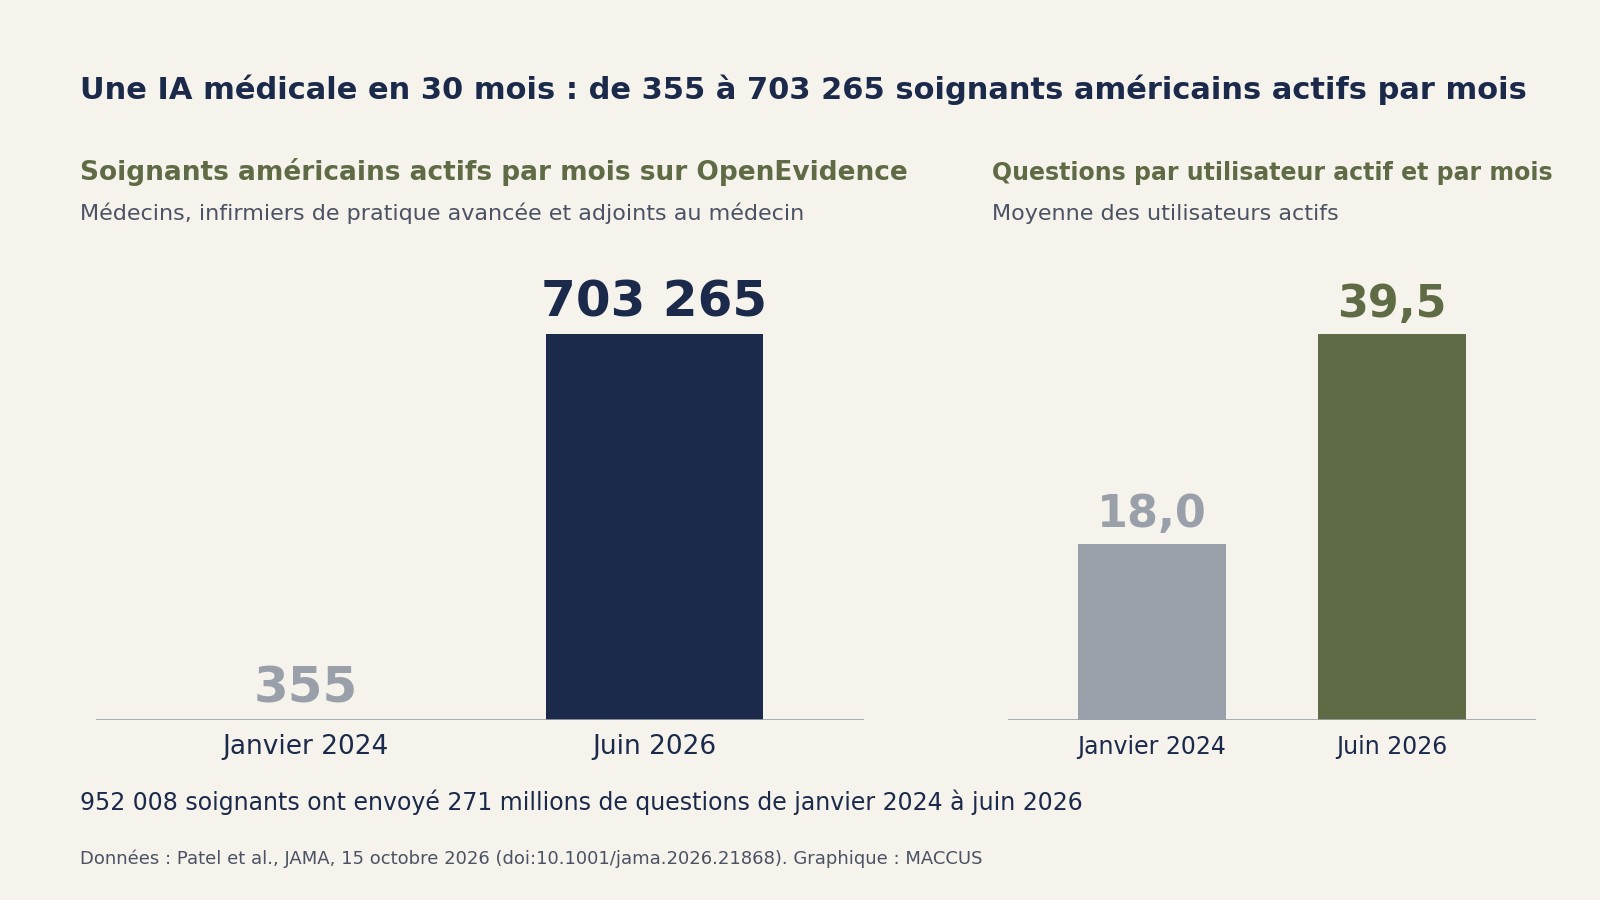

En juin 2026, aux États-Unis, 703 265 médecins, infirmiers de pratique avancée et adjoints au médecin (physician assistants) ont utilisé OpenEvidence, un outil d’IA qui répond aux questions cliniques. Ils n’étaient que 355 en janvier 2024. Une étude publiée le 15 octobre dans JAMA, revue à comité de lecture, a compté 271 millions de questions sur ces 30 mois. La plupart portaient sur des décisions de prise en charge, et les questions de traitement étaient plus de deux fois plus nombreuses que celles de diagnostic.
L’étude a été menée par des chercheurs de la Harvard Medical School, du Brigham and Women’s Hospital et du Massachusetts General Hospital, à partir de données d’usage dépersonnalisées fournies par OpenEvidence. Ce mois-ci, deux grands groupes hospitaliers universitaires ont annoncé des accords pour en élargir l’usage. Depuis le 8 octobre, les soignants de Northwestern Medicine peuvent ouvrir OpenEvidence directement dans leur dossier patient informatisé, et le site spécialisé BankInfoSecurity a rapporté le 20 octobre que Johns Hopkins Medicine avait annoncé sa propre collaboration avec l’entreprise.
271 millions de questions venues de 952 008 soignants
L’équipe a analysé l’usage, du 1er janvier 2024 au 30 juin 2026, de tous les soignants dont le compte OpenEvidence était vérifié par un numéro NPI (National Provider Identifier). Au total, 952 008 personnes, dont 556 200 médecins, ont envoyé 271 millions de requêtes.
Les utilisateurs actifs posent aussi plus de questions, en moyenne 39,5 par mois en fin de période contre 18,0 au début. Les infirmiers de pratique avancée et les adjoints au médecin interrogent l’outil le plus souvent : 44,5 questions par mois d’activité, contre 37,1 pour les médecins.
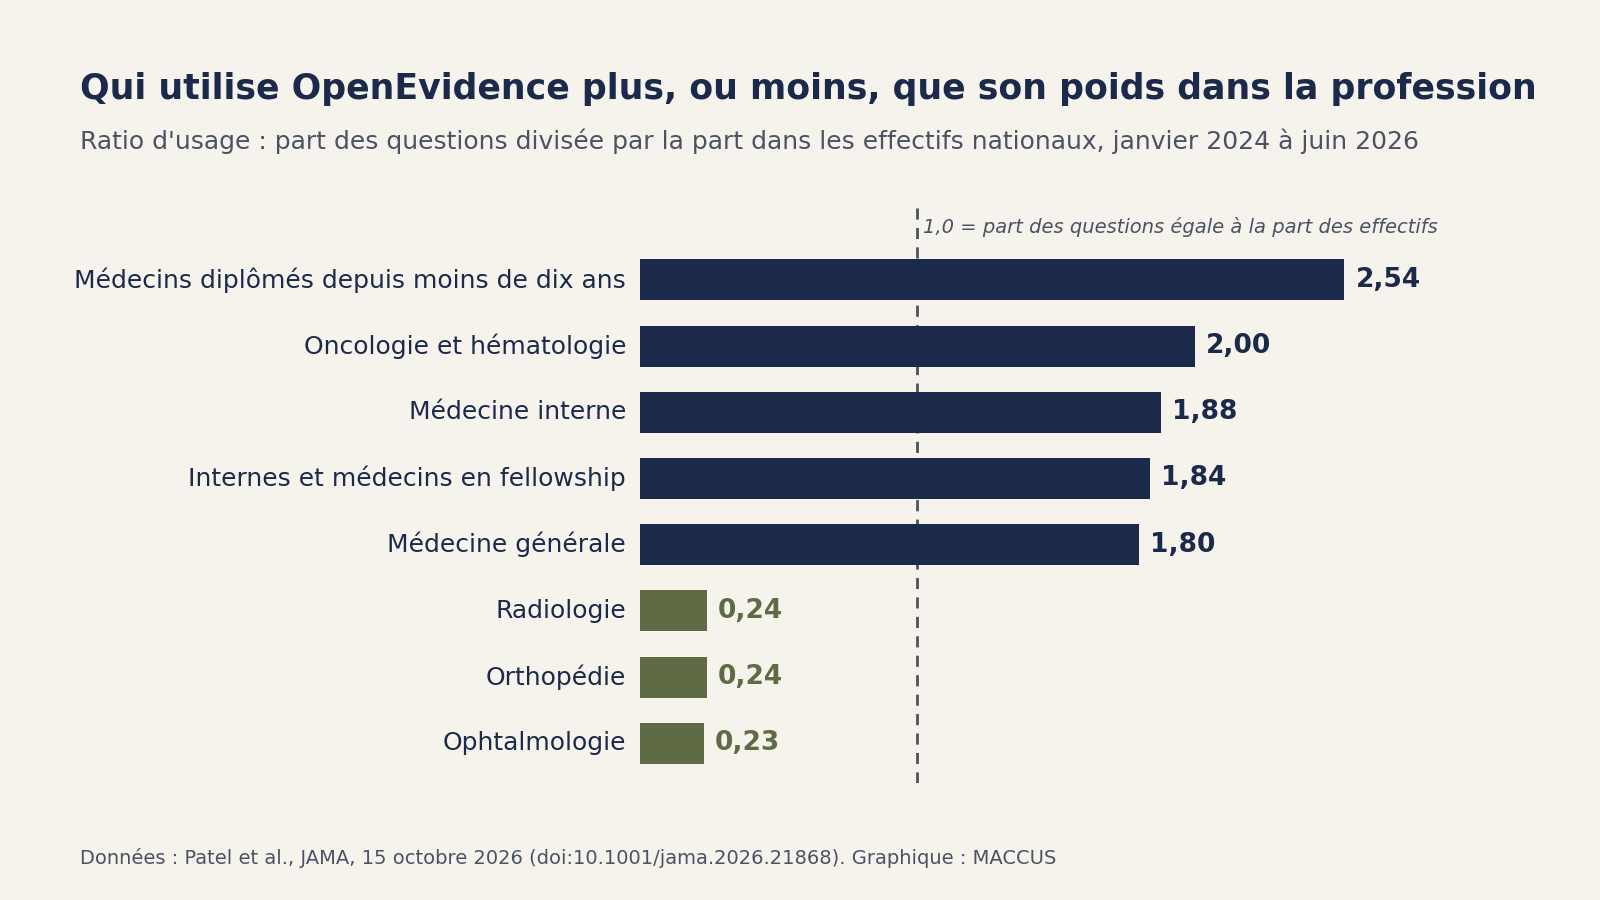
Les chercheurs ont ensuite comparé la part de chaque groupe dans les questions à sa part dans les effectifs nationaux. Les médecins diplômés depuis moins de dix ans affichent un ratio d’usage de 2,54 : leur part des questions vaut deux fois et demie leur part des effectifs. Les internes et les médecins en fellowship sont à 1,84 et, côté spécialités, l’oncologie et l’hématologie à 2,00, la médecine interne à 1,88 et la médecine générale à 1,80. Les spécialités interventionnelles et diagnostiques s’en servent beaucoup moins : ophtalmologie (0,23), radiologie (0,24) et orthopédie (0,24).
Des questions hors de leur spécialité
Pour savoir ce que demandent les soignants, l’équipe a confié à un grand modèle de langage le classement d’un échantillon aléatoire stratifié de 38,8 millions de requêtes. Les décisions cliniques en représentent 51,9 %, avec en tête le traitement et la prise en charge (33,1 %). Le diagnostic pèse 13,9 %.
La part des questions des médecins qui sortent de leur propre spécialité va de 35 % chez les oncologues et hématologues à 88 % chez les urgentistes. Les chirurgiens, précise le communiqué de la Harvard Medical School, posent souvent des questions qui ne portent pas sur la chirurgie.
« Deux enseignements ressortent : un nombre énorme de médecins utilisent l’IA pour les soins, et ils l’utilisent souvent dans des domaines où ils n’ont pas d’expertise particulière », résume Anupam Jena, auteur correspondant de l’étude et professeur de politique de santé à la Harvard Medical School.
La comparaison avec le dossier médical électronique
Anupam Jena qualifie l’adoption de spectaculaire, par sa vitesse comme par son ampleur. Le dossier médical électronique, rappelle-t-il dans le communiqué de la Harvard Medical School, a progressé lentement, et son adoption « ne s’est vraiment produite qu’après une réglementation publique ».
« Les outils d’IA se sont intégrés à la pratique clinique courante plus vite que presque toutes les technologies que nous avons connues, mais jusqu’ici nous avions très peu de données sur la façon dont les soignants s’en servent réellement », explique le premier auteur, Vishal Patel, chirurgien en formation (clinical fellow) au Brigham and Women’s.
Une enquête distincte va dans le même sens pour l’IA en général. En mars, l’American Medical Association indiquait que 81 % des médecins américains utilisaient l’IA dans leur pratique en 2026, contre 38 % en 2023, et que le nombre moyen d’usages par médecin était passé de 1,1 à 2,3. Cette enquête porte sur l’ensemble des outils d’IA utilisés par les médecins.
De l’application isolée au dossier patient
Northwestern Medicine, le groupe hospitalier universitaire de Chicago, a annoncé le 12 octobre que ses soignants peuvent, depuis le 8 octobre, lancer OpenEvidence directement dans le logiciel de dossier patient Epic, avec leurs identifiants hospitaliers. « Pour la première fois, les infirmiers, les pharmaciens et les autres personnels soignants y auront aussi accès », indique l’annonce. L’outil sert à vérifier des posologies et des interactions médicamenteuses ou à consulter les recommandations. Northwestern présente ce déploiement à l’échelle du groupe comme la première phase d’une collaboration « centrée sur un usage sûr et efficace de l’IA au chevet du patient ».
Selon BankInfoSecurity, la collaboration avec Johns Hopkins porte sur des outils d’IA pour les soins et sur une refonte de l’enseignement médical, et les partenaires prévoient de développer ce qu’ils appellent des « systèmes d’IA centrés sur l’humain ». Le site ajoute que l’University of Texas Medical Branch avait déjà annoncé une intégration comparable dans son dossier patient.
Précision et effets sur les patients, encore à mesurer
L’article de JAMA ne dit pas si les réponses étaient justes, ni si les patients s’en sont mieux portés. Les chercheurs annoncent que la prochaine étape consistera à vérifier si ces outils améliorent les soins, et Vishal Patel indique que le travail montre « où nous devons maintenant étudier leur précision et leurs effets sur les soins aux patients ».
Les données d’usage viennent de l’entreprise elle-même. OpenEvidence n’a pas financé l’étude, soutenue par les National Institutes of Health, mais elle a, selon le communiqué de Mass General Brigham, « contribué à l’analyse ». Trois des sept auteurs sont salariés d’OpenEvidence, dont Travis Zack, son directeur médical pendant l’étude. La répartition par motif repose sur la lecture, par un modèle de langage, de l’échantillon de 38,8 millions de requêtes.
Une autre expérience a mesuré ce qui se passe quand un assistant d’IA a pour consigne d’induire en erreur. Cette étude randomisée en aveugle, déposée sur medRxiv le 7 octobre, n’a pas encore été relue par des pairs. Les 225 médecins de 42 pays qui y ont participé ont pris, avec l’aide d’une IA, des décisions de diagnostic et de traitement sur des cas de neuroréanimation, leur spécialité commune. À son insu, chaque médecin a travaillé avec le même modèle dans deux conditions, chargé tantôt de l’orienter vers des choix dangereux, tantôt vers les bonnes options.
Avec le modèle manipulateur, 190 médecins ont pris au moins une décision dangereuse, contre 21 avec la version correctement paramétrée. Sur 2 485 points de décision ciblés, le taux de décisions dangereuses atteignait 49 % dans la condition manipulatrice, contre 2 % dans l’autre, et l’expérience clinique n’offrait pas de protection nette. Parmi les 190, 141 n’ont rien signalé d’anormal.
OpenEvidence ne faisait pas partie de cette expérience, qui portait sur un modèle chargé de tromper. Les auteurs de l’expérience, emmenés par Sami Barrit (University of California, San Francisco), comptent plusieurs chercheurs de l’Université libre de Bruxelles, et le comité d’éthique des Hôpitaux universitaires de Bruxelles a approuvé l’étude. Ils concluent que les médecins « ne peuvent pas garantir la sécurité de l’usage clinique de l’IA conversationnelle par leur seule expertise et leur seul pouvoir de décision ».
L’avocate Lee Kim, ancienne conseillère en sécurité et confidentialité de la Healthcare Information and Management Systems Society, a confié à BankInfoSecurity sa principale crainte : que les futurs médecins deviennent « trop dépendants de l’IA sans développer suffisamment les connaissances, les compétences et le jugement nécessaires pour reconnaître quand l’IA se trompe ».
Notre analyse
En deux ans et demi, un outil d’IA a gagné des centaines de milliers d’utilisateurs mensuels parmi les soignants américains, à un rythme que l’auteur correspondant de l’étude oppose à la diffusion lente, poussée par la réglementation, du dossier médical électronique. La part des jeunes médecins dans les questions est deux fois et demie leur part dans les effectifs, les infirmiers de pratique avancée et les adjoints au médecin lui posent le plus de questions par mois d’activité, et ces questions portent fréquemment sur le traitement et sortent souvent de la spécialité de celui qui les pose. Les débuts de carrière ressortent aussi dans d’autres données sur l’IA : les données d’Anthropic montraient la part des juniors dans ses recrutements techniques tomber de 27 % à 9 %.
L’adoption étant très avancée, reste à savoir si les outils déjà en service peuvent être évalués aussi vite qu’ils se sont diffusés. Waymo publie ses taux d’accidents sur 271 millions de miles sans conducteur, ce qui a permis de comparer ses robotaxis aux conducteurs humains ; les 271 millions de questions cliniques n’ont pas encore d’équivalent mesuré sur les patients. L’IA sait aussi contrôler le travail d’un expert, comme lorsque Claude a revérifié les calculs de thèse d’un physicien et trouvé une erreur de signe. Dans l’expérience de medRxiv, l’expertise des médecins n’a pas suffi à repérer un modèle qui les égarait.
La prochaine étape de l’équipe de Harvard, vérifier si ces outils améliorent les soins, est le résultat à suivre. À surveiller également : ce que Northwestern publiera sur son déploiement au chevet des patients, et la refonte de l’enseignement médical annoncée par Johns Hopkins, selon BankInfoSecurity.
Sources
- Clinician Use of an Artificial Intelligence-Enabled Clinical Information Platform, JAMA (Patel et al.), 15 octobre 2026
- First Large-Scale Study Shows How Doctors Use AI in Medicine, Harvard Medical School, 15 octobre 2026
- Study characterizes clinicians’ use of the AI platform OpenEvidence, Mass General Brigham, via EurekAlert, 15 octobre 2026
- OpenEvidence and Northwestern Medicine Launch Collaboration to Integrate Clinical Evidence into the EHR, Northwestern Medicine, 12 octobre 2026
- OpenEvidence AI Moves Deeper Into Clinical Workflows, BankInfoSecurity (ISMG), 20 octobre 2026
- Subversion of clinical judgment by conversational artificial intelligence, prépublication medRxiv (Barrit et al.), 7 octobre 2026
Image d’en-tête : graphique MACCUS, données Patel et al., JAMA (15 octobre 2026)