
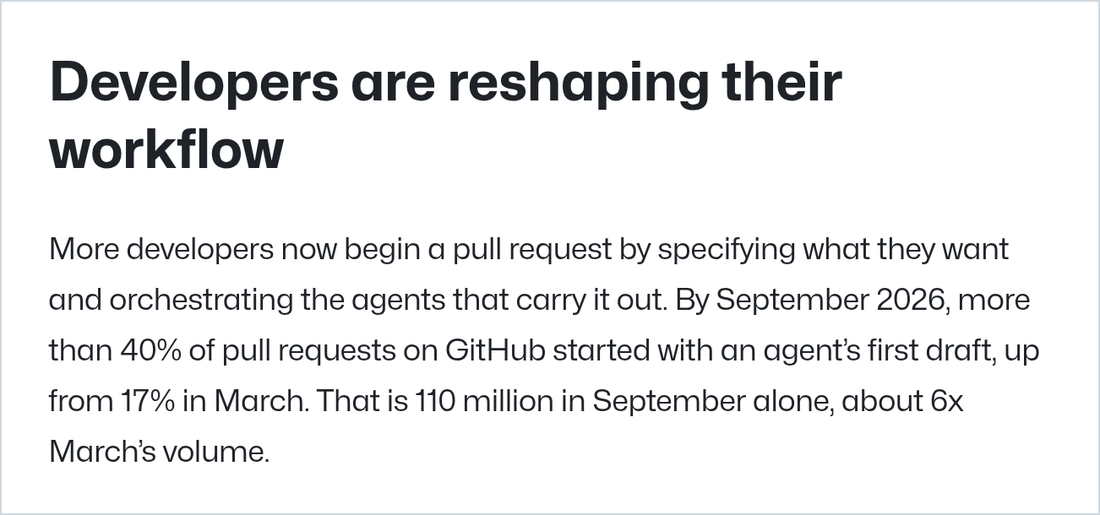
En septembre, plus de 40 % des pull requests ouvertes sur GitHub sont parties d’un premier jet rédigé par un agent IA, contre 17 % en mars, selon le rapport annuel Octoverse de GitHub, publié le 28 octobre 2026. Une pull request est la modification qu’un développeur propose à la relecture avant sa fusion dans le code d’un projet. En septembre, les agents en ont lancé 110 millions, environ six fois le volume de mars.
Les chiffres viennent des mesures internes de GitHub sur les dépôts publics et privés. GitHub appartient à Microsoft, qui vend GitHub Copilot, et le décompte couvre tous les agents de code que GitHub sait détecter.
« Nous en sommes au point où l’IA nous aide à accélérer le rythme de nos entraînements et de nos lancements », a déclaré le même jour Sundar Pichai, le PDG de Google, dans ses remarques pour la présentation des résultats trimestriels d’Alphabet. Il s’attend à voir « l’accélération se poursuivre » au cours des douze prochains mois, « en raison du RSI ». Le sigle désigne l’auto-amélioration récursive (recursive self-improvement) : une IA qui aide à construire une IA meilleure qu’elle.
La mesure de GitHub
GitHub compte comme lancée par un agent toute pull request « dont le premier jet vient d’un agent de code que nous savons détecter ». Le rapport présente ce type de signal comme « un plancher », puisque tous les usages d’agents ne sont pas forcément repérés. L’année étudiée court du 1er octobre 2025 au 30 septembre 2026.
Les pull requests lancées par un agent modifient plus souvent plusieurs fichiers : environ 87 % d’entre elles, contre 79 % des pull requests sans agent détecté. En février, 83 % des pull requests impliquant un agent étaient fusionnées dans les deux semaines, un peu moins que les autres (environ 86 %). En septembre, ce taux atteignait 90 % pour les agents, tandis que le groupe de comparaison restait à 86 % environ.
Les mesures de GitHub montrent une activité « en hausse régulière depuis janvier, puis en forte poussée vers juin ». Le rapport note qu’au même moment sont arrivés de meilleurs modèles, les outils construits autour et les agents qui s’appuient sur les deux, et que les agents ont commencé à tourner aussi à distance, dans le cloud. L’agent cloud de Copilot, à qui un développeur confie une tâche qu’il traite seul, a progressé le plus vite : 230 % sur un an, contre 85 % pour le chat avec agent.
À l’échelle de la plateforme, les développeurs ont enregistré 34,3 milliards de commits sur l’année étudiée, plus du triple du niveau d’il y a deux ans. Sur ces deux ans, les pull requests fusionnées ont plus que triplé, pour atteindre 1,3 milliard, soit 3,5 millions par jour.
Microsoft avance un autre chiffre : plus d’un tiers
Satya Nadella, le PDG de Microsoft, a donné sa propre version lors de la présentation des résultats du groupe, toujours le 28 octobre. Selon lui, « tous les grands agents de code » se sont mis au travail sur GitHub, les pull requests générées par des agents ont été multipliées par six en six mois, et les agents « ouvrent désormais plus d’un tiers de toutes les pull requests de la plateforme ».
Les deux sources n’emploient pas le même verbe. Le rapport compte les pull requests « démarrées avec le premier jet d’un agent », le texte de Nadella celles que les agents « ouvrent », et aucun des deux n’explique comment les chiffres se raccordent.
Nadella a lié cette croissance au travail sur la fiabilité : Microsoft y travaille « très dur » à mesure que l’activité des agents « s’envole » sur GitHub. Le matin même, a-t-il ajouté, GitHub avait annoncé à sa conférence Universe qu’il augmentait ses capacités et reconstruisait « le cœur de l’architecture Git pour la vague des agents ». Git est le système de gestion de versions sur lequel repose chaque dépôt GitHub.
Présent à Universe avec une invitation offerte par GitHub, le développeur et blogueur Simon Willison voit dans les chiffres mis en avant sur scène par Jay Parikh, vice-président exécutif de Microsoft dont les équipes comprennent GitHub, une représentation « assez saisissante » de l’effet de la programmation par agents sur GitHub.
Google et OpenAI tournent l’IA vers leur propre travail
Plus tôt dans ses remarques, Pichai affirmait que « rien que ces dernières semaines », des équipes de Chrome, d’Ads et de Search avaient utilisé Argon pour écrire et optimiser du code bien plus vite, et livré « 35 % de code en plus avec 30 % d’erreurs en moins ». Argon est le modèle Gemini 4 lancé par Google deux semaines avant cette présentation. Google annonçait le jour même un modèle plus puissant, Gemini 4 Carbon, premier de l’Intelligence Index d’Artificial Analysis selon Pichai.
Dans un épisode du podcast Cheeky Pint publié le 29 octobre, son animateur John Collison, cofondateur de Stripe, a interrogé Sam Altman, le patron d’OpenAI, sur la recherche en IA menée par l’IA. « Nous savons aujourd’hui dire : “Trouve-moi un gain d’efficacité de calcul de 5 %” », a répondu Altman. Personne ne sait encore, selon lui, demander à un modèle de découvrir une nouvelle architecture qui marquerait un saut aussi grand que le transformer.
Chez OpenAI, a-t-il raconté, on parle beaucoup des questions qu’il faudrait poser à un futur GPT-7. Il ne suffira probablement pas de dire « Fais-moi du RSI », selon lui, ni de demander un gain d’efficacité de calcul de 5 %. Il pense en revanche que la méthode qui a rendu les modèles d’OpenAI si bons en mathématiques « fonctionnera probablement » appliquée à la recherche en IA.
Le 26 octobre, OpenAI a publié une série de résultats revendiqués, dont une preuve mathématique et un article qui dit réfuter l’hypothèse du temps exponentiel, un postulat de l’informatique formulé en 1999. La preuve sur les équations de Navier-Stokes revendiquée par OpenAI a coûté « de l’ordre de 10 millions de dollars », selon l’estimation de Sam Altman, qui parie qu’OpenAI pourrait la refaire « pour un centième du coût » un an après.
Les angles morts des chiffres
Les 40 % disent qui a produit le premier jet. Ils ne disent pas quelle part du code final vient d’un agent, et le rapport ne donne ni taux d’erreur, ni taux d’annulation, ni temps de relecture pour les pull requests d’agents. Les 90 % correspondent à la part des pull requests d’agents fusionnées dans les deux semaines, et le rapport ne les relie pas à la tenue du code par la suite.
GitHub laisse lui-même les humains au bout de la chaîne : la relecture est « la façon dont les développeurs façonnent ce qui revient » des agents, et « quelqu’un doit encore décider si cela fonctionne, si cela a sa place et si c’est bon ». « Le code s’écrit trois fois plus vite que quiconque ne peut le relire », écrit Dwayne McDaniel sur le blog de GitGuardian, éditeur d’outils de sécurité qui repèrent les mots de passe et les clés oubliés dans le code.
Notre décompte du 20 octobre ne portait que sur le code public : Claude Code a signé à lui seul plus de dix millions de commits publics en septembre, presque tous dans de petits projets que très peu de gens regardent. Le rapport de GitHub couvre en plus les dépôts privés et tous les agents détectables.
Chez Google, les 35 % de code en plus et les 30 % d’erreurs en moins concernent des équipes de trois produits sur « ces dernières semaines », et Pichai n’a pas dit comment ils ont été mesurés. Rien dans ses remarques n’affirme que les modèles de Google s’améliorent désormais sans ingénieurs.
Notre analyse
En six mois, la façon dont les modifications démarrent sur la plus grande plateforme d’hébergement de code a changé : moins d’une pull request sur cinq partait du premier jet d’un agent en mars, plus de deux sur cinq en septembre. GitHub reconstruit le cœur de son service pour absorber ce trafic.
Google et OpenAI, qui fabriquent les modèles, ont décrit l’IA à l’œuvre dans leur propre développement. Google dit que l’IA accélère déjà ses entraînements et ses lancements, et son PDG s’attend à ce que l’accélération se poursuive au cours des douze prochains mois. OpenAI dit savoir confier à un modèle une cible étroite, comme 5 % de calcul économisé, et juge la demande plus ambitieuse, une nouvelle architecture, encore hors de portée.
La boucle que désigne le sigle RSI, un logiciel qui écrit le logiciel servant à construire l’IA, apparaît désormais dans les mesures d’une plateforme et dans les déclarations publiques de trois patrons en deux jours. Elle se mesure pour l’instant en vitesse et en volume. Le seul chiffre de qualité, les 30 % d’erreurs en moins de Google, n’est accompagné d’aucune méthode.
Il faudra voir si GitHub publie des temps de relecture ou des taux d’annulation pour les pull requests d’agents, si la part continue de grimper quand la poussée de juin aura un an, si le nouveau cœur Git tient sous le trafic des agents et si Google met un chiffre sur le rythme de ses entraînements et de ses lancements.
Sources
- Octoverse: Commits, pushes, reach new highs in 2026 as developers build with agents, GitHub, 28 octobre 2026
- Microsoft Fiscal Year 2027 First Quarter Earnings Conference Call, Microsoft, 28 octobre 2026
- Q3 2026 earnings call: Remarks from our CEO, Sundar Pichai, Google, 28 octobre 2026
- Transcript: Why Sam Altman is against a single superintelligence, Cheeky Pint (John Collison), 29 octobre 2026
- GitHub Octoverse 2026, Simon Willison, 28 octobre 2026
- GitHub Octoverse 2026: AI Agents, Citizen Developers, and the New Security Reality, Dwayne McDaniel, GitGuardian, 29 octobre 2026
Image d’en-tête : graphique MACCUS, données du rapport GitHub Octoverse 2026 (28 octobre 2026)