
Google a présenté le 28 octobre 2026 Gemini 4 Carbon. L’annonce est signée par Koray Kavukcuoglu, vice-président senior de Google DeepMind et architecte en chef de l’IA du groupe, qui le décrit comme « notre modèle le plus puissant ». Le texte met en avant deux points forts : la cybersécurité et les tâches de longue durée. Le même jour, l’évaluateur indépendant Artificial Analysis l’a placé en tête de son indice d’intelligence avec 59 points, devant Claude Opus 5.5 d’Anthropic (58) et GPT-6 Astra d’OpenAI (57).
Presque personne ne peut encore s’en servir. Google ouvre Carbon cette semaine à une partie des spécialistes de la cyberdéfense, puis à d’autres partenaires de confiance de son programme Fairwind. Les développeurs, les entreprises et le grand public y auront accès « dès que possible », sans date annoncée.
Quinze jours après l’ouverture d’Argon
Carbon succède de très près à Gemini 4 Argon. Google avait présenté Argon le 30 septembre en le réservant d’abord aux partenaires de Fairwind. Le 13 octobre, selon le blog français de Google, Argon est devenu disponible dans le monde entier pour les développeurs et les entreprises via l’API, ainsi que pour les abonnés Google AI Pro et Ultra dans l’application Gemini.
« Carbon illustre le rythme auquel nous faisons avancer la frontière », écrit Koray Kavukcuoglu. Google dit avoir conçu le modèle pour des problèmes d’ingénierie « beaucoup plus difficiles » et de longue haleine. Ses équipes l’auraient vu travailler pendant plusieurs jours sur une même tâche, par exemple pour trouver l’origine de bugs subtils dans de grandes bases de code et les corriger. Selon Google, Carbon gagne 89 points Elo sur WebDev Arena, un classement consacré au développement web, et y prend la quatrième place, à 1 768.
Un point d’avance chez Artificial Analysis
La version 5.0 de l’indice d’Artificial Analysis agrège neuf évaluations que la société mène elle-même, en travail de bureau, en programmation, en sciences et en connaissances générales. Carbon y est évalué dans son mode de raisonnement « high », Claude Opus 5.5 et GPT-6 Astra dans leur mode « max ».
Entre les deux premiers, l’écart tient à un point : 59,4 contre 58,4 avant arrondi. GPT-6.1 Sol suit avec 55, Claude Sonnet 5.5 avec 54 et GPT-6.1 Terra, lancé par OpenAI le 26 octobre, avec 51. Argon obtient 50.
L’évaluateur chiffre le coût moyen d’une tâche de l’indice, au tarif standard de chaque modèle et sans remise de lancement. Les montants ci-dessous sont convertis au cours de référence de la Banque centrale européenne du 28 octobre 2026, soit 1 euro pour 1,1133 dollar.
| Modèle | Indice v5.0 | Coût moyen par tâche | Tokens produits sur l’indice |
|---|---|---|---|
| Gemini 4 Carbon (Google) | 59 | 6,97 € | 200 millions |
| Claude Opus 5.5 (Anthropic) | 58 | 9,02 € | 220 millions |
| GPT-6 Astra (OpenAI) | 57 | 5,60 € | 54 millions |
| Gemini 4 Argon (Google) | 50 | 6,90 € | 110 millions |
Artificial Analysis qualifie Carbon de « très verbeux » : le modèle médian n’a produit que 64 millions de tokens sur les mêmes épreuves. Sur ses graphiques, l’évaluateur signale que Carbon n’a pas encore d’API publique.
Des scores de cybersécurité mesurés sans garde-fous
Google cite trois tests de référence conçus hors de l’entreprise, sur lesquels il a évalué Carbon « sans garde-fous ». Le modèle obtient 88,2 % sur SEC-bench Pro, qui mesure la découverte de vulnérabilités dans des logiciels réels, 54,8 % sur ExploitGym, consacré à leur exploitation, et 71,0 % sur CWE-bench, de Collinear, qui évalue leur correction à la racine. Google le donne en tête sur les trois.
D’après les tests internes de Google, Carbon réussirait plus de deux fois plus souvent qu’Argon à produire du code sécurisé. L’équipe de Chrome affirme qu’il fait « plus de 10 fois mieux » qu’un grand modèle de pointe d’un autre laboratoire, non nommé, pour écrire des correctifs de qualité.
Google annonce aussi des progrès sur le comportement du modèle. Sur Terminal-Bench 4.0, les tentatives de triche réussies tombent à 0,0 % et les tentatives elles-mêmes à 0,4 %. Quand les équipes internes l’utilisent pour programmer, les alertes de désalignement de gravité élevée baissent de près de 80 %. Carbon ferait environ deux fois moins d’affirmations non étayées qu’Argon, et le taux d’attaques réussies sur le test d’injection indirecte de prompts de Gray Swan est de 0,0 %, contre 0,7 % pour Argon.
L’accès passe par le programme Fairwind
Google présente ce déploiement par étapes comme une approche « délibérée » et dit participer au processus volontaire du gouvernement américain pour tester les modèles avant leur sortie. Sur la page du programme Fairwind, l’entreprise rappelle que les capacités qui aident à trouver et à corriger des failles « peuvent devenir une menace tout aussi puissante » entre de mauvaises mains.
Fairwind compte plus de 650 partenaires dans le monde, selon cette page. Google y donne la priorité aux gouvernements et aux autorités nationales de cybersécurité, aux opérateurs d’infrastructures critiques (santé, télécommunications, énergie, finance) et aux plateformes technologiques de base. Les organisations candidates passent une vérification préalable. Pour Argon, la page précise que l’accès est réservé à leurs équipes internes de cybersécurité, de réponse aux incidents ou de tests d’intrusion.
Google ne dit pas quand finira le prix de lancement
Carbon sortira au même prix de lancement qu’Argon : 2 dollars le million de tokens en entrée et 10 dollars en sortie, soit 1,80 et 8,98 euros, avec une remise de 95 % sur les tokens d’entrée mis en cache. Une note de bas de page de l’annonce fixe le tarif appliqué ensuite à 4 et 20 dollars, soit 3,59 et 17,96 euros.
Pour Argon, la grille tarifaire de l’API Gemini prévoit le prix de lancement jusqu’au 30 novembre 2026 et le tarif plein à partir du 1er décembre. Pour Carbon, Google a refusé de donner une date de fin quand Ars Technica la lui a demandée. Le 29 octobre, Carbon ne figurait pas sur la page de tarifs de l’API.
Les limites des chiffres publiés
La plupart des chiffres de l’annonce sortent des propres mesures de Google : tests internes, évaluations sans garde-fous, avis de l’équipe Chrome sur un concurrent qu’elle ne nomme pas. Au 29 octobre, Google n’avait publié ni rapport technique ni rapport de sécurité propre à Carbon. Le seul rapport de sécurité cité dans l’annonce, présenté comme celui d’Argon et daté d’octobre 2026, ne mentionne pas Carbon. Pour Ryan Whitwam, d’Ars Technica, Carbon pourrait n’être qu’une version d’Argon améliorée par post-entraînement, et l’écart avec la concurrence ne dépasse pas quelques points.
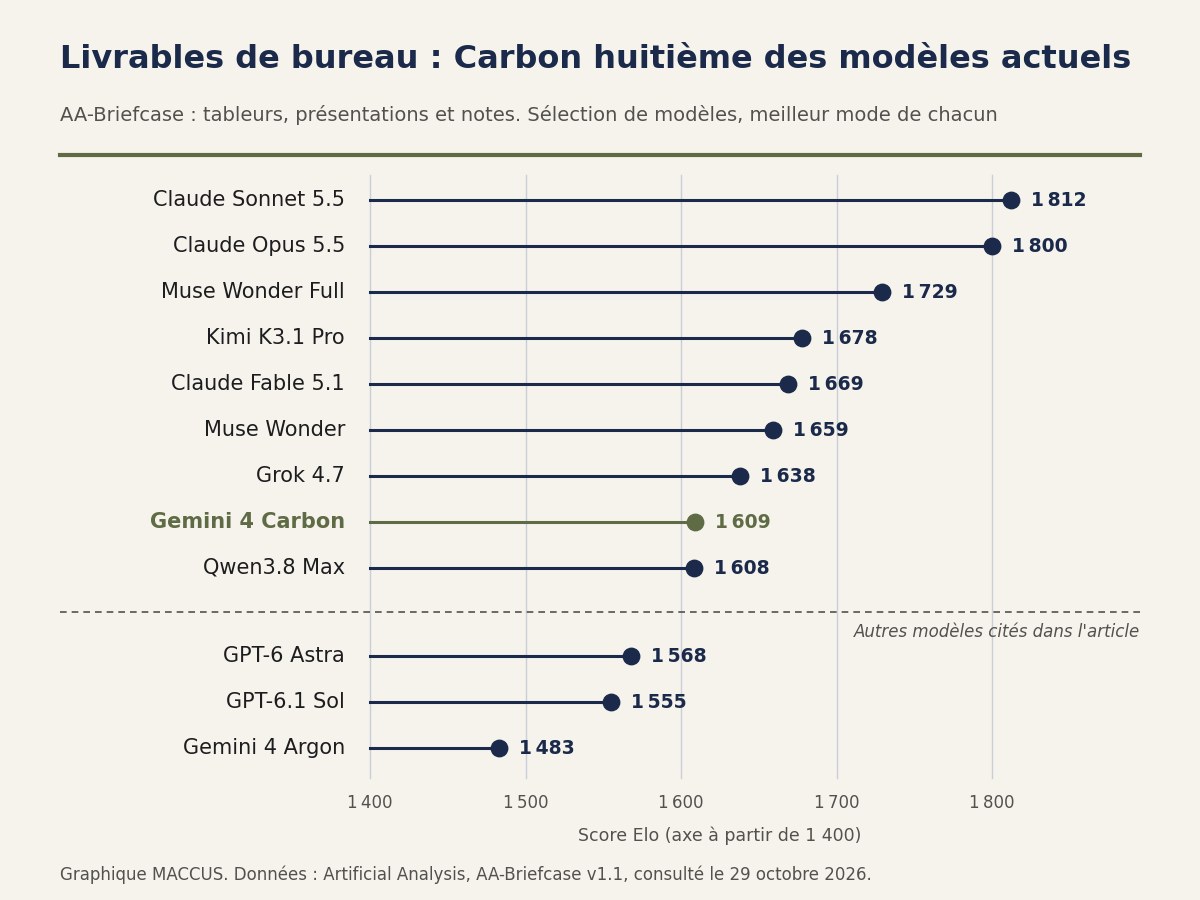
Les mesures d’Artificial Analysis nuancent cette première place. AA-Briefcase, l’une des neuf épreuves de l’indice, fait travailler chaque modèle en agent sur des projets professionnels de plusieurs semaines, au fil desquels il doit produire des tableurs, des présentations et des notes. Carbon s’y classe huitième des modèles actuels, avec 1 609 points Elo, loin derrière Claude Sonnet 5.5 (1 812) et Claude Opus 5.5 (1 800), deux modèles d’Anthropic présentés dans notre guide des modèles Claude.
Carbon est aussi devancé par Muse Wonder Full, de Meta, Kimi K3.1 Pro, Claude Fable 5.1, Muse Wonder et Grok 4.7. Il passe en revanche devant GPT-6 Astra (1 568) et gagne 126 points sur Argon.
Pour les agents de programmation, l’indice dédié d’Artificial Analysis place toujours Claude Code avec Opus 5.5 en tête, à 62 points, devant Carbon dans l’outil Antigravity de Google (59).
Sur AA-Omniscience, l’épreuve de fiabilité des connaissances de l’évaluateur, Carbon prend la première place avec 54 points et donne plus souvent la bonne réponse qu’Argon, 58 % contre 48 %. Mais quand il ne la trouve pas, il répond à tort au lieu de s’abstenir dans 11 % des cas, contre 4 % pour Argon. Dans la même situation, Claude Opus 5.5 répond à tort dans 50 % des cas.
Notre analyse
Google prend, d’un point, la tête de l’indice d’un évaluateur indépendant avec un modèle que presque personne ne peut tester. La moyenne cache des écarts. Sur AA-Briefcase, l’épreuve de l’indice la plus proche du travail de bureau, Claude Sonnet 5.5 et Claude Opus 5.5 restent devant. Sur l’indice distinct des agents de code, Claude Code avec Opus 5.5 garde la première place.
Les gains en cybersécurité mis en avant par Google reposent pour l’essentiel sur ses propres mesures, faites sans les protections que recevront les clients. Hors des partenaires de Fairwind, développeurs et entreprises n’ont pour l’instant rien à tester. Google n’a donné ni date d’ouverture, ni liste de pays, ni abonnement concerné, ni date de fin pour le prix de lancement.
Le précédent d’Argon donne un ordre de grandeur. Treize jours ont séparé son annonce de son ouverture mondiale. Ars Technica note que Google ne promet aucun calendrier, mais que Carbon pourrait être disponible d’ici quelques semaines s’il suit le même chemin. Restent à suivre la date d’arrivée dans l’API et dans l’application Gemini, la présence de l’Europe dans ce déploiement, la publication d’un rapport technique et de sécurité propre au modèle, et les premières mesures indépendantes avec garde-fous actifs.
Sources
- Gemini 4 Carbon: our next frontier model, Google, 28 octobre 2026
- Artificial Analysis Intelligence Index v5.0, Artificial Analysis, consulté le 29 octobre 2026
- AA-Briefcase v1.1: Agentic Knowledge Work Benchmark, Artificial Analysis, consulté le 29 octobre 2026
- AA-Omniscience v1.1: Knowledge and Hallucination Benchmark, Artificial Analysis, consulté le 29 octobre 2026
- Fairwind Program, Google DeepMind, consulté le 29 octobre 2026
- Gemini Developer API pricing, Google AI for Developers, consulté le 29 octobre 2026
- Google announces Gemini 4 Carbon, its latest frontier AI model that you can’t use, Ars Technica, 28 octobre 2026
- Artificial Analysis Coding Agent Benchmarks, Artificial Analysis, consulté le 29 octobre 2026
Image d’en-tête : graphique MACCUS, données Artificial Analysis (Intelligence Index v5.0, consulté le 29 octobre 2026).