Le 31 octobre 2026, DeepSeek a publié sur GitHub dsh-superagent-prototype, un agent de code proactif sous licence MIT, limité à un dépôt. Le même jour, l’équipe DeepSeek Harness a décrit sur WeChat son « Super-agent », un agent IA toujours en ligne qui réagit aux événements d’une équipe et dont le prototype reprend une partie. Selon l’équipe, quand une personne suit plusieurs agents à la fois, c’est son attention qui fixe la limite. La page du dépôt prévient en gras qu’il s’agit d’un « prototype de recherche, fourni à titre de référence uniquement, qui n’est pas un produit officiel de DeepSeek ».
Le 1er novembre, Bloomberg y a vu une tentative de concurrencer Claude Code, l’agent de code d’Anthropic, et le South China Morning Post un épisode de la course aux agents de code entre DeepSeek, OpenAI et Anthropic. Les textes de DeepSeek ne font aucune comparaison de ce genre. La publication intervient dix jours après le lancement par Anthropic de Claude Duet, un agent qui prend lui-même les devants, pour l’instant réservé aux États-Unis.
Le dépôt compte un seul commit, signé « DeepSeek Harness Team », et affichait le 1er novembre en début d’après-midi (heure de Paris) environ 5 600 étoiles et 530 copies (forks). Le prototype se greffe sur DeepSeek Harness, l’environnement d’agents open source que l’entreprise propose en préversion publique et dont le dépôt, ouvert le 13 août, dépasse 260 000 étoiles. Le 17 octobre, DeepSeek avait déjà ouvert aux développeurs une API de recherche web vendue à l’appel.
Trois à cinq sessions par personne
L’article, écrit par Yujia Qiao, qui a aussi réalisé le système, prévient d’emblée que ses pistes d’architecture ne décrivent pas les fonctions actuelles de DeepSeek Harness. Il part du constat que les agents travaillent encore session par session, ce qui oblige l’utilisateur qui mène plusieurs chantiers à passer de l’une à l’autre en gardant chaque contexte en tête.
« D’après nos observations, une personne ne peut généralement suivre que 3 à 5 sessions actives en même temps », écrit l’équipe. Dans ce schéma, conclut-elle, la limite d’une tâche isolée tient aux capacités du modèle, et celle du travail sur plusieurs tâches, à l’attention humaine. Le Super-agent doit donc être continu, efficace, proactif et persistant. Persistant signifie ici toujours en ligne et capable de se rétablir seul après un incident.
Dans l’instance que DeepSeek fait tourner en interne, une même tâche passe sans rupture d’une messagerie de groupe à une pull request GitHub. Cette instance suit aussi un groupe de discussion public et, sans que personne la sollicite, localise l’origine d’un bug puis soumet un correctif. Une règle baptisée « reproduire et corriger en silence » lui fait traiter en arrière-plan chaque problème signalé. L’instance ne livre un résultat que si elle a confirmé le problème et trouvé un correctif simple ; sinon, elle se tait.
Un routeur qui répartit, des workers qui exécutent
L’architecture repose sur deux étages. Un « routeur » (Router) permanent reçoit toutes les demandes des humains et répartit le travail sans exécuter lui-même de tâche ; il peut même se passer de l’outil Bash et tourner sur un modèle plus léger. Les « workers » sont des sessions isolées, dotées de tous les outils et en général du modèle le plus puissant. Ils rendent compte au routeur, seul à répondre aux humains.
Messages de groupe, e-mails, rappels d’agenda, commentaires de revue de code et résultats d’intégration continue deviennent des « déclencheurs » (Triggers). Des règles codées les trient d’abord selon la source, le groupe ou l’expéditeur, puis le modèle juge ceux qui restent. La suite d’un fil confié à un worker, par exemple une pull request, lui parvient directement, sans repasser par le routeur. Une session séparée, le « Watchdog », vérifie à intervalles réguliers que chaque worker avance et répare les pannes.
L’équipe propose enfin d’héberger la boucle de l’agent dans le cloud et de laisser en place les machines de travail, où un petit programme exécute les commandes. Elle juge ce choix cohérent avec la séparation du « cerveau » et des « mains » proposée par Anthropic.
Des mesures préliminaires, sur une charge simulée
Les essais de la section 7.1 comparent quatre configurations sur un flux simulé de messages de groupe et de résultats d’intégration continue. Chaque essai, répété cinq fois par configuration, compte environ 300 messages, dont une vingtaine de demandes de travail noyées parmi les discussions, les relances, les demandes d’arrêt et les messages automatiques. Un outil qui se contente d’attendre remplace la programmation, et les intervalles comme les durées de travail sont réduits au quart. L’essai mesure donc, selon l’équipe, l’ordonnancement et la coordination du travail.
Le Super-agent termine une tâche en 12,4 minutes en médiane et en 15,7 minutes au 95e centile. En face, une session unique dotée d’un outil de sous-agent peut confier un morceau de travail à une session secondaire. Avec une consigne neutre, elle n’a jamais délégué en cinq essais, et son 95e centile atteint 29,5 minutes. Incitée à déléguer, elle l’a fait dans quatre essais sur cinq et reste plus lente que le Super-agent.
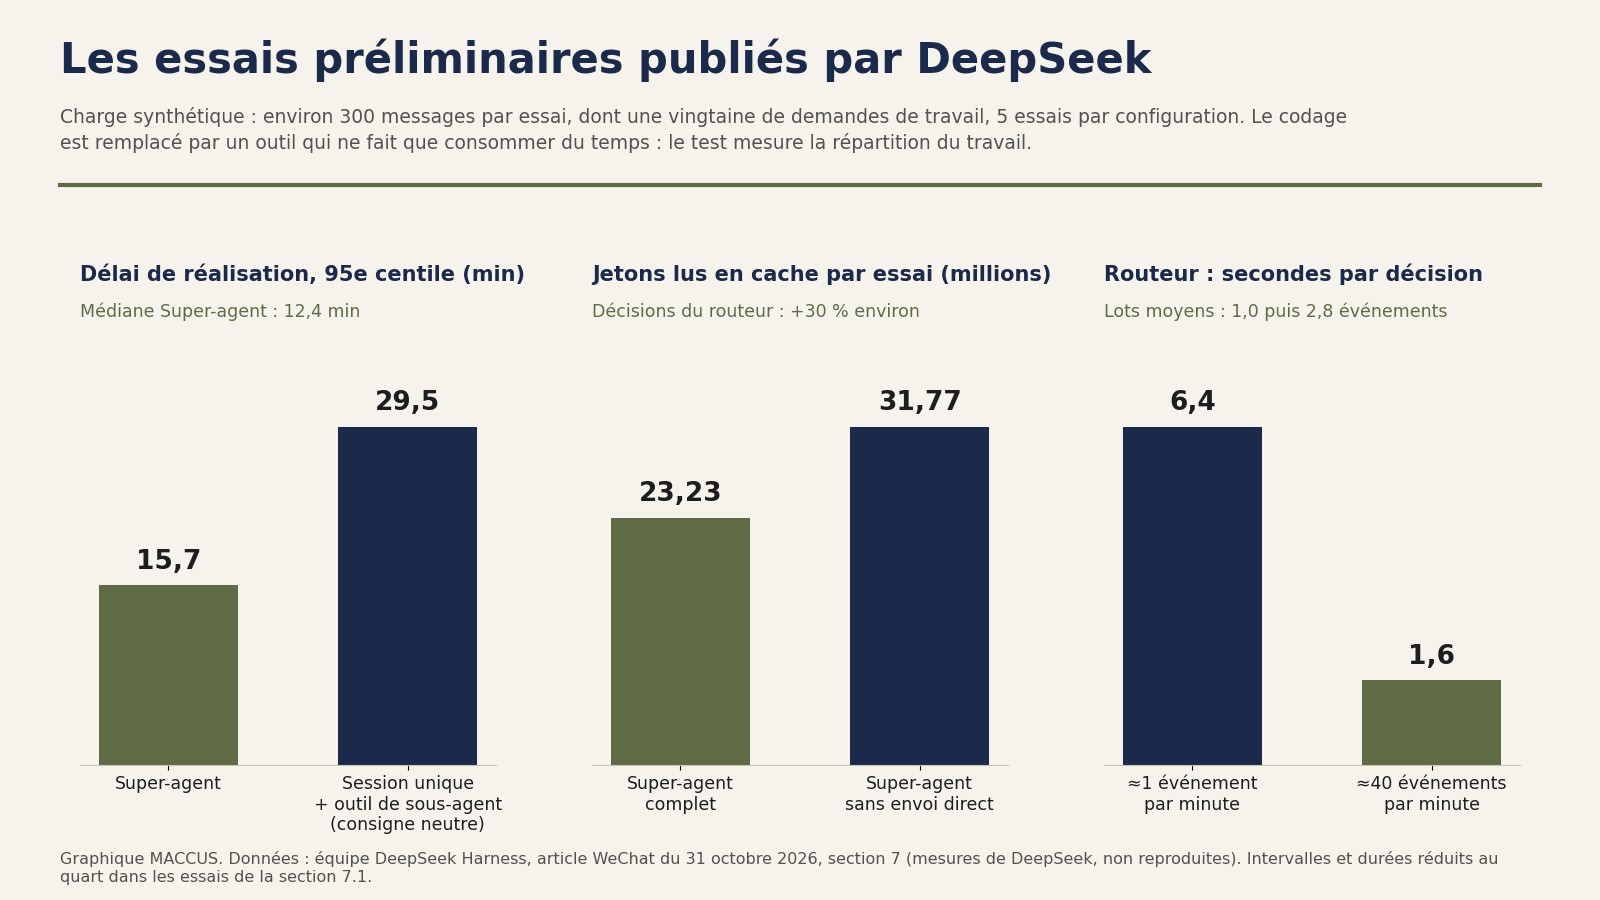
En contrepartie, le Super-agent, qui entretient plusieurs sessions, lit davantage de jetons en cache qu’une session unique. Sans l’envoi direct des fils à leur worker, les délais restent presque identiques, mais le routeur prend environ 30 % de décisions en plus et les jetons lus en cache passent de 23,23 à 31,77 millions par essai (environ +37 %). Dans un test de charge séparé, quand le flux monte d’environ 1 à 40 événements par minute, les lots du routeur passent en moyenne de 1 à 2,8 événements et son temps d’inférence par décision tombe de 6,4 à 1,6 seconde. DeepSeek présente ces résultats comme « une référence préliminaire ».
Le prototype publié sur GitHub
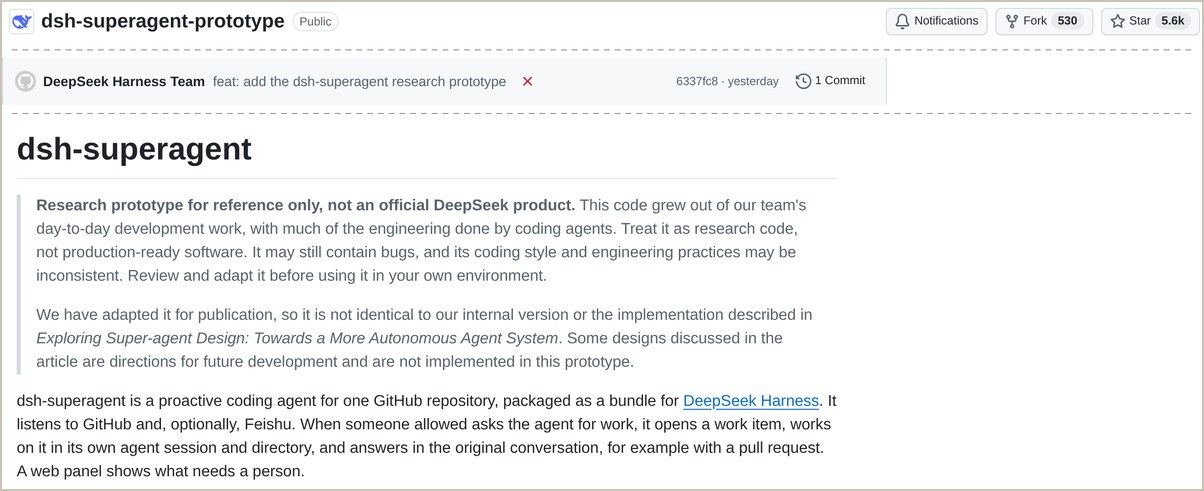
Le prototype dsh-superagent surveille un dépôt GitHub et, en option, des conversations Feishu, la messagerie professionnelle de ByteDance. Quand une personne autorisée lui demande du travail, il ouvre une fiche, travaille dans sa propre session et son propre répertoire, puis répond dans la conversation d’origine, par exemple avec une pull request. Un panneau web n’affiche que ce qui demande une intervention humaine.
Pour l’installer, on demande à son agent de code de lire le fichier SETUP.md. Le prototype arrive alors que, selon GitHub, plus de 40 % des pull requests de septembre sont parties d’un premier jet d’agent IA.
Selon la documentation, l’agent n’agit qu’à la demande d’une personne autorisée par l’équipe, ou si une règle écrite par celle-ci le permet. Le travail non demandé démarre en mode d’observation, où l’agent note seulement ce qu’il aurait fait. Le guide d’installation recommande pour l’agent un compte GitHub distinct de celui de l’opérateur, et déconseille au départ la fusion automatique des pull requests. Les sessions de travail exécutent pourtant leurs commandes sans demander d’approbation, avec le compte système de l’opérateur.
La page de présentation précise que le code est né du travail quotidien de l’équipe, qu’une bonne part a été écrite par des agents de code et qu’il peut encore contenir des bugs. Il diffère de la version interne comme de l’implémentation décrite dans l’article, dont certaines idées restent des pistes. Le comportement que retiennent Bloomberg et le South China Morning Post, la correction de bugs sans sollicitation, relève de l’instance interne. Dans le prototype, ce travail exige une règle écrite et commence en simple observation.
Les limites que DeepSeek reconnaît lui-même
Dans sa section sur la sécurité, l’équipe note qu’un agent déclenché par son environnement s’expose davantage à des contenus non fiables. Si la boucle hébergée dans le cloud était compromise, par une intrusion sur le serveur ou une injection de consignes (prompt injection), toutes les machines reliées risqueraient d’être détournées. Même sans attaque, des identifiants qui entrent dans le contexte du modèle peuvent fuiter. Tant que ces questions ne sont pas réglées, écrit l’équipe, un Super-agent ne peut fonctionner que dans un périmètre restreint et de confiance.
L’article laisse aussi ouverts le passage à l’échelle du routeur, la mémoire sur plusieurs mois et la coopération entre agents cloisonnés, dans une organisation ou entre organisations. Cité par le South China Morning Post, l’entrepreneur pékinois Liu Ming a écrit sur Zhihu que le défi du développement logiciel par IA est aujourd’hui d’assurer la fiabilité plutôt que d’aller plus vite.
Notre analyse
Pour DeepSeek, dans les équipes qui utilisent déjà des agents de code, le goulot d’étranglement se déplace vers l’attention de la personne qui suit plusieurs sessions. Sa réponse confie ce suivi au système, avec un interlocuteur unique et des exécutants isolés. Anthropic avance dans la même direction avec Claude Duet, sous la forme d’un assistant personnel.
Les chiffres mesurent l’organisation du travail sur une charge simulée où une minuterie remplace la programmation. Ils viennent de DeepSeek seul, et aucune mesure indépendante n’était publiée au 1er novembre. Les gros titres anglophones sur un rival de Claude Code décrivent mal un prototype dont DeepSeek écrit qu’il n’est pas un produit officiel.
Le passage sur la sécurité pèse plus lourd que les chiffres. Un agent qui lit les conversations d’une équipe et exécute des commandes sans approbation, avec le compte système de son opérateur, cumule deux risques connus, les contenus piégés et les identifiants exposés. DeepSeek en convient et classe la question parmi ses problèmes ouverts.
Reste à savoir si l’architecture entrera dans DeepSeek Harness, où le traitement asynchrone des tâches longues existe déjà sans être activé par défaut, et en quoi l’instance interne diffère du code publié. Seules des mesures indépendantes, sur de vraies tâches de code, diront si ce gain se confirme.
Sources
- Super-agent 设计探索:迈向更自主的 Agent 系统, équipe DeepSeek Harness (WeChat), 31 octobre 2026
- deepseek-ai/dsh-superagent-prototype (README), DeepSeek (GitHub), 31 octobre 2026
- 000 Philosophy, DeepSeek (GitHub), 31 octobre 2026
- 003 Execution, DeepSeek (GitHub), 31 octobre 2026
- SETUP.md, DeepSeek (GitHub), 31 octobre 2026
- DeepSeek Harness, DeepSeek, page consultée le 1er novembre 2026
- DeepSeek Drops Enhanced Coding Agent With Aim to Rival Anthropic, Bloomberg (Debby Wu), 1er novembre 2026
- DeepSeek unveils AI ‘super agent’ in coding race with OpenAI, Anthropic, South China Morning Post (Ben Jiang), 1er novembre 2026
Image d’en-tête : schéma MACCUS d’après l’article de l’équipe DeepSeek Harness (WeChat, 31 octobre 2026).