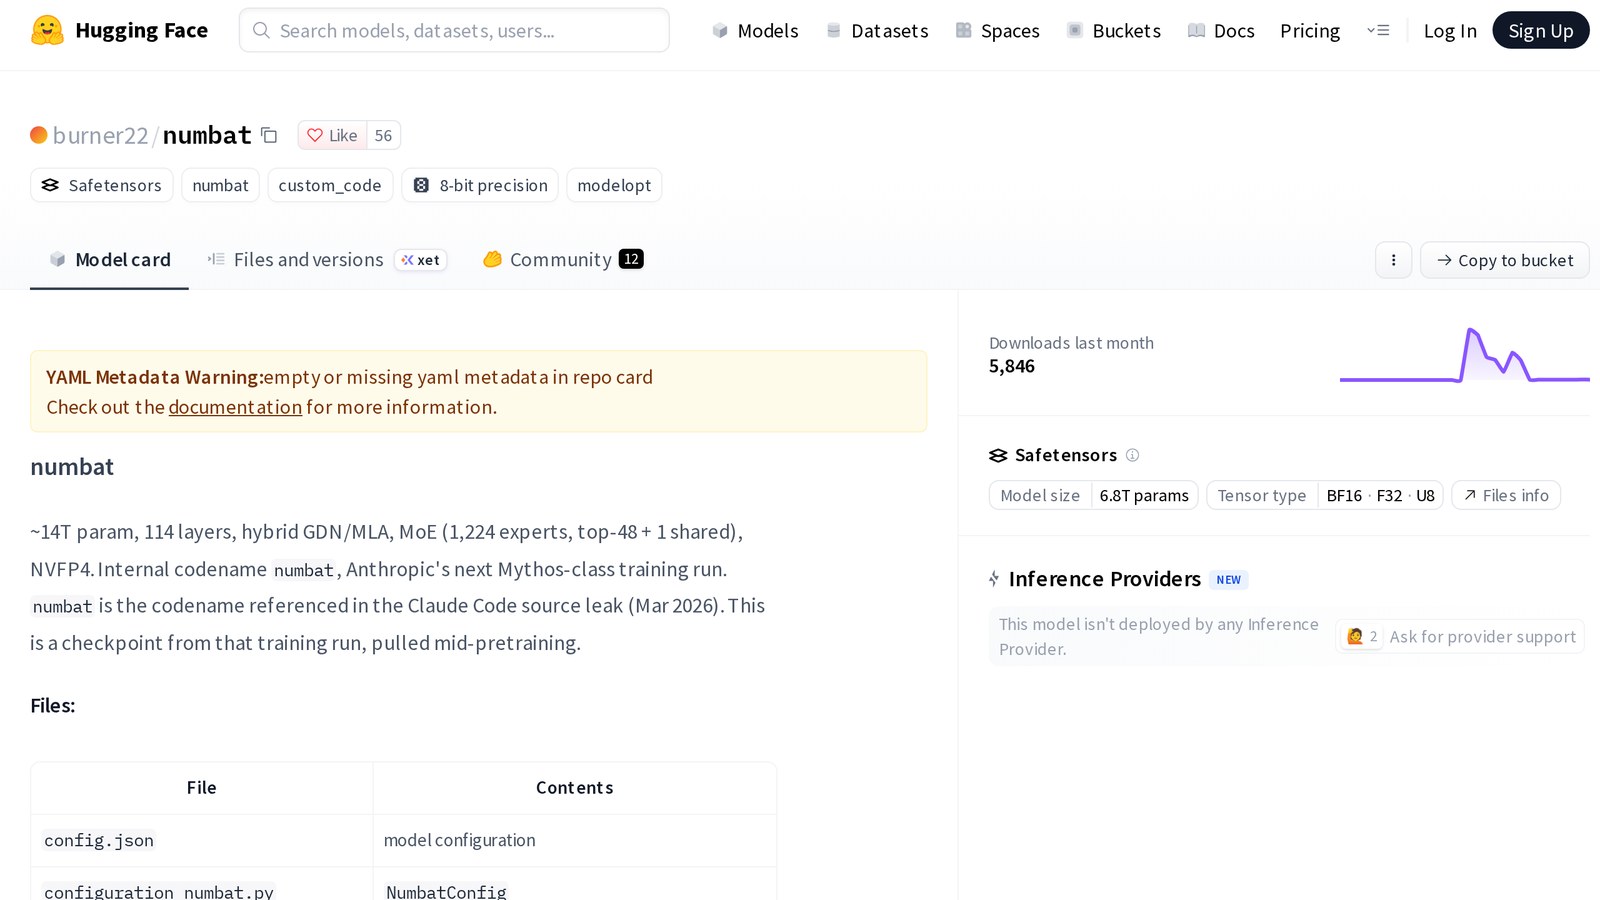

Depuis le 23 octobre 2026, un compte anonyme de la plateforme Hugging Face, burner22, héberge un dépôt baptisé numbat : 772 fichiers de poids, 7,72 téraoctets au total, présentés comme un point de contrôle du « prochain entraînement de classe Mythos » d’Anthropic. Dimanche 1er novembre, le dépôt s’est répandu sur Reddit et dans les discussions de Hugging Face, alors que sa page affichait 5 846 téléchargements. À 16 h 46, heure de Paris, un utilisateur de la plateforme a publié une analyse statistique selon laquelle ces poids auraient été tirés au hasard par un script, sans jamais avoir été entraînés. À 17 h 29, un second utilisateur a publié une vérification reproductible : 43 tenseurs du dépôt se régénèrent à l’identique à partir de leur seul nom.
Au 1er novembre 2026 à 17 h 40, ni Anthropic ni Hugging Face n’ont réagi et personne n’a montré que ces poids produisent quoi que ce soit. Mise à jour : cet article sera complété, avec la date et l’heure, à chaque élément nouveau.
Chez Anthropic, Mythos désigne une gamme de modèles plus grands et plus puissants qu’Opus. Le 23 octobre, l’institut britannique AISI et Anthropic ont détaillé un test où Claude Mythos 5 s’est acharné sur un vrai développeur. Une copie de ces modèles en libre accès serait une première, d’où l’emballement de dimanche.
Un dépôt de 7,72 téraoctets et sa foire aux questions
Le compte burner22, ouvert le 16 octobre et affiché sous le nom « burner », ne contient que ce dépôt. Ses 772 fichiers au format safetensors pèsent environ 10 Go chacun et ont été mis en ligne un par un les 23 et 24 octobre.
La page décrit un modèle d’environ 14 000 milliards de paramètres sur 114 couches, dont l’architecture hybride combine deux mécanismes d’attention récents, Gated DeltaNet et Multi-head Latent Attention. Ce « mélange d’experts » compterait 1 224 sous-réseaux, dont 48 sollicités pour chaque token (fragment de mot), plus un expert partagé. Ses poids sont stockés en NVFP4, un format de 4 bits conçu par Nvidia. L’ensemble serait un point de contrôle « prélevé en plein pré-entraînement », à l’étape 1 830 000 d’un entraînement prévu sur environ 1,96 million d’étapes, sans réglage ultérieur.
La foire aux questions est expéditive. « Comment l’avez-vous obtenu ? Je ne peux pas en dire plus que ce qui est déjà dans le dépôt. » « Est-ce réel ? Oui. » Puis : « Miroirs bienvenus. Ne m’écrivez pas pour demander la source. »
Deux fichiers texte servent de pièces justificatives. Le premier attribue au modèle, pour une évaluation datée du 8 octobre, 88,49 % au test de culture générale MMLU, 72,01 % au test de raisonnement ARC-Challenge et 88,96 % au test HellaSwag (score normalisé). Le second reproduit environ 400 lignes d’un journal d’entraînement daté du même jour.
Faire tourner le modèle demanderait de loger 7,7 To en mémoire de calcul. Le dépôt évoque lui-même environ 85 puces Trainium2 d’Amazon Web Services, « rien que pour contenir ces poids ».
Le seul lien vérifiable avec Anthropic
Ce lien tient au nom de code. Le 31 mars 2026, Anthropic a publié par erreur sur le registre npm la version 2.1.88 de Claude Code, avec un fichier de débogage qui exposait son code source, soit environ 512 000 lignes. VentureBeat y a relevé plusieurs noms de code internes : Capybara, Fennec (associé à Opus 4.6) et Numbat, un modèle non publié « toujours en test ». Le dépôt cite un commentaire de ce code, « Remove this section when we launch numbat », repris par plusieurs analyses de la fuite.
Selon Fortune, la fuite du 31 mars « n’a pas exposé les poids du modèle Claude lui-même », et Anthropic l’a attribuée à « un problème d’empaquetage dû à une erreur humaine, pas une faille de sécurité ».
Les deux autres épisodes liés à Mythos ne touchaient pas davantage des poids. Fin mars, près de 3 000 fichiers internes, dont un brouillon d’article sur Mythos, avaient été rendus publics par erreur ; en avril, d’après Fortune, qui cite Bloomberg, un groupe réuni sur Discord a utilisé Mythos Preview par l’environnement d’un prestataire.
Les doutes accumulés en quelques heures
Dans les discussions du dépôt, trois signalements ont été déposés entre 15 h 36 et 17 h 08, dont l’un mentionne « cela ressemble à un logiciel malveillant ».
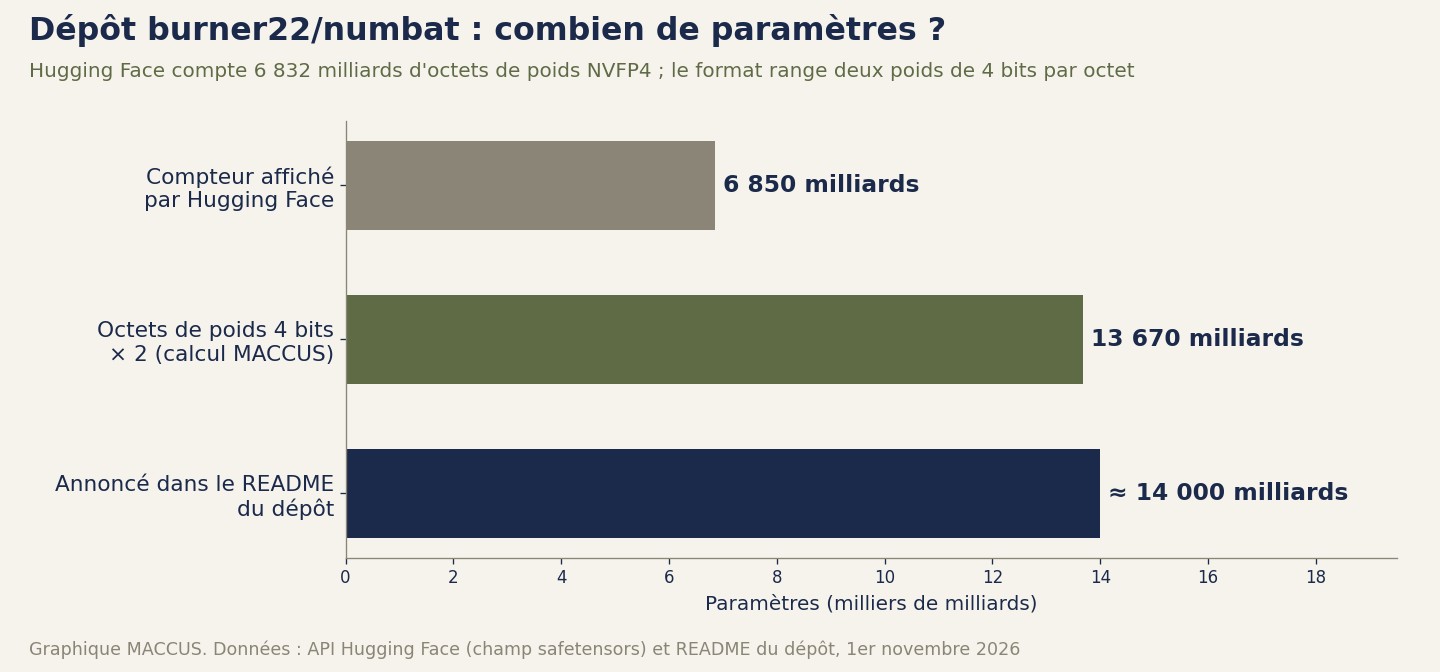
À 16 h 01, un utilisateur a relevé l’écart entre le compteur de Hugging Face, qui affiche 6,8 billions de paramètres (6 850 milliards), et les 14 000 milliards annoncés. Il a aussi douté que des puces Trainium2 exploitent le format NVFP4, que la documentation d’AWS ne mentionne pas selon lui, et jugé faible pour un modèle de pointe un score de 72 % à l’ARC-Challenge.
L’écart de paramètres a une explication simple. Hugging Face compte 6 832 milliards d’octets de poids 4 bits, et le format NVFP4 range deux poids par octet. Notre calcul donne environ 13 670 milliards de paramètres, proche des 14 000 annoncés : le chiffre ne prouve donc rien, ni dans un sens ni dans l’autre.
À 16 h 46, rairenter a publié l’analyse la plus détaillée. Il dit avoir lu des fragments des fichiers par requêtes partielles, sans télécharger les 7,72 To. Selon lui, des blocs du réseau qui reçoivent exactement les mêmes données affichent des facteurs d’échelle sans rapport entre eux, répartis comme s’ils sortaient d’un générateur aléatoire entre 0,05 et 0,4.
Les poids de normalisation suivraient une loi normale pure, sans les valeurs extrêmes et les corrélations entre couches qu’on observe dans un modèle entraîné. Les noms des tenseurs reprendraient aussi ceux de l’implémentation de DeepSeek-V3 publiée sur Hugging Face. Sa conclusion : un canular soigné qui profite du nom de code divulgué en mars.
À 17 h 29, FloxUnder est allé plus loin dans une autre discussion. Il affirme avoir régénéré bit pour bit 43 tenseurs complets, soit 730 368 valeurs, à partir de leur seul nom, dont l’empreinte SHA-256 sert de graine au générateur aléatoire de la bibliothèque NumPy. Il dit avoir prédit avant lecture les valeurs de 21 autres tenseurs, toutes confirmées, et publie un script de vérification qui ne télécharge qu’environ 90 Ko. Il précise que ce test ne couvre pas tous les tenseurs et ne peut exclure des paramètres volontairement gelés pendant l’entraînement, mais y voit une preuve forte contre un point de contrôle authentique.
Nous n’avons reproduit aucune de ces deux analyses, qui supposent de lire des fragments des fichiers de poids. Nous avons en revanche vérifié le journal d’entraînement fourni. Ses sept lignes d’évaluation donnent toutes le même score à l’ARC-Challenge, 0,7083, calculé sur 24 questions seulement : un échantillon dérisoire pour suivre un entraînement de cette ampleur, relevait aussi rairenter.
Sur Reddit, le fil ouvert à 15 h 59 sur r/accelerate a vite tourné au scepticisme. « Probablement un faux élaboré », résume u/ConstantinSpecter à 16 h 06, en citant l’architecture « mélange de DeepSeek et de Qwen » et des journaux d’entraînement qui semblent fabriqués. Sur r/ClaudeAI, u/HearMeOut-13 affirme à 16 h 47 que Claude a jugé faux quelques fichiers téléchargés, une méthode aussitôt contestée puisque le modèle d’Anthropic y juge une prétendue copie de lui-même.
trust_remote_code, une vieille porte d’entrée
Pour charger le modèle, la page du dépôt prescrit la bibliothèque Transformers avec l’option trust_remote_code=True. Cette option fait exécuter sur la machine de l’utilisateur deux fichiers Python fournis par le dépôt, modeling_numbat.py et configuration_numbat.py. La documentation de Hugging Face prévient qu’elle ne doit être activée « que pour des dépôts de confiance dont vous avez lu le code » (notre traduction).
C’est le premier argument avancé sur r/accelerate, à 16 h 05 puis à 16 h 06 : demander à des inconnus d’exécuter son code Python est la méthode classique pour leur faire lancer un programme malveillant. Sur Hugging Face, un utilisateur a répondu à 16 h 55 que le fichier de modélisation est « très simple », sans rien de malveillant, et que le format safetensors empêche de glisser directement un tel programme dans les poids. Notre lecture du fichier dans sa version de 17 h, sans l’exécuter, va dans ce sens : ces 22 Ko de code n’importent, outre deux modules standard de Python, que PyTorch et Transformers, sans appel réseau ni commande système visibles.
Le code exécuté est celui que contient le dépôt au moment du chargement, et son auteur peut le modifier quand il veut. Hugging Face passe dans un antivirus les fichiers de moins de 2 Go à chaque modification, mais un antivirus cherche des signatures connues, sans comprendre la logique d’un script. Fin octobre, une version piégée de l’extension Claude Code a touché jusqu’à 5 000 utilisateurs de Cursor en passant par un canal que les développeurs jugeaient sûr.
Notre analyse
À l’heure de publication, nous jugeons très improbable que ces fichiers soient des poids d’Anthropic : la lecture la plus probable est celle d’un faux soigné, que seul un nom de code public depuis mars relie à Anthropic. Le compte est anonyme, les pièces justificatives de simples fichiers texte. Les signaux les plus forts sont les deux analyses publiées dimanche après-midi, dont la seconde permet à n’importe qui de régénérer une partie des poids à partir de leur nom. Personne ne les avait contestées à 17 h 40.
Quelques signaux vont dans l’autre sens : des fichiers cohérents entre eux, un écart de paramètres qui s’explique par le format, et un réglage de compilateur qui vise précisément le problème du format sur Trainium2, signe d’un « effort substantiel » selon un participant. Ils témoignent d’un travail appliqué. Ils ne disent rien de l’origine des fichiers.
Le mobile reste inconnu. Les hypothèses avancées sur Reddit et Hugging Face vont du piège pour développeurs à une tentative de nuire à l’introduction en Bourse d’Anthropic, dont le dossier a été rendu public le 26 octobre, deux jours après la fin de la mise en ligne des fichiers. Un retrait par Hugging Face ne trancherait pas la question : sa politique de contenu vise aussi bien les contenus « intentionnellement trompeurs » que ceux qui enfreignent la propriété intellectuelle d’un tiers.
Trois événements pourraient achever de trancher dans les prochains jours : une explication de l’auteur sur ces valeurs reproductibles, quelqu’un qui charge une partie du modèle et montre du texte cohérent ou du bruit, ou une déclaration d’Anthropic. Jusqu’ici, personne n’a montré une seule ligne de texte produite par ces 7,72 téraoctets.
Sources
- burner22/numbat (page du modèle), Hugging Face, 1er novembre 2026
- some question and concerns (discussion n° 8), Hugging Face, 1er novembre 2026
- 43 complete tensors exactly match name-seeded NumPy RNG output (discussion n° 13), Hugging Face, 1er novembre 2026
- Beware of this model (discussion n° 6), Hugging Face, 1er novembre 2026
- Auto Classes, paramètre trust_remote_code, documentation Hugging Face Transformers, 1er novembre 2026
- Claude Code’s source code appears to have leaked: here’s what we know, VentureBeat (Carl Franzen), 31 mars 2026
- Anthropic mistakenly leaks its own AI coding tool’s source code, Fortune (Beatrice Nolan), 31 mars 2026
- Supposed Anthropic Mythos-class model leaked on HuggingFace, fil r/accelerate, 1er novembre 2026
Image d’en-tête : capture de la page du dépôt burner22/numbat, Hugging Face, 1er novembre 2026.