
Chez Revolut, environ 2 000 ingénieurs codent désormais par défaut avec GLM, un modèle ouvert du laboratoire chinois Z.ai que la néobanque héberge elle-même. Claude Code, d’Anthropic, et Codex, d’OpenAI, restent disponibles à titre d’exception. David Abitbol, qui dirige les opérations d’IA de Revolut, a présenté ce choix le 13 octobre 2026 à la conférence AI Engineer de New York. Selon lui, la facture est tombée à un dixième de ce que l’entreprise dépensait chez Anthropic et OpenAI.
L’intervention et sa transcription complète sont en ligne sur le site des organisateurs. Le site européen Trending Topics et la base de données Dealroom en ont rendu compte le 3 novembre au matin, The Register le soir même, en titrant sur des coûts d’IA pour le code divisés par dix.
Des budgets plafonnés aux tokens sans compter
David Abitbol a décrit trois étapes, mesurées sur un échantillon d’environ 2 000 ingénieurs. Revolut suit deux indicateurs : le temps de codage, en heures, et le délai de livraison, en jours, de la prise en charge d’une fonctionnalité à sa fusion, prête à être déployée.
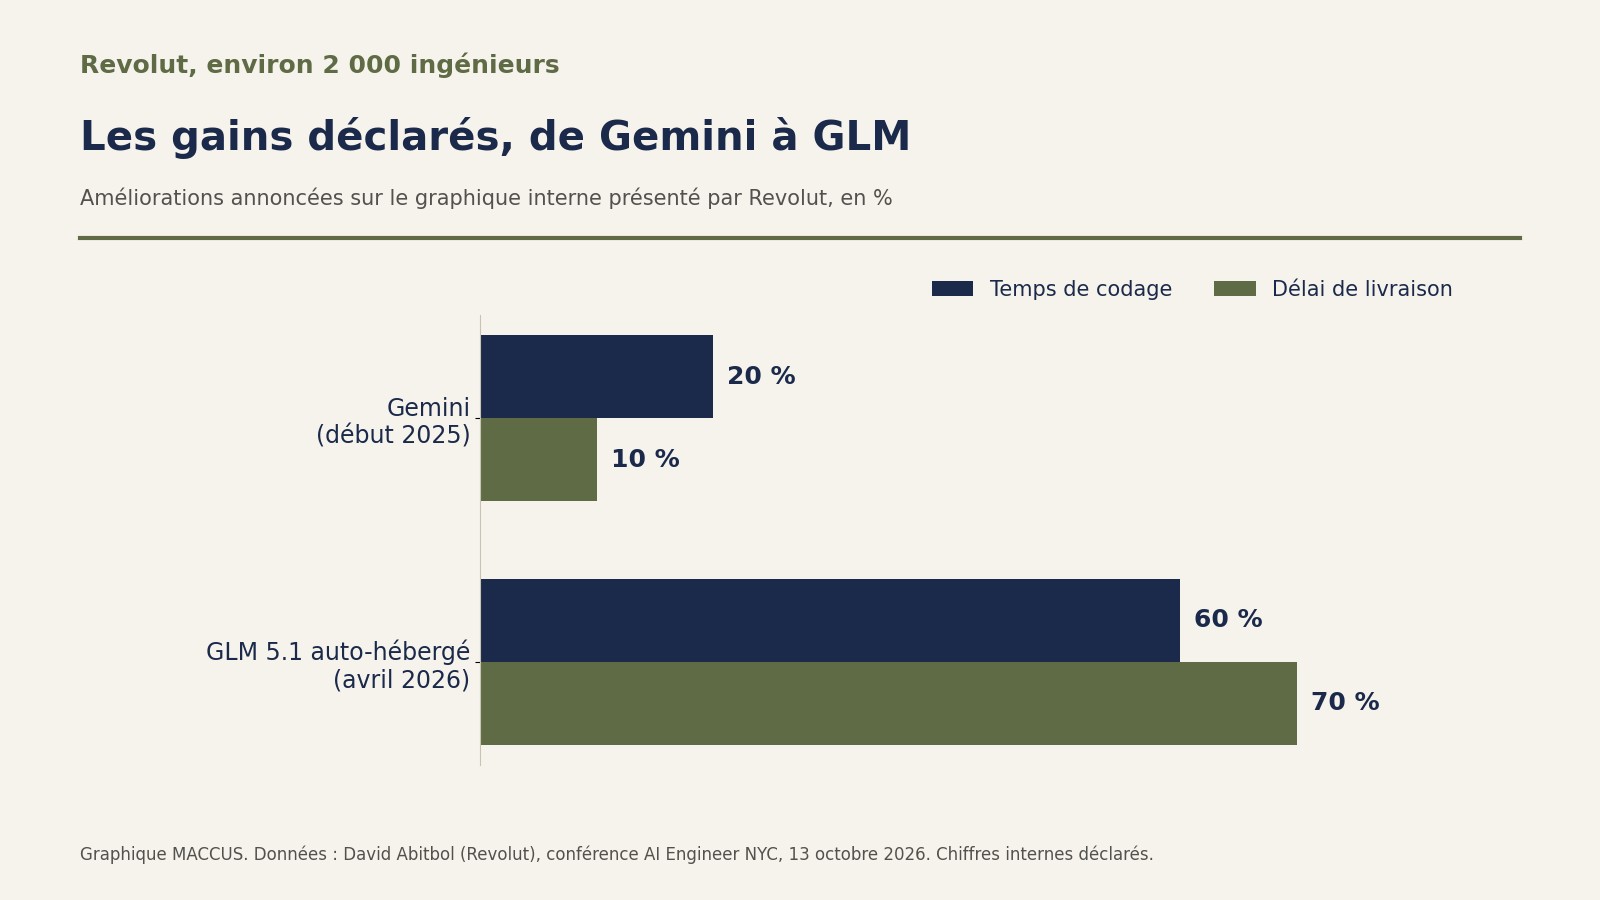
Début 2025, l’entreprise déploie Gemini. Le temps de codage baisse de 20 % et le délai de livraison de 10 %, d’après le graphique présenté. Vient ensuite Claude Code, lancé à grande échelle début 2026 avec des budgets strictement plafonnés. Son effet reste alors faible.
« Nous étions très sceptiques sur le coût de l’IA », a expliqué David Abitbol. « Nous voyions des ingénieurs dépenser 1 000 dollars par mois, 10 000 dollars par mois, sans grand retour sur investissement » (environ 895 et 8 950 euros au cours de la BCE du 3 novembre 2026).
En avril 2026, Revolut commence à héberger elle-même GLM 5.1. Le graphique montre alors une amélioration de 60 % du temps de codage et de 70 % du délai de livraison.
David Abitbol en tire une conclusion : en ingénierie, le goulet d’étranglement n’est pas forcément le code. Les ingénieurs gagnent beaucoup de temps quand ils n’ont plus à fouiller leur boîte mail ou à se débattre avec Jira et Confluence. Avec des tokens illimités, ils cessent de les « garder pour la fin du trimestre ou pour la tâche la plus difficile ».
56 GPU pour 2 000 ingénieurs
Revolut fait tourner GLM 5.3, la version actuelle, sur 56 puces Nvidia B200 pour environ 2 000 ingénieurs. En nombre de GPU, cela équivaut à sept serveurs DGX B200 de huit puces, note The Register. Le coût moyen ressort à 30 cents de dollar par million de tokens, soit environ 0,27 euro. « La facturation est fixe, nous n’avons plus de mauvaise surprise en fin de mois, et les modèles de pointe sont l’exception », a résumé David Abitbol.
Il fixe deux repères. Le premier token doit arriver en moins de trois secondes : au-delà de cinq, sa messagerie Slack « commence à exploser ». La vitesse de génération compte moins : selon lui, 200 tokens par seconde suffisent, parce que les ingénieurs lancent des tâches en parallèle et reviennent quand elles sont finies, sans suivre le raisonnement du modèle en direct.
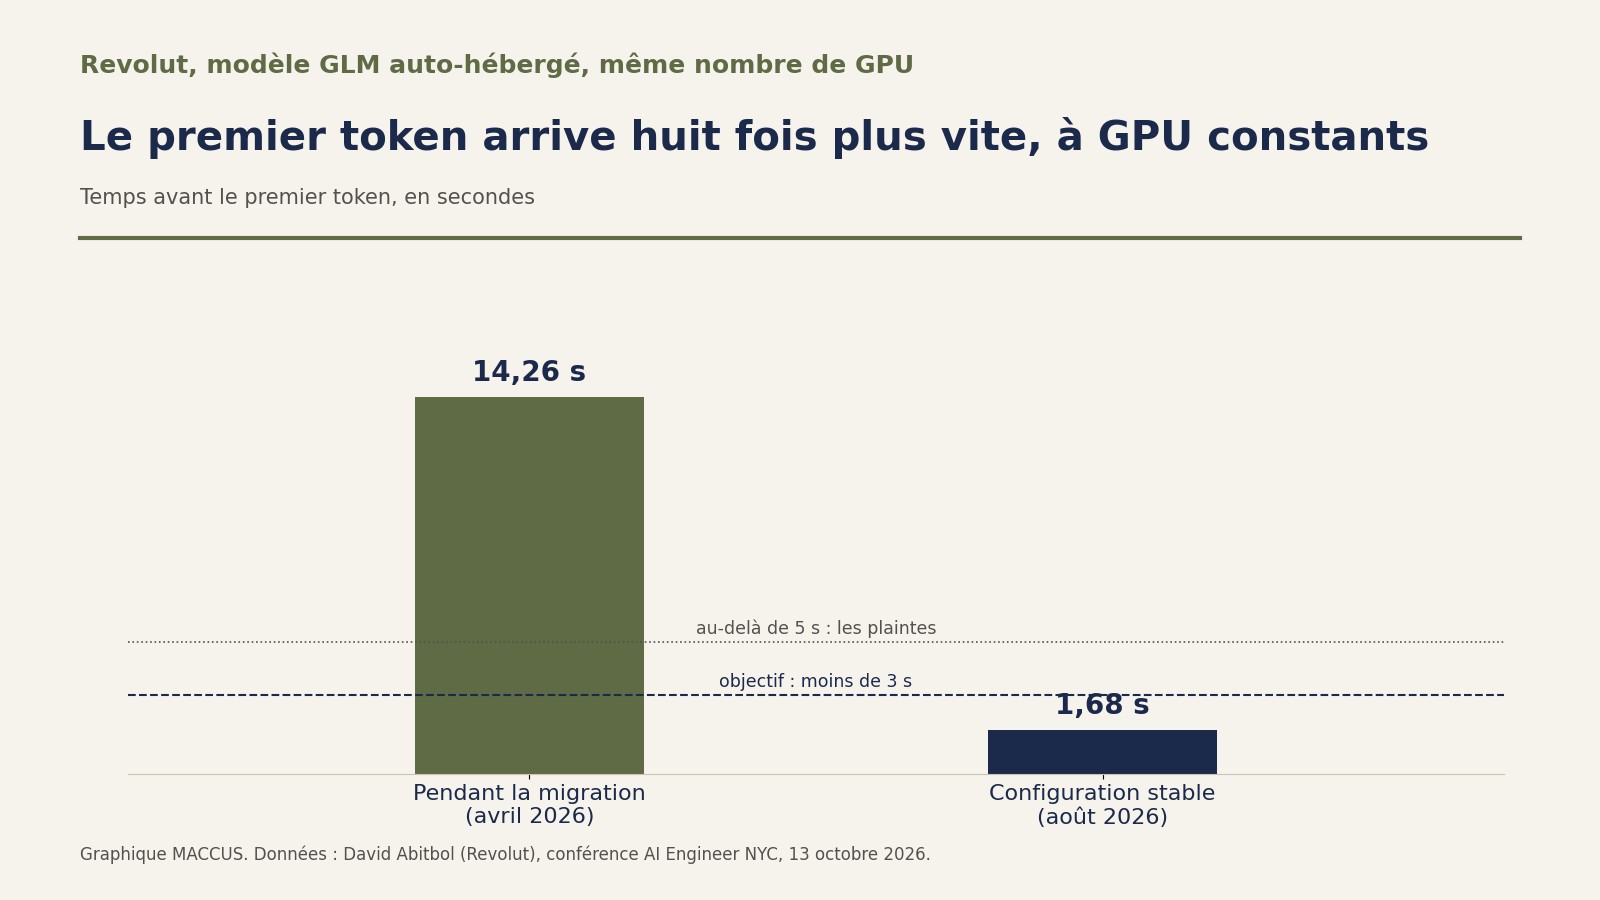
Il a fallu des réglages pour tenir ce délai. Selon la diapositive reprise par les organisateurs, le temps avant le premier token est passé de 14,26 secondes pendant la migration à 1,68 seconde dans la configuration stable, avec le même nombre de GPU et 76 % de requêtes par seconde en plus. David Abitbol cite la quantification en FP4 sur les puces Blackwell et la répartition du modèle sur huit GPU plutôt que quatre, pour laisser assez de mémoire au cache KV. Il conseille aussi de surveiller le taux de succès du cache, qui compte beaucoup pour le code : les mêmes contextes y reviennent souvent.
Le contexte long, lui, est une « arnaque » à ses yeux : même si l’on peut monter à un million de tokens, 256 000 suffisent pour ce travail. Un guide sur l’IA locale en entreprise détaille ce qui détermine le temps avant le premier token et la mémoire nécessaire à un modèle ouvert.
GLM ne lit que du texte. Un routeur envoie donc les requêtes avec images vers d’autres modèles, comme Gemini ou GPT Luna. L’API interne suit le format d’OpenAI : les ingénieurs gardent ainsi les outils de code de leur choix, dont OpenCode et Codex.
Un modèle chinois dans une banque régulée
David Abitbol a reconnu une « stigmatisation » autour des modèles chinois. Son argument porte sur le trajet des données : Revolut télécharge les poids publiés et les fait tourner sur l’infrastructure de son choix, sans passer par un service d’inférence situé en Chine. Selon lui, les GPU peuvent se trouver aux États-Unis, dans l’Union européenne, au Royaume-Uni ou en Israël, chez des fournisseurs qui, par défaut, ne conservent aucune donnée.
Soumise à la régulation bancaire européenne, Revolut garde un humain dans la boucle sur toutes les tâches de code. Elle n’a donc pas à les présenter au régulateur comme des agents autonomes.
Chaque agent tourne dans un bac à sable dont les règles fixent ce qu’il peut exécuter sans validation : « autoriser grep mais pas Gradle » (grep cherche du texte dans les fichiers, Gradle est un outil de compilation). Le même dispositif doit protéger contre les abus internes et l’injection de prompt. Des journaux détaillés permettent de reconstituer un incident.
GLM 5.1 est publié sous licence MIT ; GLM 5.3, sorti fin août, sous une licence propre à Z.ai. L’usage commercial reste libre, mais une entreprise qui vend l’accès à des modèles par API et dépasse 10 milliards de dollars de chiffre d’affaires sur douze mois (environ 8,9 milliards d’euros) doit d’abord passer un examen de sécurité de Z.ai. Le 29 octobre, Mistral a de son côté resserré la licence de Large 4 pour les revendeurs d’API.
GLM 5.3 compte environ 753 milliards de paramètres, dont environ 40 milliards actifs par token, selon la fiche d’Amazon Bedrock, qui le propose depuis le 5 octobre aux clients éligibles. Dans les régions européennes, le service ne l’offre qu’en inférence mondiale, sans garantie que les requêtes restent en Europe.
Des chiffres maison et un coût incomplet
Les gains de productivité reposent sur une comparaison interne de Revolut. Les organisateurs notent sur la page de l’intervention qu’elle n’isole pas le changement de modèle des autres causes possibles. Dealroom en cite une, arrivée en même temps : la fin des plafonds de tokens.
Les organisateurs précisent aussi que le coût de 30 cents par million de tokens vaut pour le déploiement de Revolut et son taux d’utilisation, et ne se transpose pas tel quel à un autre modèle auto-hébergé. La présentation ne dit pas si les 56 GPU sont achetés ou loués, ni ce que coûtent l’équipe chargée des réglages et la supervision. Dealroom estime que des entreprises plus petites, sans l’échelle ni l’équipe d’infrastructure de Revolut, risquent de ne pas obtenir le même résultat.
La présentation ne compare pas non plus la qualité du code produit par GLM et par Claude ou GPT sur les mêmes tâches. Z.ai présente GLM 5.3 comme le modèle ouvert le plus performant pour le code. Son propre tableau le place pourtant derrière Fable 5, d’Anthropic, ou GPT-5.6 Sol, d’OpenAI, sur la plupart des tests de code qu’il publie, dont Terminal Bench 3.0, DeepSWE et FrontierSWE. David Abitbol lui-même juge les derniers modèles d’Anthropic et d’OpenAI « fantastiques », tout en les réservant aux exceptions.
Notre analyse
Une grande banque en ligne européenne dit publiquement que les outils de code d’Anthropic et d’OpenAI ne lui servent plus qu’à titre d’exception, et chiffre son coût par million de tokens. Ce témoignage arrive au moment où ces deux fournisseurs revoient leurs formules. Chez OpenAI, les abonnements Plus, Pro et Business partageront dès décembre une limite d’usage comptée en tokens entre ChatGPT et Codex. Chez Anthropic, l’ancienne formule Max 20x est devenue Ultra le 30 octobre et perd sa limite de cinq heures pour les comptes vérifiés.
Le cas de Revolut décrit surtout un effet de prix. Tant que chaque token se paie, les ingénieurs réservent l’IA aux tâches difficiles ; quand le coût devient fixe, ils lui confient aussi les tickets, la documentation et le débogage. D’après l’entreprise, ces tâches pèsent le plus dans la baisse du délai de livraison. Le modèle ouvert est un moyen d’y arriver, mais un moyen coûteux : il suppose des dizaines de GPU de dernière génération et une équipe capable de les régler pendant des mois.
La pression sur les prix se lit déjà dans les comptes d’Anthropic. Le 2 novembre, l’AFP relevait, à propos de son prospectus d’introduction en Bourse, que la croissance de l’entreprise ralentissait face à OpenAI et à des modèles moins chers, souvent chinois.
Plusieurs points restent ouverts : le coût complet de l’infrastructure de Revolut, la part des tâches renvoyées vers Claude Code et Codex, la qualité comparée du code. Reste à voir si d’autres grandes entreprises publieront des chiffres comparables. Côté fournisseurs, la limite commune de ChatGPT et Codex, attendue en décembre, et les prochains documents financiers d’Anthropic donneront des indices sur leur réponse.
Sources
- Shipping like a startup, regulated like a bank (David Abitbol, Revolut), page de l’intervention et transcription, AI Engineer, 13 octobre 2026
- British fintech Revolut slashes AI coding costs 10x by cutting out Claude and going self-hosted, The Register, 3 novembre 2026
- Revolut Cuts A.I. Coding Costs 90% With a Chinese Open-Weight Model, Trending Topics, 3 novembre 2026
- Revolut swaps Claude Code for a Chinese open-weight model, cutting its AI coding bill by 90%, Dealroom, 3 novembre 2026
- GLM-5.3, fiche du modèle et licence, Z.ai sur Hugging Face, consultée le 4 novembre 2026
- GLM 5.3, fiche du modèle, Amazon Bedrock, consultée le 4 novembre 2026
- Anthropic says revenue surged 1,100 percent ahead of IPO, AFP (sur Yahoo Finance), 2 novembre 2026
- Taux de change de référence de l’euro, dollar américain, Banque centrale européenne, 3 novembre 2026
Image d’en-tête : graphique MACCUS, données David Abitbol (Revolut), conférence AI Engineer NYC, 13 octobre 2026.