La société française Mistral AI a publié le 29 octobre 2026 les poids de Mistral Large 4, son plus grand modèle, surnommé « Le Chonk ». Il compte environ 1 000 milliards de paramètres, dont 49 milliards actifs par token. Les fichiers sont téléchargeables sur Hugging Face, et l’API de Mistral facture le modèle 0,70 dollar le million de tokens en entrée et 2,10 dollars en sortie, soit environ 0,63 € et 1,89 €.
La nouvelle licence du modèle, la Mistral Ecosystem Open-Weight License, autorise l’usage commercial, la modification et le réentraînement, avec une exception : une entreprise qui vend l’accès au modèle sous forme de service doit d’abord signer une licence commerciale avec Mistral. Le modèle précédent, Mistral Large 3, est publié sous licence Apache 2.0, sans clause de ce type.
Trois semaines d’entraînement après la préversion
Mistral avait ouvert le 6 octobre une préversion de Large 4 par API, en promettant les poids pour la fin du mois. Entre les deux dates, l’entreprise dit avoir ajouté trois semaines d’apprentissage par renforcement. Sur Terminal-Bench 4.0, un test de tâches en ligne de commande, le score du modèle passerait de 28 % à 41 %, avec 30 % de tokens de sortie en moins, selon Mistral.
Mistral annonce aussi 19,7 % sur FrontierCode 2.0, un test privé de la société Cognition, devant les modèles ouverts comparés. Sur l’indice des agents de programmation d’Artificial Analysis, Large 4 obtient 48 %, pratiquement à égalité avec le modèle chinois GLM-5.3 (49 %), en consommant en moyenne 47 % de tokens en moins par tâche. Dans une évaluation à l’aveugle de Surge AI sur la qualité du code, seul Claude Opus 5.5 d’Anthropic lui est préféré, dans 78 % des duels qui les opposent.
Mistral dit avoir entraîné le modèle à partir de zéro sur 3 800 GPU NVIDIA, dans ses propres centres de données en Europe.
Une licence qui vise les fournisseurs d’API
La licence de Large 4 reprend la licence MIT et y ajoute une clause. Si le licencié ou l’une de ses sociétés liées exploite une activité de « Model as a Service », il doit conclure une licence commerciale avec Mistral avant tout usage commercial du modèle ou de ses dérivés. Ce service consiste à donner à un tiers l’accès au modèle ou à ses dérivés, pour l’inférence ou le post-entraînement, par tout moyen (API, point d’accès hébergé), avec un contrôle réel de ce tiers sur les entrées, les paramètres ou les données d’entraînement.
Deux cas sortent de cette définition : un produit pour utilisateurs finaux qui n’intègre le modèle que dans des fonctions précises, et le simple relais de requêtes vers un modèle hébergé par d’autres. L’usage interne et l’usage via les produits officiels de Mistral échappent aussi à la clause.
Le prix face à OpenAI et Anthropic
Le tableau compare le prix de Mistral, en vigueur depuis le 29 octobre, aux grilles publiques d’OpenAI et d’Anthropic : tarif standard hors taxes, converti au taux de la BCE du 29 octobre (1 € = 1,1130 $).
| Prix par million de tokens | Entrée | Sortie |
|---|---|---|
| Mistral Large 4 | 0,70 $ (0,63 €) | 2,10 $ (1,89 €) |
| GPT-6.1 Terra (OpenAI) | 1 $ (0,90 €) | 5 $ (4,49 €) |
| Claude Sonnet 5.5 (Anthropic) | 2 $ (1,80 €) | 10 $ (8,98 €) |
| Claude Opus 5.5 (Anthropic) | 4 $ (3,59 €) | 20 $ (17,97 €) |
Le prix au token ne donne pas le coût d’une tâche, qui dépend du nombre de tokens consommés. OpenAI avait présenté GPT-6.1 Terra le 26 octobre en mettant en avant son coût par tâche face à Claude Opus 5.5.
Le modèle est aussi proposé sur OpenRouter, chez NVIDIA et sur Microsoft Foundry.
Le matériel nécessaire pour l’héberger soi-même
Faire tourner les versions complètes sur ses propres machines, ce qu’on appelle l’IA locale en entreprise, demande ici un matériel de centre de données. Selon la recette de déploiement du projet vLLM, la version FP8 de Large 4 pèse environ 1,06 To et la version compressée NVFP4 environ 610 Go. vLLM a validé la version NVFP4 sur des serveurs de huit GPU B200 ou B300 et sur quatre GPU GB300. La version FP8 a aussi été validée sur deux serveurs de huit GPU H200.
Hugging Face indique dans son billet de présentation que les versions quantifiées à 2 bits tiennent sur un seul ordinateur Apple à puce Ultra doté de 512 Go de mémoire unifiée, à environ 15 tokens par seconde sur un M3 Ultra. La fiche du modèle recommande l’API de Mistral lorsque le modèle installé en local donne de moins bons résultats.
Des banques et des acteurs de la cyberdéfense parmi les partenaires
Large 4 obtient 51 % au Cyber Index d’Artificial Analysis, qui mesure la capacité d’un modèle à trouver, reproduire et corriger des failles dans du code. Sur le graphique publié par Mistral, deux modèles ouverts chinois font mieux : DeepSeek V4.1 Flash 1017 (57 %) et MiMo-V2.6-Pro de Xiaomi (56 %). Selon Mistral, Large 4 refuse en moyenne 96,6 % des requêtes cyber malveillantes de trois jeux de test publics.
Une variante spécialisée, conçue pour les tests d’intrusion et le « red teaming », est réservée à des partenaires comme Orange Cyberdefense, après vérification et sous contrat. Les tests se limitent aux systèmes que ces partenaires possèdent ou qu’ils sont explicitement autorisés à tester. Google a fait un choix proche le 28 octobre en réservant d’abord Gemini 4 Carbon à une partie des spécialistes de la cyberdéfense, sans publier ses poids.
Une vingtaine d’organisations s’expriment dans l’annonce. La banque belge Belfius dit pouvoir adapter le modèle, l’héberger sur sa propre infrastructure et l’intégrer à ses canaux numériques. La Banque Postale écrit que, pour une banque publique, la souveraineté technologique est une condition préalable. L’agence européenne de cybersécurité ENISA teste Large 4 pour repérer des failles, auditer du code et analyser des journaux de sécurité.
À TechCrunch, Pierre Stock, vice-président chargé de la science chez Mistral, résume l’argument : les entreprises et les États accèdent à une IA de pointe pour se défendre, un accès « qui ne peut pas être coupé, par définition, puisque le modèle est à poids ouverts » (propos traduits). Chez Next, Vincent Hermann estime que le modèle doit remettre l’entreprise dans la course, « après de longs mois de quasi-silence sur les grands modèles ».
Les limites des chiffres publiés
Mistral a choisi les tests mis en avant. Le score de la préversion et le taux de refus sont ses propres mesures. Les 48 % et les 41 % viennent de l’indice des agents de programmation d’Artificial Analysis, qui a fait tourner Large 4 dans Mistral Vibe, l’agent de programmation de Mistral. Le rapport technique complet est annoncé sans date.
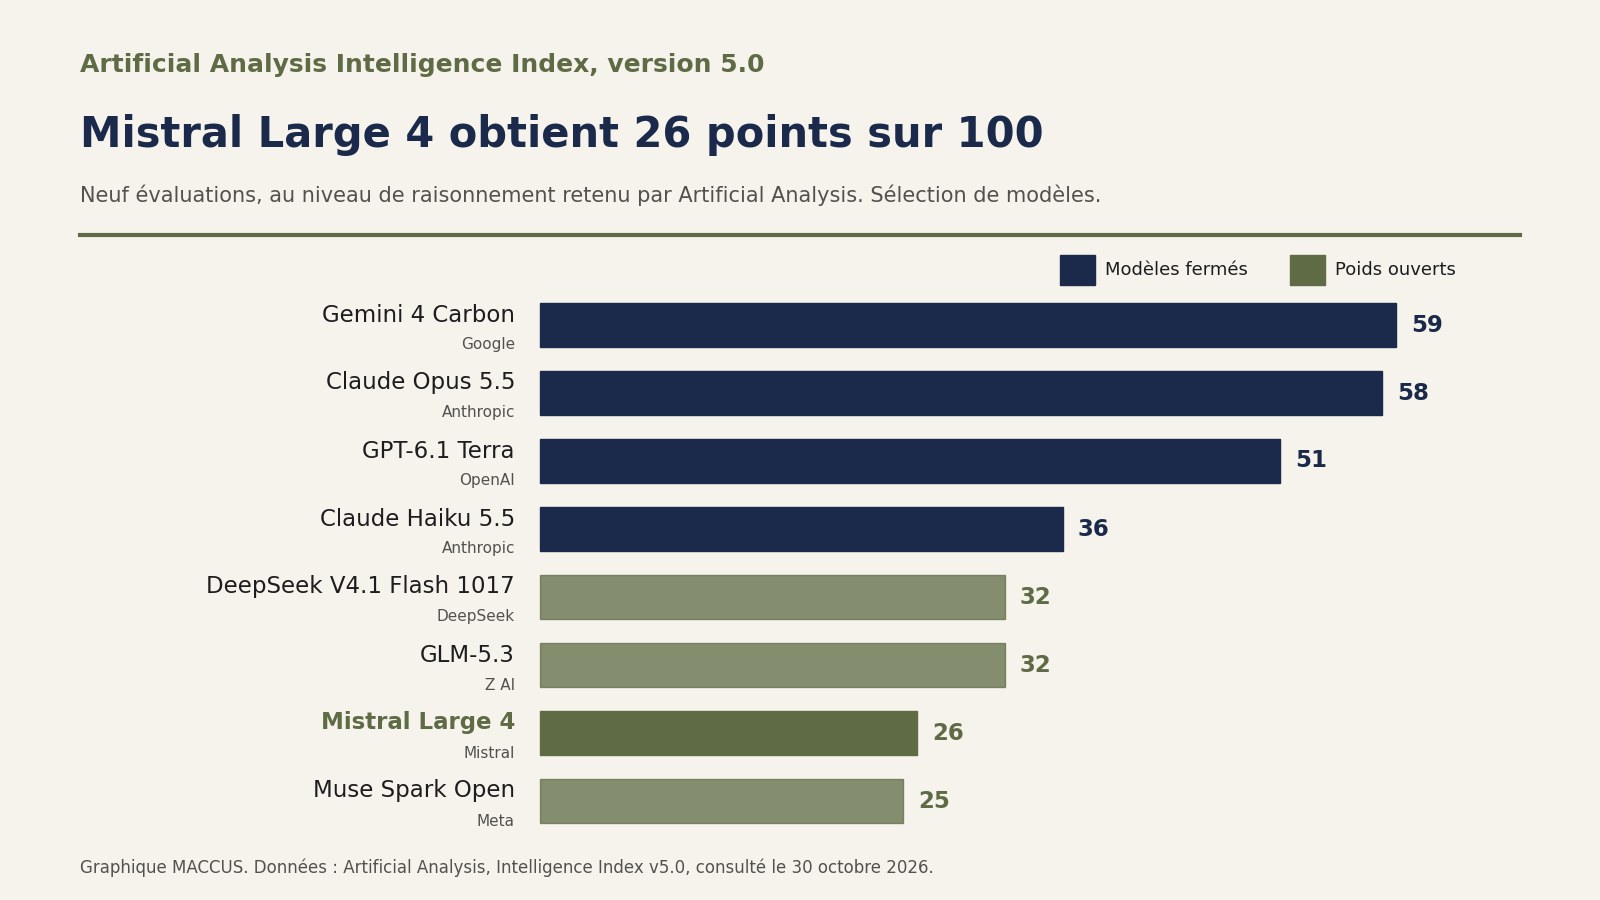
L’indice d’intelligence d’Artificial Analysis (version 5.0, neuf évaluations), consulté le 30 octobre, est moins flatteur. Large 4 y obtient 26 points, contre 32 pour DeepSeek V4.1 Flash 1017 et GLM-5.3, 36 pour Claude Haiku 5.5, 51 pour GPT-6.1 Terra et 58 pour Claude Opus 5.5. L’indice inclut Terminal-Bench 4.0 et FrontierCode 2.0, deux tests où Mistral se dit en tête des modèles ouverts. Ses scores y sont de 24,7 % et 15 %, derrière GLM-5.3 (41,9 % et 21,6 %) et DeepSeek V4.1 Flash 1017 (33,8 % et 28,5 %).
La fiche du modèle reconnaît que les meilleurs modèles ouverts chinois font mieux sur cet indice, et présente Large 4 comme le mieux classé des modèles ouverts occidentaux. Le tableau d’Artificial Analysis le confirme : six modèles ouverts chinois le devancent, tandis que Muse Spark Open, de Meta, obtient 25 points et Nemotron 3.5 Super VL de NVIDIA, sorti le 15 octobre, 14 points.
Mistral signale enfin un risque. En surveillant les usages liés à la cybersécurité depuis la préversion, l’entreprise a vu le modèle refuser des attaques en boîte noire contre des cibles réelles, mais estime qu’il pourrait aider à mener de vraies attaques. Elle dit modifier ses garde-fous et prévoit de les mettre à jour dans les mois à venir.
Notre analyse
Large 4 est le modèle à poids ouverts conçu hors de Chine le mieux classé par Artificial Analysis, et il a été entraîné en Europe. Les premiers concernés sont les banques, les administrations et les équipes de cybersécurité qui doivent garder données et modèle sous leur contrôle, et qui disposent de serveurs à plusieurs GPU. Pour les autres, l’accès le plus simple reste l’API de Mistral ou un cloud comme Microsoft Foundry, à un prix au token inférieur à ceux de GPT-6.1 Terra et de Claude Sonnet 5.5.
Les gains annoncés en programmation tiennent à des tests choisis par Mistral et, pour les 41 % sur Terminal-Bench, à son propre agent. L’indice d’intelligence d’Artificial Analysis le laisse loin des meilleurs modèles fermés et derrière six modèles ouverts chinois. Sur la licence, une question reste ouverte : la manière dont Mistral appliquera la notion de contrôle réel (« meaningful control »), qui sépare l’usage libre de la revente soumise à contrat.
Trois points restent à suivre : le rapport technique annoncé, des résultats de Large 4 avec d’autres agents de programmation que Mistral Vibe, et la portée des modifications de garde-fous, que Mistral ne précise pas pour les copies déjà téléchargées. L’entreprise annonce aussi une série de modèles spécialisés dérivés de Large 4, sans calendrier.
Sources
- Mistral Large 4 (Le Chonk) is now open weight, Mistral AI, 29 octobre 2026
- Présentation de Mistral Large 4, Mistral AI, 6 octobre 2026
- Mistral Large 4 – Le Chonk (fiche du modèle), Mistral AI sur Hugging Face, consulté le 30 octobre 2026
- Mistral Ecosystem Open-Weight License, Mistral AI sur Hugging Face, consulté le 30 octobre 2026
- Artificial Analysis Intelligence Index v5.0, Artificial Analysis, consulté le 30 octobre 2026
- Mistral Large 4 recipe, vLLM, consulté le 30 octobre 2026
- Mistral releases weights for its trillion-parameter AI model, targeting cybersecurity, TechCrunch, 29 octobre 2026
- Mistral lance la version finale de Large 4 et publie ses poids ouverts, Next, 29 octobre 2026
Image d’en-tête : graphique MACCUS, données Artificial Analysis (Intelligence Index v5.0, consulté le 30 octobre 2026).