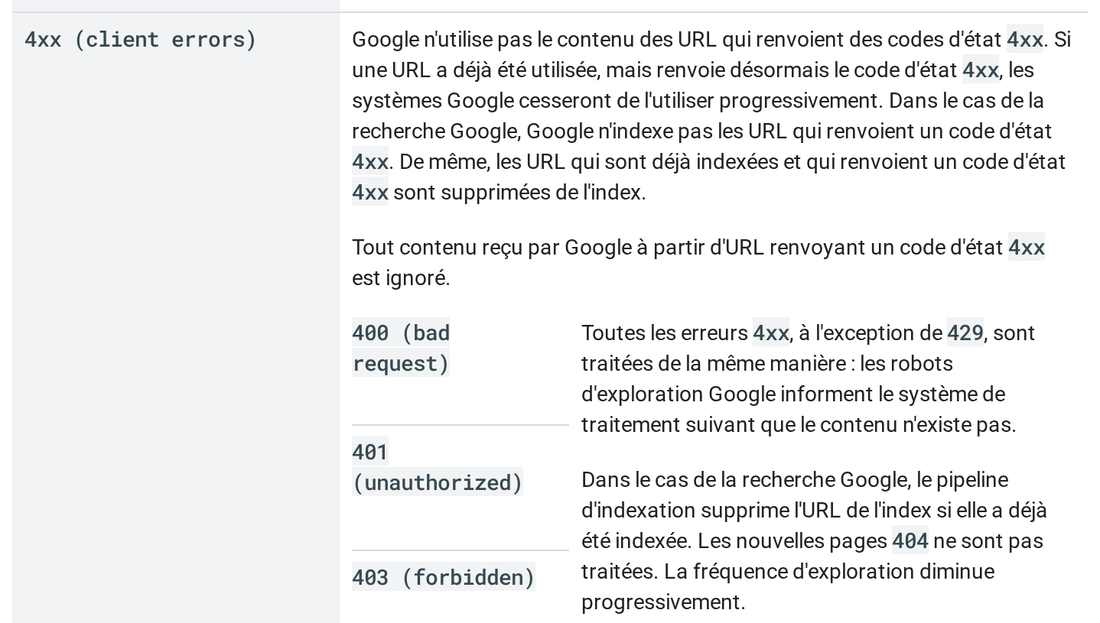
Google a gardé dans son index la page d’accueil de VLC, le lecteur multimédia libre, alors que le site lui renvoyait une erreur. L’index est la base de pages dans laquelle le moteur puise ses résultats. Selon sa documentation, une page déjà indexée qui renvoie ce type d’erreur sort pourtant de l’index, sans exception pour les pages importantes.
Gary Illyes, analyste chez Google, a expliqué cette exception dans un commentaire publié sur LinkedIn le 5 novembre 2026. Selon lui, le moteur a « temporairement protégé » l’adresse parce que VLC est « sans doute l’une des pages les plus importantes d’internet » (traduit de l’anglais). Search Engine Roundtable, un site d’information spécialisé dans les moteurs de recherche, a relayé ce commentaire le jour même.
Le serveur de videolan.org, le site de VLC, renvoyait le code HTTP 418, « I’m a teapot » (« je suis une théière »). Un code HTTP, ou code d’état, est le nombre à trois chiffres qu’un serveur web renvoie avec chaque page. Le code 200 signifie que tout va bien, le 404 que la page est introuvable. Le 418 fait partie des erreurs 4xx, les codes qui commencent par 4, et Google le traite comme une page introuvable.
Un appel à l’aide de VideoLAN sur LinkedIn
L’affaire part d’un message de VideoLAN, l’association qui porte le projet VLC. Cette association à but non lucratif est basée en France. Selon l’historique publié sur son site, le projet VideoLAN est né en 1996 comme travail d’étudiants de l’École centrale Paris.
Le 3 novembre 2026 au soir, VideoLAN a demandé de l’aide sur LinkedIn pour son référencement et pour la Search Console. Cet outil gratuit de Google montre aux éditeurs de sites comment le moteur traite leurs pages. L’association constatait depuis un moment « quelque chose de bizarre » dans sa présence sur Google. Ses utilisateurs s’y perdaient, écrivait-elle, alors qu’elle n’avait rien changé.
Dans les résultats de Google, le favicon de VLC, la petite icône affichée à côté du nom d’un site, avait disparu. Une capture d’écran publiée par Search Engine Roundtable montre à sa place une icône générique en forme de globe. La page d’accueil y apparaît en deuxième position sur la recherche « vlc », sous la page de téléchargement du lecteur.
Sous le message de VideoLAN, plusieurs commentaires publiés à partir du 3 novembre au soir proposaient une explication : un favicon trop petit, une majuscule dans la balise meta description (la ligne de code qui contient le résumé d’une page), un cache qui mélangerait les versions du site en différentes langues. Le 9 novembre, le message comptait 44 commentaires.
Gary Illyes met en cause le code 418
Gary Illyes a écarté la piste de la majuscule. Le programme de Google qui lit le code des pages ignore les majuscules des balises et de leurs attributs, « comme le prévoit le standard HTML », a-t-il écrit. Selon lui, quelqu’un chez VideoLAN avait décidé que le serveur devait « se déclarer théière », c’est-à-dire renvoyer le code 418.
Google traite ce code « comme la plupart des autres erreurs 4xx : en gros, “introuvable” », a précisé Gary Illyes. Le moteur aurait donc dû retirer la page de son index. Il ne l’a pas fait tout de suite, en raison de l’importance de VLC.
Cette protection a un effet secondaire, que Gary Illyes décrit lui-même. Google ne sait plus ce que contient la page, et il n’a donc « plus rien à montrer : pas d’extrait, pas de favicon, rien ». L’extrait est le court texte affiché sous le titre d’un résultat. Il ne reste dans le résultat que le lien et « le dernier bon titre » connu.
Au moment de son commentaire, le site renvoyait de nouveau une réponse normale, le code 200. Selon lui, la situation devait « se régler d’elle-même bientôt ».
La règle écrite de Google pour les erreurs 4xx
La documentation de Google sur les codes d’état HTTP ne prévoit aucune exception pour les pages importantes. Dans sa version française, mise à jour le 5 mars 2026, elle indique que « les URL qui sont déjà indexées et qui renvoient un code d’état 4xx sont supprimées de l’index ». Elle précise que, quand une adresse déjà utilisée renvoie désormais une erreur 4xx, les systèmes de Google « cesseront de l’utiliser progressivement ». Elle ne donne aucun délai.
Selon la documentation, toutes les erreurs 4xx « sont traitées de la même manière », sauf le code 429, qui suit la règle des erreurs de serveur. Le résultat est donc le même pour une page introuvable (404), une page supprimée (410) ou un accès interdit (403).
La documentation ajoute que la fréquence d’exploration de ces adresses « diminue progressivement ». L’exploration est la visite des pages par les robots de Google, des programmes qui parcourent le web pour les lire. Dans la Search Console, ces pages apparaissent sous des motifs comme « Introuvable (404) », que notre guide des statuts d’indexation de la Search Console détaille un par un.
Les erreurs de serveur, dont les codes commencent par 5 comme le 503, suivent une autre règle. Avec un code 5xx ou un code 429 (« trop de requêtes »), Google ralentit son exploration et conserve un temps les pages déjà indexées. Ces pages « finissent par être supprimées de l’index ».
Cette différence explique pourquoi Google a demandé le 21 octobre aux sites mis hors ligne pour les failles de sécurité PHP2Shell de renvoyer un code 503 plutôt qu’une erreur 404.
La documentation cite bien le code 418, mais pour dire qu’elle ne le traite pas. Elle présente « les 20 codes d’état les plus courants rencontrés par Google », et « les codes d’état plus rares, tels que 418 (I’m a teapot), ne sont pas couverts ».
Un code né d’un poisson d’avril
Le code 418 vient d’une blague. Le 1er avril 1998, l’informaticien Larry Masinter a publié la RFC 2324, un faux protocole de communication pour piloter des cafetières à distance. Les RFC sont les documents qui publient les normes techniques d’internet. Dans la RFC 2324, toute tentative de faire du café avec une théière devait renvoyer l’erreur « 418 I’m a teapot ».
La norme actuelle de HTTP, la RFC 9110 de juin 2022, n’attribue le code 418 à aucun usage. Elle note qu’il a servi de plaisanterie si souvent qu’il est devenu inutilisable pour autre chose. Il reste donc réservé dans le registre officiel des codes HTTP.
Les zones d’ombre de l’explication de Google
Gary Illyes ne dit pas quelles pages bénéficient de cette protection, ni selon quels critères Google juge une page « importante ». Il ne dit pas non plus combien de temps elle dure. Son commentaire parle seulement d’une protection temporaire, qui évite que l’adresse sorte de l’index « tout de suite ».
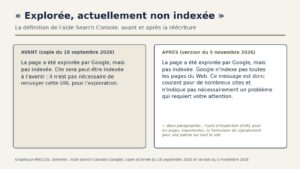
Nous n’avons trouvé aucune page de Google qui décrive ce mécanisme. Le moteur a pourtant réécrit cet automne la définition du statut « Explorée, actuellement non indexée », affiché dans la Search Console.
La capture de Search Engine Roundtable, qui n’est pas datée, nuance aussi la description de Gary Illyes. Le favicon y manque bien, mais la page d’accueil affiche une description sous son titre, alors que l’analyste parlait d’une absence d’extrait.
Le site renvoie le code 418 à certains robots d’IA
La raison du code 418 reste inconnue. Au 9 novembre, nous n’avons trouvé aucune explication publique de VideoLAN sur l’envoi de ce code à Google. Gary Illyes n’en donne pas non plus.
Nos vérifications du 9 novembre 2026 montrent que videolan.org renvoie ce code à certains robots. Une demande envoyée sous le nom d’un robot d’OpenAI, l’éditeur de ChatGPT (nous avons testé GPTBot, OAI-SearchBot et ChatGPT-User), reçoit une erreur 418. Le robot du moteur de recherche Perplexity, PerplexityBot, reçoit la même erreur. Présentée comme Googlebot, Bingbot ou un navigateur web, la même demande reçoit la page normale.
Ce test montre que le site emploie le code 418 pour refuser certains robots d’intelligence artificielle. Sa portée a une limite : il change uniquement le nom que le visiteur déclare au serveur, son « user agent », et l’adresse IP de la machine qui envoie la demande reste la même. Il ne permet donc pas de savoir ce que le vrai Googlebot a reçu pendant l’incident.
Notre analyse
La règle écrite de Google s’applique à toutes les pages, quelle que soit leur importance. Selon Gary Illyes, le moteur peut pourtant garder un temps dans son index une page qu’il juge très importante, même si elle renvoie une erreur 4xx. Sans cette protection, elle en serait sortie « tout de suite ». La documentation dit seulement que Google cesse « progressivement » d’utiliser ces adresses, sans délai chiffré.
L’analyste donne un seul exemple, un site connu dans le monde entier, et aucun critère. Rien n’indique que cette exception concerne la grande majorité des sites. Pour eux, la règle publiée reste la seule référence vérifiable.
Nos vérifications montrent aussi qu’un serveur peut renvoyer une erreur à certains robots tout en affichant la page normale aux internautes. L’éditeur qui visite son site ne voit alors rien d’anormal : VideoLAN a d’abord remarqué le problème dans sa présence sur Google.
Une page retirée de l’index après une erreur peut rester absente plusieurs semaines après sa réparation. Selon des estimations internes présentées par Gary Illyes le 2 octobre 2026, Google revient sur une page déjà connue au bout de 30 jours environ. Selon sa documentation, il explore aussi de moins en moins souvent une adresse en erreur 4xx.
Deux points restent à suivre. Google pourrait décrire cette protection dans sa documentation, ou préciser quelles pages en bénéficient. Le favicon de VLC devrait aussi revenir dans les résultats, comme Gary Illyes l’annonçait le 5 novembre.
Sources
- Help 🙂, VideoLAN (LinkedIn), 3 novembre 2026
- Google Can Temporarily Protect Important URLs From Being Deindexed, Search Engine Roundtable, 5 novembre 2026
- Effet des codes d’état HTTP sur les robots d’exploration Google, Google, 5 mars 2026
- RFC 9110, HTTP Semantics, RFC Editor, juin 2022
- RFC 2324, Hyper Text Coffee Pot Control Protocol (HTCPCP/1.0), RFC Editor, 1er avril 1998
- VideoLAN, a project and a non-profit organization, VideoLAN, consulté le 9 novembre 2026
Image d’en-tête : graphique MACCUS, données de la documentation de Google sur les codes d’état HTTP (5 mars 2026) et du commentaire de Gary Illyes relayé par Search Engine Roundtable (5 novembre 2026)