Meta, la maison mère de Facebook, a ouvert aux moteurs de recherche des millions de pages écrites par son intelligence artificielle (IA). Ces pages attireraient un trafic croissant venu de Google, et elles pourraient enfreindre les règles anti-spam du moteur.
Le répertoire, à l’adresse facebook.com/fb-answers/, est appelé Facebook Answers par les spécialistes du référencement. Chaque page y résume un sujet à partir de publications publiques. Le 5 novembre 2026, le site spécialisé Search Engine Roundtable a fait état de plus de 6 millions de ces pages dans l’index de Google, le catalogue des pages qu’il peut afficher. Elles se classent dans ses résultats.
Ces pages auraient reçu 40,6 millions de visites venues de Google en octobre, contre environ un million en juillet. Ce sont des estimations de Semrush, un outil qui déduit les visites d’un site de ses positions dans Google. Saul Westbrook, spécialiste du référencement et fondateur de Peripheral, un site d’analyses fondées sur des données, les a publiées le 4 novembre.
Pour le consultant Glenn Gabe, cité par Search Engine Roundtable, il s’agit d’un exemple « massif » d’utilisation abusive de contenu à grande échelle. Les règles anti-spam de Google interdisent cette création de pages en masse destinée à manipuler son classement. Ni Meta ni Google n’ont commenté publiquement.
Des résumés signés Meta AI
MACCUS a consulté le 7 novembre la page donnée en exemple par Westbrook, « Using American Express for Travel » (utiliser American Express en voyage). Elle s’affiche sans compte Facebook. Sous le titre figurent la mention « Summarized by Meta AI » (résumé par Meta AI, l’assistant de Meta) et un compteur, « 53 people talking about this » (53 personnes en parlent). Suivent un court résumé sur les cartes American Express en voyage, puis des sections thématiques.
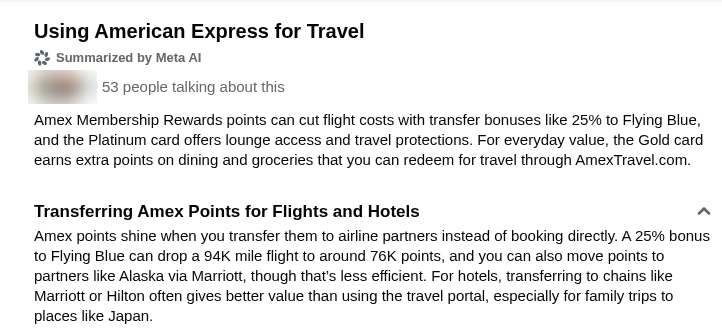
Le résumé s’appuie sur des publications publiques, affichées entre ses paragraphes : messages de particuliers, de pages Facebook et de groupes, avec le nom de leur auteur et le nombre de réactions. Ces sources peuvent être anciennes : Westbrook en a trouvé une datée de 2010, publiée dans un groupe de six membres.
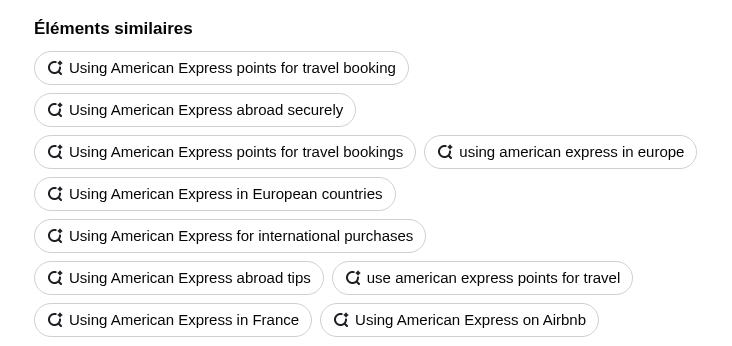
En bas de page, un encadré « Éléments similaires » renvoie vers dix autres pages du répertoire, aux titres proches. Plusieurs ne diffèrent que d’un mot ou d’une tournure : « Using American Express points for travel booking » et « … bookings », ou « using american express in europe » et « Using American Express in European countries ». Westbrook dit avoir compté plus de 180 pages en anglais sur le seul padel.
Selon Westbrook, le répertoire a suivi le lancement du « mode IA » de Facebook, annoncé par Meta le 15 juin 2026. C’est un onglet de recherche où Meta AI répond à partir de « ce que les gens disent publiquement dans nos applications, par exemple dans les Groupes et les Reels » (traduit de l’anglais). Westbrook pense que les pages fb-answers en sont des versions figées, conçues pour le référencement, ce que Meta n’a pas confirmé.
La date de départ reste floue. Semrush relève de premières visites dès mai, alors que Glenn Gabe situe en juillet le début du remplissage.
De 1 à 40 millions de visites mensuelles, selon Semrush
Selon le tableau de Westbrook, les premières visites apparaissent en mai 2026, environ 130 000 dans le monde. Le répertoire passe à un million de visites en juillet, 12,2 millions en août, 36,4 millions en septembre et 40,6 millions en octobre. L’essentiel de la hausse date d’août et de septembre, et le bond d’août suit une vague d’indexation.
Semrush compte les mots clés, c’est-à-dire les recherches pour lesquelles une page du répertoire apparaît dans Google. Leur nombre est passé de 4 à 53 millions dans le monde entre juillet et août. Aux États-Unis, plus de 39 millions de ses pages apparaîtraient sur au moins une recherche.
Certaines pages arrivent en tête de recherches courantes aux États-Unis. Westbrook relève une deuxième position sur « Amex Travel » (368 000 recherches par mois selon Semrush). Il relève aussi une première position sur « LAS Airport Location », la localisation de l’aéroport de Las Vegas (22 200 recherches par mois).
Selon ces estimations, les visites venues des États-Unis reculent déjà : de 23,1 millions en septembre à 21,1 millions en octobre, soit environ 9 % de moins. Le total mondial progresse encore grâce aux autres pays. Le Royaume-Uni passe de 2,0 à 2,9 millions, et les pays que le tableau ne détaille pas en gagnent environ 5 millions. Le tableau ne donne aucun chiffre pour la France ou un autre pays francophone, et les pages relevées par Westbrook comme par MACCUS sont en anglais.
Pour comparer, Westbrook estime, d’après Semrush, que Reddit reçoit 1,8 milliard de visites par mois venues de Google. En octobre, le répertoire de Facebook en représentait environ 2 %. Reddit a fait état fin octobre d’un net recul de son trafic venu des moteurs de recherche.
Le moteur de Google admis, les robots d’IA refusés
MACCUS a consulté le 7 novembre le fichier robots.txt de Facebook, qui indique aux robots (les programmes qui parcourent le Web) ce qu’ils ont le droit d’explorer. Il interdit tout le site aux robots de plusieurs entreprises d’IA, dont GPTBot (OpenAI), ClaudeBot (Anthropic) et PerplexityBot (Perplexity). Il refuse aussi Google-Extended, qui vise l’IA de Google, et le nom commun __usage_ai-training, issu de la règle partagée contre l’entraînement des modèles annoncée le 30 octobre.
Googlebot, le robot du moteur de recherche de Google, a ses propres règles. Elles lui ferment un dossier nommé /meta-ai-answers/, mais aucune ligne ne vise /fb-answers/. Google peut donc explorer ces pages et les ajouter à son index.
Ce tri suit la documentation de Google. Selon elle, Google-Extended contrôle l’usage des contenus pour entraîner les futurs modèles Gemini, l’IA de Google, et pour appuyer les réponses des applications Gemini sur l’index de recherche. Elle précise aussi que Google-Extended « n’a aucune incidence sur l’inclusion d’un site dans la recherche Google ».
Westbrook a trouvé de nombreuses pages fb-answers citées dans les Aperçus IA, les résumés générés en tête des résultats de Google. Glenn Gabe les a vues aussi dans le Mode IA de Google, une recherche sous forme de conversation. Westbrook n’a en revanche pas réussi à les faire lire par les assistants d’IA concurrents.
La règle anti-spam de Google mise à l’épreuve
Les règles de Google définissent l’utilisation abusive de contenus à grande échelle comme le fait « de générer de nombreuses pages dans le but principal de manipuler le classement dans la recherche Google et non d’aider les utilisateurs ». Le premier exemple cité est l’« utilisation d’outils d’IA générative ou d’autres outils similaires pour générer de nombreuses pages sans ajouter de valeur pour les utilisateurs ».
Dans ses conseils de février 2023 sur le contenu généré par IA, Google écrit que « l’utilisation appropriée de l’IA ou de l’automatisation n’est pas contraire à nos consignes ». Depuis l’automne, des consultants rapportent pourtant une hausse des actions manuelles pour contenu à grande échelle, y compris contre des sites d’entreprises établies. Une action manuelle est une sanction décidée par un employé de Google.
Pour Glenn Gabe, le répertoire de Facebook relève « à coup sûr » de cette pratique. Barry Schwartz, fondateur de Search Engine Roundtable, s’attend à ce que ces pages ne restent « plus très longtemps » indexées, maintenant que l’affaire est publique.
Westbrook est plus prudent. Selon lui, les pages pourraient échapper à une sanction, car elles reposent sur des données propres à Facebook, que Google pourrait juger utiles. Il relève qu’elles ont survécu à la mise à jour anti-spam de septembre 2026, la dernière annoncée par Google sur son tableau de bord.
Westbrook note aussi que beaucoup de pages se ressemblent. Il évoque une autre règle de Google, celle des pages satellites, créées pour se classer sur des recherches voisines.
Des chiffres fragiles, des questions ouvertes
Les visites sont des estimations d’un outil tiers, Semrush. Les décomptes de pages ne concordent pas : Search Engine Roundtable fait état de 6 millions de pages indexées, Semrush en voit 39 millions classées aux États-Unis. Aucune source n’explique l’écart.
Westbrook doute que la plupart des utilisateurs sachent que leurs messages servent de sources. Il n’a trouvé aucun moyen de retirer une publication d’un résumé déjà en ligne. Au 3 novembre, Meta n’avait pas répondu à sa demande de commentaire.
Notre analyse
Un réseau social transforme ici en masse les publications de ses membres en pages écrites par une IA, puis les ouvre à Google comme le ferait un éditeur. Westbrook n’y voit aucun contrôle éditorial apparent. Selon Semrush, le trafic du répertoire ne pèse qu’environ 2 % de celui de Reddit, mais il a été multiplié par près de 40 depuis juillet.
Les premiers concernés sont les éditeurs qui vivent des recherches pratiques : voyage, sport, finances personnelles. Ils partagent désormais avec ces résumés les résultats de Google. Les marques sont touchées autrement : une page peut décrire un produit à partir de messages de clients, sans que l’entreprise ait la main sur le texte. Westbrook propose de suivre ces mentions par une recherche limitée au répertoire : site:facebook.com/fb-answers suivi du nom de la marque.
Le 7 novembre, MACCUS a constaté que le répertoire existe, qu’il est ouvert à Googlebot et fermé aux robots d’entraînement comme aux robots d’IA des autres entreprises. Plusieurs de ses pages portent des titres quasi identiques. Le trafic et le nombre de pages restent des estimations, le lien avec le mode IA de Facebook une hypothèse. La qualification de spam reste l’avis de consultants, car Google ne s’est pas prononcé.
La suite se jouera d’abord chez Google : une chute brutale de ces pages à la prochaine mise à jour signalerait une réaction. Une explication de Meta et les estimations de novembre compteront aussi. Des pages en français dans google.fr mettraient les éditeurs francophones en concurrence avec ces résumés.
Sources
- Facebook made one quiet change, and increased organic traffic by over 40 million visits a month, Saul Westbrook, Peripheral, 4 novembre 2026
- Facebook Answers AI-Generated 6 Million Pages Is Google Scaled Content Abuse, Search Engine Roundtable, 5 novembre 2026
- Using American Express for Travel, Facebook (répertoire fb-answers), consulté le 7 novembre 2026
- robots.txt, Facebook, consulté le 7 novembre 2026
- New AI Tools to Help You Make Things Happen on Facebook, Meta, 15 juin 2026
- Règles concernant le spam dans la recherche sur le Web Google, Google Search Central, mis à jour le 31 août 2026
- Liste des robots d’exploration communs de Google, Google for Developers, mis à jour le 4 novembre 2026
- Conseils de la recherche Google concernant le contenu généré par IA, Google Search Central, 8 février 2023
Image d’en-tête : graphique MACCUS. Données : estimations Semrush publiées par Saul Westbrook (Peripheral), 4 novembre 2026.