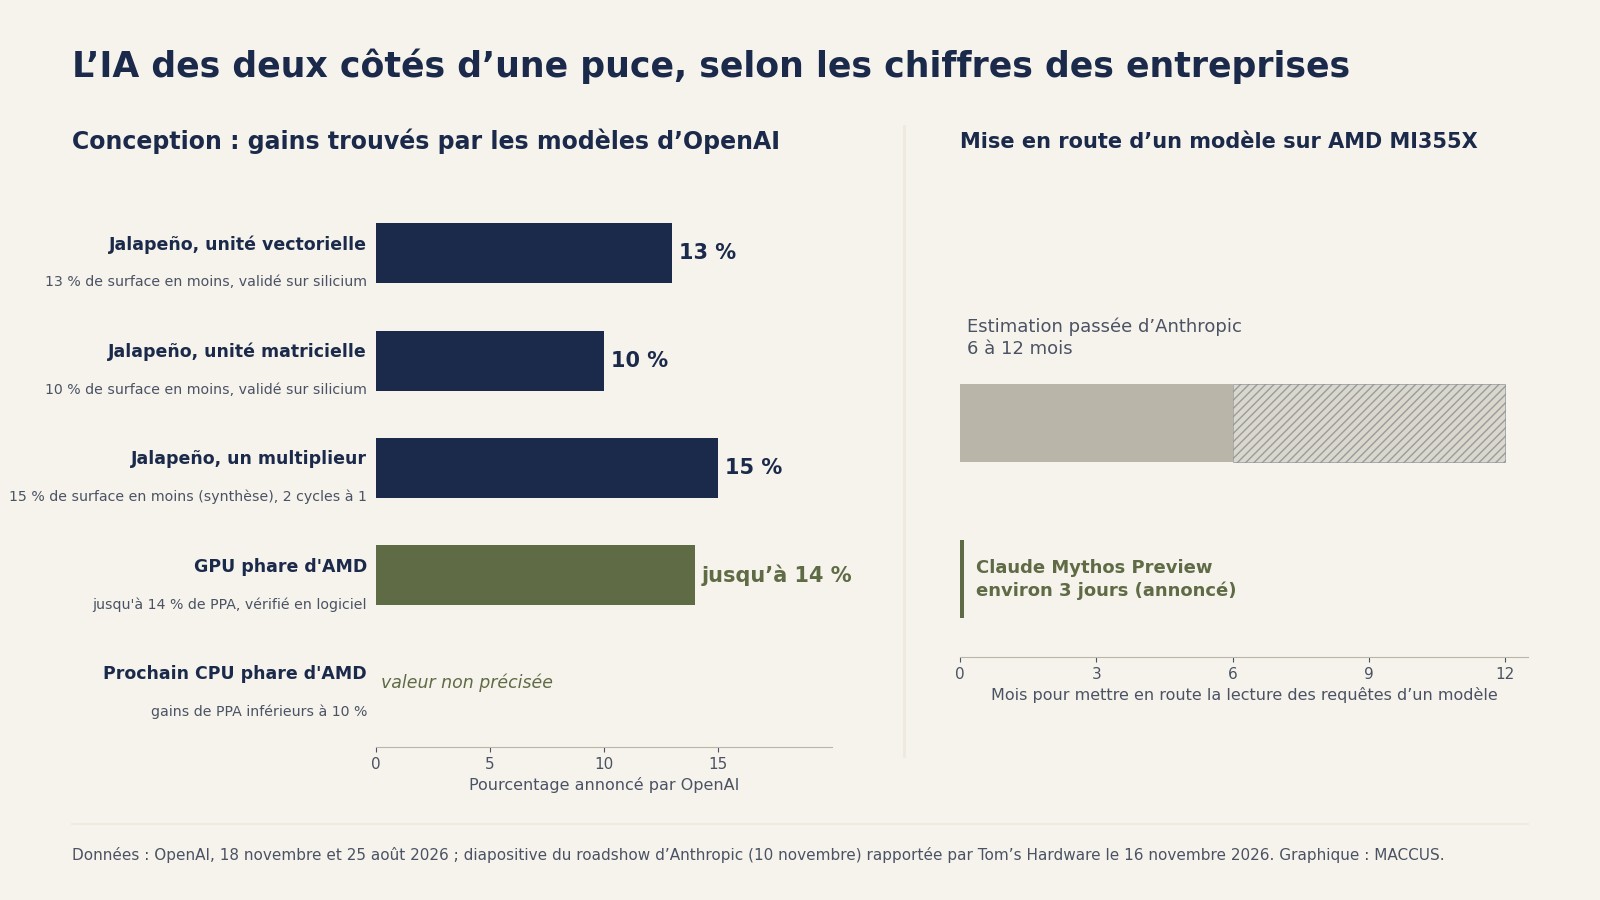

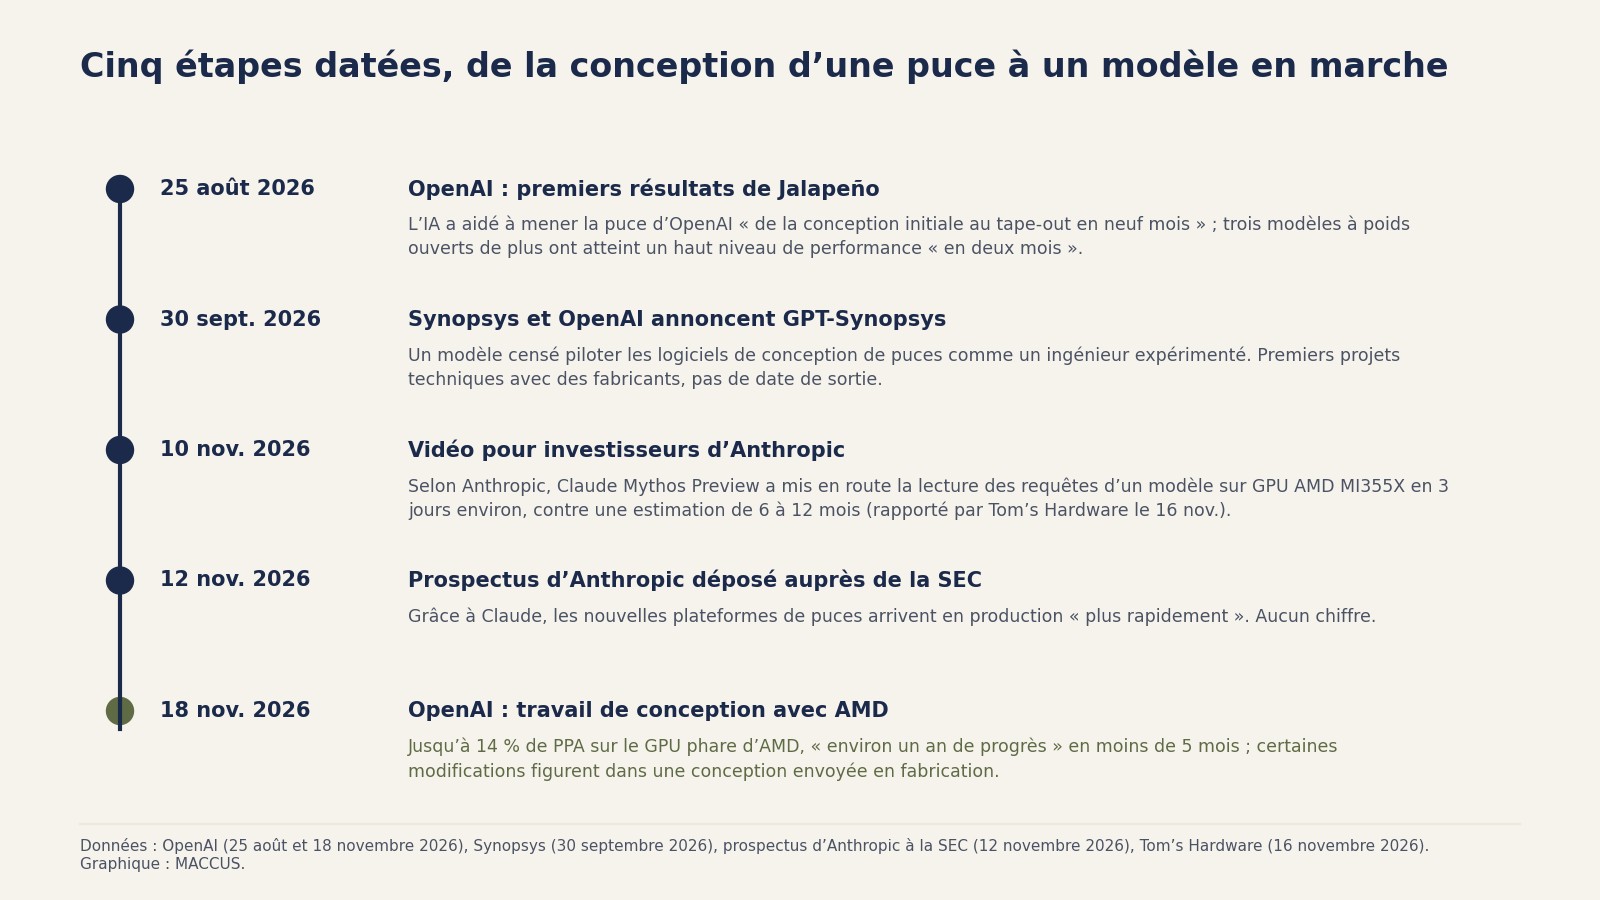
Le 18 novembre 2026, OpenAI a annoncé que ses modèles avaient trouvé, en moins de cinq mois, l’équivalent d’« environ un an de progrès » sur le prochain processeur graphique (GPU) haut de gamme d’AMD. OpenAI chiffre le gain à 14 % au plus sur le PPA, c’est-à-dire la consommation, la performance ou la surface de la puce, sans dire lequel des trois. Selon OpenAI, AMD a déjà repris une partie des modifications dans la conception d’une puce récemment envoyée en fabrication.
Deux jours plus tôt, le site Tom’s Hardware rapportait une annonce comparable d’Anthropic, l’éditeur de l’assistant Claude, faite dans une vidéo pour investisseurs avant son entrée en Bourse. Selon l’entreprise, son modèle Claude Mythos Preview a écrit presque tout le code de bas niveau permettant à l’un de ses modèles de lire les requêtes, première étape d’une réponse, sur des GPU AMD. Le travail aurait pris trois jours environ, contre 6 à 12 mois auparavant pour ses ingénieurs.
Chaque annonce vient d’une entreprise qui vante son propre modèle. Mises bout à bout, elles montrent l’IA employée pour concevoir une puce, puis pour écrire le logiciel qui la fait fonctionner. Aucune des deux n’a publié ses plans de puce ou son code.
Jusqu’à 14 % sur le GPU phare d’AMD
Avec AMD, le modèle d’OpenAI a réécrit des parties du RTL de ce GPU, le code qui décrit ses circuits avant leur traduction en plan physique, rédigé en langage SystemVerilog. Après chaque réécriture, il a vérifié avec les logiciels de conception de Synopsys que le bloc modifié, une partie de la puce, se comportait comme avant. Il en a aussi mesuré le PPA.
OpenAI annonce un gain de PPA allant « jusqu’à 14 % » par rapport à des versions de référence déjà « très optimisées ». Le chiffre d’un an de progrès est une estimation d’OpenAI, dont le billet ne donne pas la méthode.
AMD a aussi intégré d’autres modifications à ses fichiers de production pour de futures versions, selon OpenAI. Le billet ajoute qu’AMD a vérifié des gains de PPA « à un chiffre », soit moins de 10 %, sur des blocs clés de son prochain processeur central (CPU) haut de gamme, à partir de circuits écrits par le modèle. Au 19 novembre, AMD n’avait rien publié en son nom sur ce travail.
La même méthode sur la puce d’OpenAI
Le travail avec AMD prolonge celui mené sur Jalapeño, la puce conçue par OpenAI pour faire tourner ses modèles dans ses centres de données. L’entreprise prévoit de l’y mettre en service d’ici fin 2026. Elle dit avoir commencé à utiliser son modèle GPT-4o pour la concevoir début 2025.
Selon les estimations d’OpenAI, les modifications proposées par ses modèles ont réduit la surface des cellules standard, les briques logiques de base d’une puce. La baisse atteint environ 13 % dans l’unité vectorielle et 10 % dans l’unité matricielle, deux des principaux blocs de calcul de Jalapeño. Ces économies sont « validées sur silicium », c’est-à-dire confirmées sur les puces fabriquées.
Un multiplieur remanié de l’unité matricielle occupe aussi environ 15 % de surface en moins. Ce chiffre a été mesuré en logiciel, à la synthèse, l’étape où le code est traduit en circuit logique. Le multiplieur termine son calcul en un cycle d’horloge au lieu de deux.
Le premier bilan de Jalapeño, publié le 25 août 2026, attribuait déjà à l’IA un passage « de la conception initiale au tape-out en neuf mois ». Le tape-out est l’envoi du plan final en fabrication. L’équipe a ensuite fait tourner sur la puce trois modèles à poids ouverts (téléchargeables librement) non prévus au départ. Avec son agent de programmation Codex et son modèle GPT-Astra, elle les a amenés « à un haut niveau de performance en deux mois ».
Trois jours sur les GPU d’AMD, selon Anthropic
Pour faire fonctionner un modèle d’IA sur une nouvelle puce, il faut des noyaux de calcul (kernels), de petits programmes de bas niveau qui exécutent ses opérations sur ce processeur. Une grande partie de ce code a été écrite pour CUDA, la plateforme logicielle de Nvidia, et doit être convertie pour les puces d’AMD, rappelle Tom’s Hardware.
La vidéo d’Anthropic, rapportée par Tom’s Hardware le 16 novembre, date du 10 novembre. Tom Brown, cofondateur d’Anthropic et directeur du calcul, y dit que Claude Mythos Preview a fait tourner Claude sur AMD « en seulement trois jours, pratiquement sans intervention humaine ». Le modèle aurait « porté ou écrit près de 100 % des kernels », un travail qui occupait jusque-là « des dizaines d’ingénieurs pendant des mois ».
Une note en bas de diapositive limite les trois jours environ à la mise en route de « la lecture des requêtes (prefill) pour un modèle d’Anthropic sur des GPU AMD MI355X, à un niveau de performance utile ». La lecture des requêtes est la première phase d’une réponse : le modèle lit la demande avant de commencer à écrire. Le MI355X est un GPU d’AMD pour centres de données.
Les 6 à 12 mois sont une estimation tirée, selon la note, de « l’expérience passée de mise en service de nouveaux accélérateurs », c’est-à-dire de puces de calcul. Un prospectus déposé le 12 novembre auprès de la SEC, le gendarme boursier américain, décrit le même gain de temps, sans chiffre. Selon ce document, mettre en production une nouvelle plateforme de puces demandait autrefois « un effort d’ingénierie intense sur de nombreux mois ». Grâce à Claude, les équipes d’Anthropic le font désormais « plus rapidement ».
Le prospectus cite quatre familles de puces utilisées pour Claude : celles d’Amazon (Trainium) et de Google (TPU), et les GPU de Nvidia et d’AMD. Les plus gros engagements de l’entreprise figurent dans les contrats de calcul signés par Anthropic.
Un modèle en cours d’entraînement sur les logiciels de conception
Le 30 septembre 2026, Synopsys a annoncé avec OpenAI le modèle GPT-Synopsys. Il doit piloter les logiciels de conception comme un ingénieur expérimenté, et mener une conception jusqu’à sa relecture par un ingénieur. Les deux entreprises évoquaient des « premiers projets techniques » avec des fabricants de puces, sans date de sortie.
« Nous utilisons notre technologie la plus avancée pour améliorer les systèmes qui font tourner l’IA », déclarait alors Greg Brockman, président d’OpenAI. Le billet du 18 novembre indique qu’OpenAI s’associe à Synopsys pour entraîner le modèle.
Les limites posées par les sources
Les gains chez AMD portent sur des conceptions existantes, déjà optimisées, et ont été vérifiés en logiciel. « Jusqu’à 14 % » est le haut d’une fourchette qu’OpenAI ne détaille pas : le billet ne dit ni s’il s’agit de consommation, de performance ou de surface, ni sur quels blocs. Ce chiffre ne signifie donc pas que le GPU tourne 14 % plus vite.
Selon OpenAI, c’est AMD qui a intégré ces modifications à ses fichiers de conception. OpenAI ne cite aucune puce en vente qui les intègre. Seules les économies de 13 % et 10 % sur Jalapeño sont présentées comme validées sur silicium.
Le billet décrit aussi un test, avec ses réserves, sur PicoRV32 et Ibex, deux petits cœurs de processeur en source ouverte bâtis sur l’architecture libre RISC-V. Les modèles d’OpenAI devaient augmenter leur débit, en instructions par seconde. Les circuits obtenus ont été vérifiés en simulation et notés par rapport au meilleur résultat observé, sur 9 881 essais au total.
Avec un budget d’environ 112 000 jetons par essai (les unités de texte que traite un modèle), GPT-6.2 Astra, sorti le 17 novembre obtient la meilleure moyenne sur les deux cœurs. Sur PicoRV32, son score atteint environ le double de celui de GPT-6 Astra.
Les modèles ont obtenu de meilleures notes en concevant un cœur à partir d’un cahier des charges qu’en améliorant un cœur existant. OpenAI reconnaît que ces conceptions pouvaient omettre des fonctions des originaux, comme les compteurs de performance. Selon l’entreprise, le test serait « plus représentatif de la conception de puces en production » s’il exigeait ces fonctions, plafonnait davantage la surface et contrôlait le timing des circuits après synthèse physique.
Sur le forum technique Hacker News, le billet comptait environ 150 points (votes de lecteurs) le 19 au matin. Des commentateurs ont relevé des notes sans unité et des circuits RISC-V non publiés. Certains ont vu dans le calendrier du billet d’OpenAI, à l’approche de l’introduction en Bourse d’Anthropic, une opération de communication.
Les trois jours d’Anthropic ne valent que pour la lecture des requêtes d’un seul modèle sur un seul modèle de puce, le MI355X. L’entreprise ne définit pas le « niveau de performance utile » atteint. Le chiffre vient d’une vidéo pour investisseurs, en pleine opération boursière, et ne figure pas dans le prospectus déposé.
Notre analyse
Prises au mot, ces annonces forment une boucle : l’IA aide à concevoir et à mettre en route les puces qui la font tourner. Le 10 novembre, Anthropic a indiqué avoir atteint le seuil de sécurité qu’elle s’est fixé pour une IA qui accélère sa propre recherche. Les annonces sur les puces étendent cette idée au matériel.
L’enjeu est la capacité de calcul. Dans son prospectus, Anthropic dit avoir « constamment fonctionné avec un calcul limité, la demande des clients dépassant le calcul disponible ». Des puces conçues et mises en route plus vite permettraient aux laboratoires d’IA d’ajouter des fournisseurs et d’exploiter plus tôt leur matériel.
Aucun tiers n’a encore publié de mesure de ces résultats. Côté OpenAI, les prochains repères sont une déclaration d’AMD nommant les produits qui intègrent des modifications issues de ses modèles, la publication des circuits RISC-V, la mise en service de Jalapeño et une date de sortie pour GPT-Synopsys. Côté Anthropic, ses premières puces AMD MI450, attendues au premier semestre 2027 selon Tom’s Hardware, diront si les trois jours se répètent sur une nouvelle génération de puces.
Sources
- Advancing chip design with OpenAI models, OpenAI, 18 novembre 2026
- Jalapeño’s first results show industry-leading speed and efficiency in AI inference, OpenAI, 25 août 2026
- Anthropic says Claude Mythos slashed software work to onboard AMD GPUs from up to 12 months to around three days, Tom’s Hardware, 16 novembre 2026
- Issuer Free Writing Prospectus (EEA Prospectus), Anthropic, PBC, dépôt SEC, 12 novembre 2026
- OpenAI and Synopsys Announce GPT-Synopsys: Frontier Intelligence to Revolutionize Chip Design, Synopsys, 30 septembre 2026
- Advancing chip design with OpenAI models (discussion), Hacker News, 18 novembre 2026
Image d’en-tête : graphique MACCUS, d’après OpenAI (18 novembre et 25 août 2026) et la diapositive du roadshow d’Anthropic rapportée par Tom’s Hardware (16 novembre 2026)