Des chercheurs d’Amazon ont présenté le 9 novembre 2026 une méthode, HOPE, qui allège certains grands modèles d’IA ouverts sans les réentraîner. L’enjeu est la mémoire : un modèle plus léger tourne sur une machine plus petite.
Ils l’ont testée sur Qwen3.5-35B-A3B, un modèle de l’équipe Qwen d’Alibaba que chacun peut télécharger. HOPE lui a retiré pour de bon la moitié de ses « experts », les sous-réseaux spécialisés qui le composent. Allégé, le modèle obtient 42,3 sur 100 au test de programmation SWE-Bench Pro, contre 41,8 pour la version complète.
Leur billet sur le blog de Hugging Face, un site de partage de modèles d’IA, présente un article scientifique mis en ligne le 16 septembre 2026. Ses tableaux complets montrent aussi les limites du résultat.
Des experts qui encombrent la mémoire
Les modèles testés, deux Qwen3.5 et le modèle ouvert GLM-4.5-Air, reposent sur une architecture dite « mélange d’experts » (MoE en anglais). Chaque couche de calcul contient 128 ou 256 experts. Pour chaque token, le fragment de mot traité, un aiguilleur n’en active que quelques-uns.
Selon sa fiche sur Hugging Face, Qwen3.5-35B-A3B compte 35 milliards de paramètres, les valeurs numériques apprises par le modèle. Seuls 3 milliards servent pour chaque token. Ses 40 couches contiennent chacune 256 experts, dont 8 actifs à la fois, plus un expert partagé qui sert toujours. Il les combine avec des couches Gated DeltaNet, une forme d’attention linéaire : une version économe en mémoire du mécanisme qui relie les mots entre eux.
Le billet d’Amazon cite Qwen3.5-122B, la version à 122 milliards. Ses experts représentent 95 % de ses quelque 250 Go, alors que seuls 8 sur 256 travaillent par couche pour chaque token. Selon l’article scientifique, retirer la moitié des experts ramènerait le modèle à 125 Go. Ce poids détermine la machine nécessaire pour faire tourner un modèle en local, sur les serveurs de l’entreprise.
Supprimer des experts s’appelle l’élagage (pruning en anglais). Les auteurs le distinguent de la quantification, une compression qui stocke chaque paramètre sur moins de bits. La quantification allège chaque expert, mais tous restent en mémoire. Les deux techniques peuvent se cumuler.
Une méthode qui tient compte des paires d’experts
Le point délicat est le choix des experts à retirer. Les méthodes existantes font passer dans le modèle un échantillon de requêtes, le jeu de calibration, et notent chaque expert isolément. Elles retirent ensuite les moins utiles, couche par couche. La méthode de référence, REAP, a été publiée en octobre 2025 par des chercheurs du fabricant de puces Cerebras.
Les cinq auteurs de HOPE, de l’équipe AWS Agentic AI d’Amazon, partent d’un autre constat : les experts travaillent en groupes stables, qui s’activent ensemble. Retirer un expert jugé peu utile peut priver un expert important de son partenaire habituel.
HOPE (pour Higher-Order Pruning of Experts, élagage d’ordre supérieur) mesure donc aussi ce que chaque paire d’experts apporte. Un calcul d’optimisation choisit ensuite les experts à retirer en perturbant le moins possible le modèle.
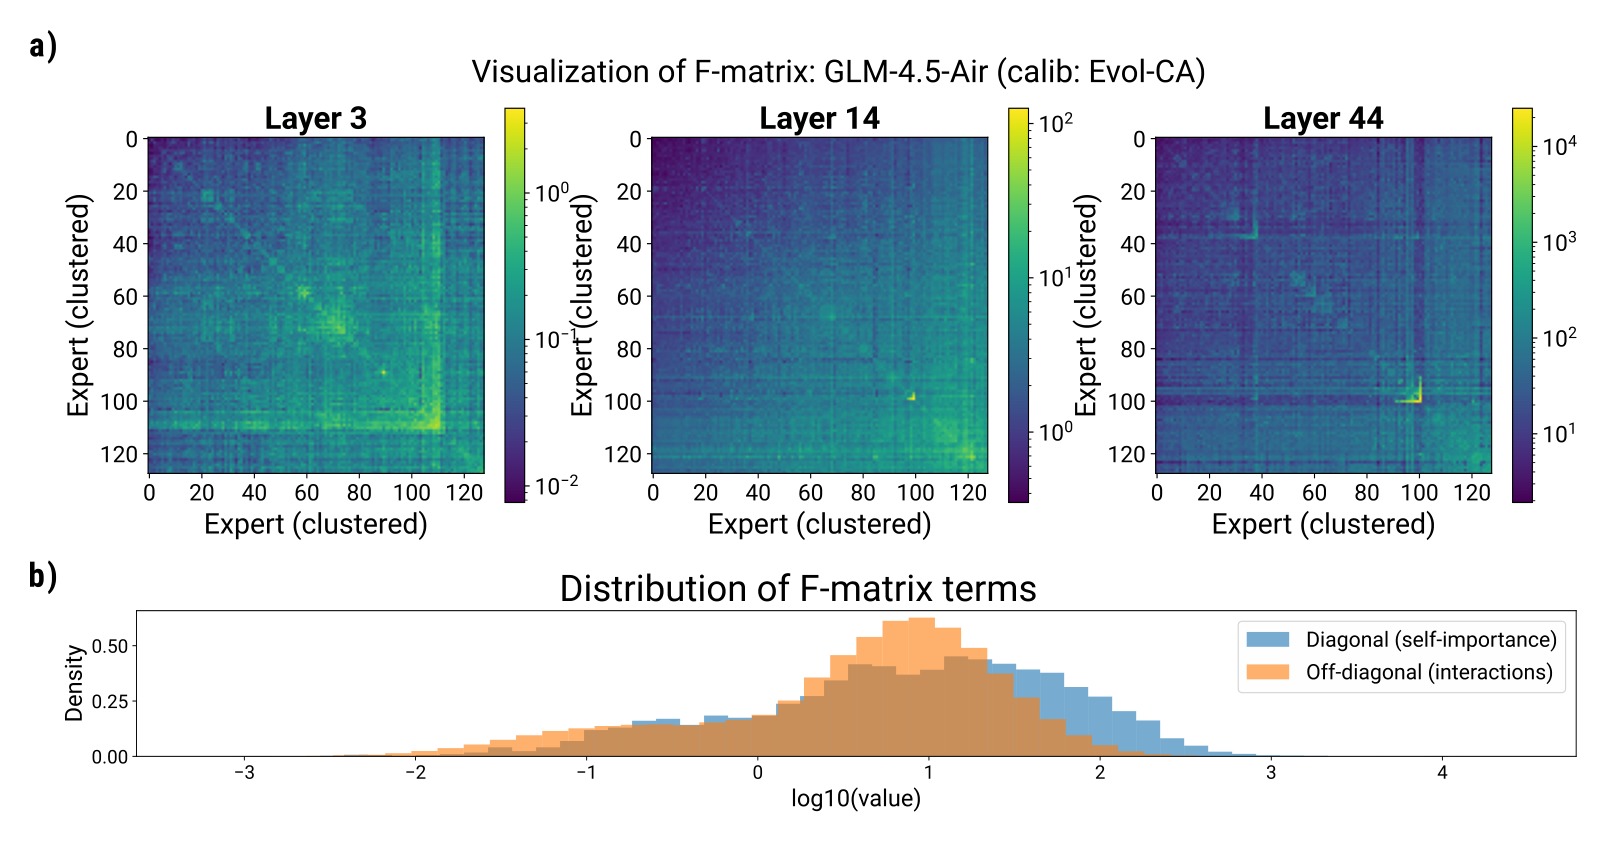
Selon les auteurs, la partie de HOPE qui note chaque expert seul reproduit presque exactement le classement de REAP, avec une corrélation de 0,988 sur un maximum de 1. L’écart entre les deux méthodes vient donc des paires.
Face à REAP, le surcoût de calcul est faible : une à deux secondes par couche. Sur le modèle de 35 milliards, la calibration a pris 1,27 heure pour 1 000 requêtes, contre 1,20 heure avec REAP, sur un matériel non précisé.
Le code est publié sous licence libre Apache 2.0 sur GitHub, la plateforme de partage de code. Il fonctionne en trois commandes et produit un modèle au format standard de Hugging Face, plus petit sur disque et en mémoire. Selon le billet, ce modèle se charge sans modification dans vLLM et SGLang, deux logiciels qui font tourner des modèles sur un serveur. Début novembre, GPT-6 Astra, d’OpenAI, avait déjà modifié sans entraînement les paramètres d’un modèle Qwen.
Les résultats annoncés par Amazon
Cinq méthodes ont retiré de 10 à 50 % des experts. À côté de HOPE et REAP, EAN et MAN notent elles aussi chaque expert seul, et la cinquième, la plus simple, retire les experts les moins sollicités. Chacune est calibrée soit sur des questions de programmation (Evol-CodeAlpaca), soit sur des sessions d’un agent qui corrige du code de lui-même (SWE-Bench Verified).
Les tests, notés sur 100, comprennent la batterie Tulu 3 : mathématiques, respect des consignes, connaissances générales et code. Ils comprennent aussi SWE-Bench Pro, 731 tâches tirées de projets logiciels d’entreprise, où le modèle testé travaille en agent.
Toutes situations confondues, HOPE obtient le meilleur rang moyen des cinq méthodes, 2,07, et la première place dans 39 % des cas. Quand la moitié des experts est retirée, son rang moyen passe à 1,58, contre 2,42 pour REAP, deuxième.
Le résultat mis en avant porte sur Qwen3.5-35B-A3B élagué de moitié et calibré sur du code. Sur SWE-Bench Pro, HOPE obtient 42,3, contre 41,8 pour le modèle complet et 36,2 avec REAP. L’écart de 0,5 point avec le modèle complet reste dans la variation entre les trois essais publiés, 1,2 point : les deux font jeu égal. Amazon annonce un gain « allant jusqu’à +6,1 % » sur la méthode classée deuxième, pour ces tâches de code d’agent.
Les limites visibles dans l’article
Les 6,1 % annoncés sont l’écart en points avec REAP, deuxième quand la moitié des experts est retirée : 42,3 contre 36,2. Dans ce même test, EAN obtient pourtant 40,6 : l’avance de HOPE sur la meilleure concurrente tombe à moins de deux points. Selon l’article scientifique, cette avance plafonne à 2,0 points sur SWE-Bench Pro.
Le score de 42,3 dépend aussi du jeu de calibration. Calibré sur les sessions d’agent, le même modèle élagué de moitié obtient 40,8, un point sous le modèle complet. REAP obtient alors 40,2 et MAN 40,6, tout près de HOPE. Les auteurs notent qu’un modèle élagué dépasse parfois l’original, un effet déjà observé avec d’autres méthodes.
Sur le grand modèle, Qwen3.5-122B-A10B, le résultat ne se répète pas toujours. Calibré sur du code et élagué de moitié par HOPE, il tombe à 43,8 sur SWE-Bench Pro, contre 50,2 pour le modèle complet. Deux méthodes font alors mieux : EAN, à 48,3, et même la plus simple, à 45,7. Avec les sessions d’agent, HOPE garde 50,6, mais EAN fait mieux, à 51,8.
Les tests généraux reculent aussi, sur deux des trois modèles. Sur Qwen3.5-35B-A3B élagué de moitié et calibré sur du code, la moyenne Tulu 3 passe de 48,9 à 42,9 avec HOPE, et à 43,0 avec REAP. Sur GLM-4.5-Air, REAP devance HOPE avec les deux jeux de calibration : 44,7 contre 43,3, puis 43,4 contre 40,9.
Le billet d’Amazon affirme que la calibration sur du code n’a pas « sévèrement » dégradé les tests hors programmation. Élagué de moitié par HOPE avec cette calibration, Qwen3.5-35B-A3B passe pourtant de 65,2 à 29,8 au test de connaissances générales MMLU.
Les auteurs signalent eux-mêmes trois limites. L’avantage de HOPE se réduit quand on retire peu d’experts, entre 10 et 20 %. La méthode traite chaque couche séparément. Elle mesure les paires d’experts, sans aller jusqu’aux groupes de trois ou plus.
Le cas des postes de travail
Ni le billet ni le dépôt GitHub ne mentionnent llama.cpp ou GGUF, le logiciel et le format de fichier utilisés sur les postes de travail. Aucun modèle élagué n’est publié avec le code. Il faut lancer soi-même la calibration, avec le modèle complet chargé dans Transformers, la bibliothèque de Hugging Face.
Le développeur Filip Lebiecki a publié le 24 octobre sur GitHub un test qui nuance l’intérêt de l’élagage sur une carte graphique de 16 Go. Avec REAP, il a gardé 128 des 256 experts de Qwen3.5-35B-A3B, soit 19 milliards de paramètres.
À taille de fichier égale, environ 10,6 Gio, compresser davantage le modèle entier a mieux réussi que l’élaguer. Compressé à 2,6 bits par paramètre, il obtient 91,4 sur 100 de moyenne à trois tests de maths, de code et de connaissances. Le modèle élagué, compressé à 4,9 bits, obtient 82,7.
Notre analyse
HOPE affine le choix des experts à retirer en tenant compte de ceux qui travaillent ensemble. Le gain apparaît surtout quand la moitié des experts disparaît, et sur des tâches d’agent longues. C’est le réglage utile pour faire tenir un gros modèle sur une machine plus petite.
Pour les équipes qui font tourner des modèles ouverts sur leurs propres serveurs, comme Revolut avec un modèle GLM auto-hébergé, la mémoire fixe le prix du matériel. Selon le dépôt de Filip Lebiecki, Qwen3.5-35B-A3B pèse 67 Gio dans son format d’origine (16 bits par paramètre). Qwen3.5-35B-A3B et le code de HOPE sont tous deux sous licence Apache 2.0, qui autorise la diffusion de versions modifiées, élaguées comprises.
Le résultat vedette tient sur un modèle, un jeu de calibration et un test. Ailleurs, d’autres méthodes font parfois mieux, et les tests généraux reculent sur deux modèles sur trois. Ce modèle élagué garde son score sur SWE-Bench Pro, mais tombe de 64,3 à 48,0 sur LiveCodeBench, l’autre test de code de l’article. Aucun des tests publiés ne mesure le français.
Plusieurs points restent à vérifier : la qualité de ces modèles une fois convertis en GGUF et compressés, et leur tenue sur des tâches longues hors programmation. Les auteurs jugent aussi préliminaires les résultats d’une variante qui répartit l’élagage entre les couches. Les premiers modèles élagués avec HOPE sur Hugging Face, et des tests indépendants, diront si le score de programmation tient hors des laboratoires d’Amazon.
Sources
- Your Experts Have Partners. There’s HOPE for Keeping Them Together, Amazon (blog Hugging Face), 9 novembre 2026
- Higher-order pruning of experts in mixture-of-experts language models, Tseng et al. (AWS), arXiv, 29 septembre 2026
- awslabs/HOPE, Amazon Web Services (GitHub), 30 septembre 2026
- Qwen3.5-35B-A3B, Qwen (Hugging Face), 24 février 2026
- REAP: One-Shot Pruning for Trillion-Parameter Mixture-of-Experts Models, Cerebras, 16 octobre 2025
- Shrinking Qwen3.5-35B-A3B: MoE expert pruning, distillation, quantization, Filip Lebiecki (GitHub), 24 octobre 2026
Image d’en-tête : graphique MACCUS, données Tseng et al. (AWS), arXiv 2609.18916, tableau S4