Trois chercheurs de Google ont présenté Muir, une architecture de modèle de langage, le 5 novembre 2026 sur arXiv, le site de prépublications scientifiques. L’un d’eux est aussi rattaché à l’université du Texas à Austin. Leur modèle de 1,34 milliard de paramètres a lu des textes continus de 10 millions de tokens, ou fragments de mots, avec une mémoire de travail fixe de 25 Mo. Un Transformer de même taille, l’architecture des grands modèles actuels, aurait besoin pour cela d’une mémoire cache de 2,1 To, selon leurs calculs.
Ce cache limite aujourd’hui la longueur de texte qu’un modèle peut lire d’un bloc, son « contexte », quand on le fait tourner sur ses propres machines. Muir reste un travail de recherche : les modèles testés sont petits et entraînés sur des textes de 4 096 tokens. Leurs poids, les fichiers du modèle entraîné, ne sont pas publiés.
Une mémoire qui ne grossit pas avec le texte
Un Transformer garde la trace de chaque token lu dans une mémoire appelée cache KV, pour « clés et valeurs ». Ce cache grandit à chaque nouveau token. Pour 10 millions de tokens, les auteurs l’évaluent à 2,1 To avec des nombres codés sur 16 bits, et à 0,32 To compressé à 2,5 bits.
Muir relève d’une autre approche, l’attention linéaire. Le modèle y résume tout ce qu’il a lu dans un état de taille fixe, mis à jour à chaque token. Chez Muir, cet état pèse 25 Mo pour ses 24 couches de calcul, que le texte compte 4 000 ou 10 millions de tokens.
Les auteurs rappellent la limite de cette approche : un état de taille fixe ne peut pas tout retenir. Plus le modèle y écrit, plus les nouvelles informations brouillent les anciennes. Les modèles dits « à règle delta » atténuent ce défaut. Avant d’écrire une valeur sous une clé, sorte d’étiquette, ils effacent celle qui s’y trouvait déjà.
Trois retouches à un modèle existant
Muir part de Gated DeltaNet-2 (GDN-2), un modèle à règle delta publié le 21 mai 2026 par Ali Hatamizadeh, Yejin Choi et Jan Kautz. Son code est hébergé par le laboratoire de recherche de NVIDIA. GDN-2 règle séparément l’effacement et l’écriture dans son état, grâce à des « portes », des vannes apprises qui dosent chaque opération.
Première retouche : selon les mesures des auteurs, l’état est environ 13 fois plus sensible à ce qui y est écrit qu’à ce qui en est effacé. Muir réduit donc les portes d’effacement et regroupe toutes ses portes dans un seul bloc compact. Les paramètres économisés élargissent une autre partie du réseau, jusqu’à 30,4 % de plus, à taille totale égale.
Deuxième retouche : certaines parties de l’état s’effacent lentement et accumulent de grandes valeurs. Elles dominent ce que le modèle relit et le poussent à effacer plus fort, au risque d’écraser des informations utiles. Muir ajoute une porte de lecture qui les rééquilibre, sur le principe du filtre adapté employé en traitement du signal. Cette porte s’ajuste à chaque token, sauf dans une variante dite à « lecture fixe ».
Troisième retouche : les auteurs ont conçu une nouvelle méthode de calcul pour l’entraînement, stable sur les grands blocs de texte qu’exigent les TPU, les puces d’IA de Google.
Les résultats annoncés
Les auteurs ont entraîné à partir de zéro des modèles de 166 millions à 1,34 milliard de paramètres, sur huit puces TPU7x. Ils ont utilisé 100 milliards de tokens de FineWeb-Edu, un corpus de pages éducatives. Muir est comparé à GDN-2 et à un Transformer de même taille.
La perplexité mesure la qualité de prédiction du token suivant : plus elle est basse, mieux le modèle prédit. Muir fait 1,8 à 2,0 % mieux que GDN-2 sur ce critère, et 2,5 à 3,6 % mieux que le Transformer. Sur des tests de raisonnement de bon sens, le gain atteint au plus 1,9 point.
Les modèles ont aussi lu trois textes de 10 millions de tokens, faits de documents mis bout à bout. Les auteurs mesurent la perplexité sur des fenêtres de texte de plus en plus longues, en vidant la mémoire entre deux fenêtres. Sans réentraînement, celle de Muir descend à 8,11 avec des fenêtres de 64 000 tokens, puis ne bouge plus jusqu’à une fenêtre unique de 10 millions.
GDN-2 se stabilise à 8,31, un score moins bon. Le Transformer monte à 10,51 avec des fenêtres de 64 000 tokens, puis dépasse la mémoire des puces.
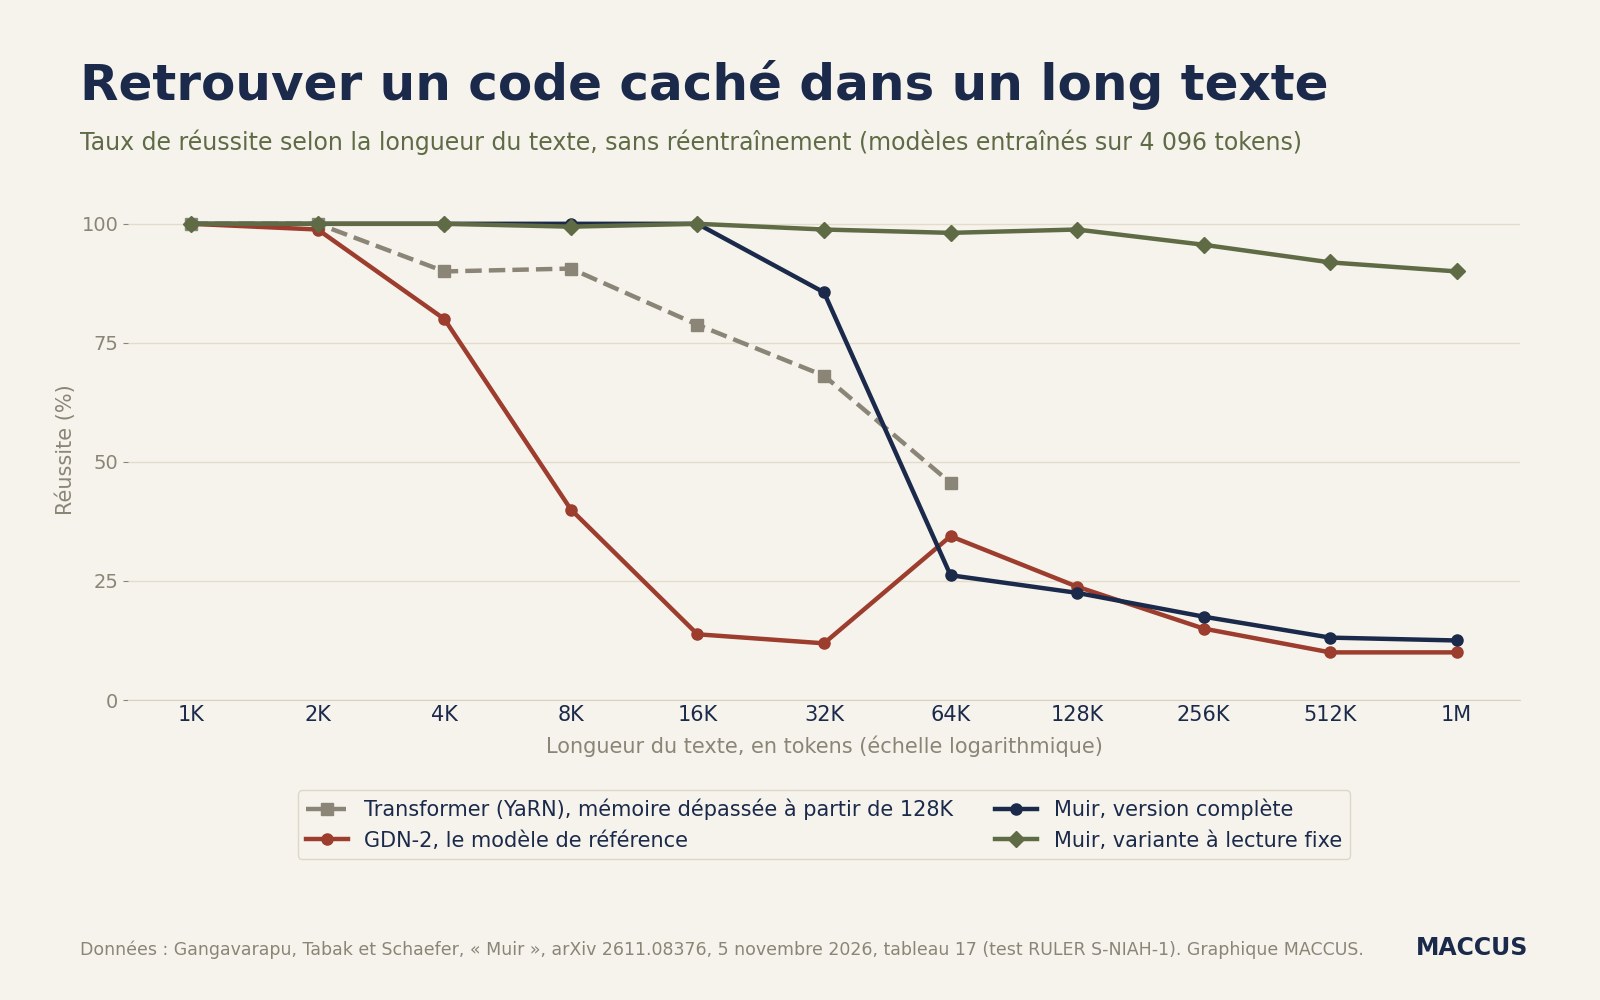
Le test du code caché (RULER S-NIAH-1) demande de retrouver un nombre à sept chiffres glissé dans un long texte de remplissage, fait de phrases répétées. Sans réentraînement, la variante à lecture fixe le retrouve encore dans 90,0 % des cas à 1 million de tokens. Après un court réentraînement sur des textes de 64 000 tokens, elle atteint 99,4 % à cette même longueur d’un million. GDN-2 s’effondre au-delà de 4 000 à 8 000 tokens.
Sur des textes de 32 000 tokens, Muir s’entraîne aussi vite que GDN-2 et 2,7 fois plus vite que le Transformer. Sous environ 11 000 tokens, le Transformer reste plus rapide, reconnaissent les auteurs.
Deux variantes derrière ces résultats
Le résumé de l’article cite côte à côte deux résultats de deux variantes, que seule la mention « avec lecture fixe » distingue. La perplexité stable sur 10 millions de tokens est celle de la version complète de Muir. Le code retrouvé à 1 million de tokens vient de la variante à lecture fixe.
Les auteurs reconnaissent un compromis dans leur conclusion. À budget égal, la lecture fixe retient mieux une information lointaine, et la lecture dynamique répond mieux aux questions portant sur plusieurs passages. Sans réentraînement, la version complète retrouve le code dans 85,6 % des cas à 32 000 tokens, puis dans 26,2 % à 64 000 tokens et 12,5 % à 1 million. La variante à lecture fixe voit sa perplexité dériver légèrement sur les textes continus tant qu’elle n’est pas réentraînée.
Une perplexité stable ne prouve pas non plus que le modèle exploite 10 millions de tokens. Avec une mémoire remise à zéro tous les 64 000 tokens, Muir obtient déjà 8,11, le même score qu’avec les 10 millions lus d’un trait.
Les limites de l’étude
Les modèles testés plafonnent à 1,34 milliard de paramètres. Qwen3.8-Flash-Next, un modèle ouvert d’Alibaba sorti en août, en compte 125 milliards, dont 6 milliards seulement servent pour chaque token.
Le chiffre de 2,1 To est un calcul. En pratique, dans les tests sur 10 millions de tokens et sur le code caché, le Transformer, lancé sans découper le calcul, dépasse la mémoire des puces dès 128 000 tokens. Toutes les mesures ont été faites sur les TPU de Google.
La page arXiv ne renvoie vers aucun dépôt de code ni vers des poids. L’article donne en annexe un code de référence écrit pour JAX, la bibliothèque de calcul de Google. Le texte est une première version, sans relecture par des pairs.
Le site AI Weekly, sous la plume d’Alexis Dufresne, note le 6 novembre que tous les chiffres viennent des auteurs. L’article ajoute que Google n’a pas dit si Muir entrera dans un produit. Une note de sa rédaction juge le résultat à suivre si une autre équipe le reproduit.
Notre analyse
La famille Gated DeltaNet, celle de GDN-2, équipe déjà des modèles locaux. Un hybride de couches Gated DeltaNet et de couches d’attention complète, celle du Transformer, sert dans les séries Qwen3.5 à Qwen3.8. L’équipe Qwen d’Alibaba l’indique dans le dépôt de code de Qwen3.8-Flash-Next, publié le 26 août 2026.
Dans Qwen3.8-Flash-Next, qui préfigure l’architecture de la future génération Qwen4, une couche sur quatre seulement utilise l’attention. Les trois autres gardent un état de taille fixe, les couches d’attention un cache qui s’allonge avec le texte. Ce modèle tourne sur llama.cpp, un logiciel libre d’exécution de modèles en local.
Muir n’a pas été testé dans un tel assemblage. Ses auteurs évoquent l’idée de combiner sa variante à lecture fixe avec une attention sur fenêtre glissante. Celle-ci ne regarde que les derniers tokens et garde elle aussi une mémoire fixe.
Sur une machine locale, la mémoire doit contenir à la fois les poids du modèle et son cache, et les poids en occupent déjà beaucoup. Muse Spark Open, le modèle ouvert de Meta annoncé avec un contexte d’un million de tokens, compte 816 milliards de paramètres. Meta et Apple proposent de le faire tourner sur deux Mac Studio reliés, dotés de 512 Go de mémoire chacun. NVIDIA a présenté le 15 octobre un modèle de 74 milliards de paramètres compressé pour tenir dans 24 Go avec 128 000 tokens de contexte.
Plusieurs questions restent ouvertes : le comportement de Muir à plusieurs dizaines de milliards de paramètres, sur des tâches réelles à long contexte, et dans un modèle hybride. Au-delà de 8 000 tokens, les auteurs n’ont mesuré que la perplexité et le test du code caché. Selon eux, le cœur de Muir tourne sur cartes graphiques avec les programmes de calcul de GDN-2, sans modification. Ils ne publient aucune mesure sur ces cartes.
Restent à suivre la publication de poids ou d’un dépôt de code, et une reprise des résultats par une équipe extérieure. Autre signal : l’arrivée de ces portes dans les modèles ouverts de Qwen, de NVIDIA ou de Moonshot AI, auteur de Kimi Linear, un prédécesseur que cite l’article. Viendrait ensuite leur adoption par llama.cpp et vLLM, autre logiciel d’exécution.
Sources
- Muir: Linear Attention with Sensitivity-Allocated Gating and Matched-Filter Readout, arXiv (Tushaar Gangavarapu, Gil Tabak et Clemens JS Schaefer), 5 novembre 2026
- Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention, arXiv (Ali Hatamizadeh, Yejin Choi et Jan Kautz), 21 mai 2026
- On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability, arXiv (équipe Qwen), 31 août 2026
- Qwen3.8-Flash-Next, Qwen (GitHub), 26 août 2026
- Google’s Muir cuts perplexity 3.6% vs Transformer at 1.34B, AI Weekly, 6 novembre 2026
Image d’en-tête : graphique MACCUS, données de Gangavarapu, Tabak et Schaefer, « Muir », arXiv 2611.08376, 5 novembre 2026.