Le 22 octobre 2026, Gary King et Steven Worthington, de l’Institute for Quantitative Social Science de Harvard, ont mis en ligne un document de travail qui oppose des rapports de relecture écrits par une IA à des rapports humains d’une qualité jugée exceptionnelle. Trois anciens éditeurs de grandes revues, à qui l’on n’avait pas parlé d’IA, ont comparé dix paires de rapports tirées au hasard. Dans 26 jugements sur 30, ils ont préféré le rapport du modèle.
Le relecteur était Claude Opus 4.8, lancé par Anthropic le 28 mai et suivi depuis par Opus 5 puis Opus 5.5. Un juge automatique d’une autre entreprise, GPT-5.5 d’OpenAI, a préféré le rapport de l’IA dans les 132 paires qu’il a pu départager. Vérifiées sur les manuscrits, 5,5 % des affirmations des rapports de l’IA ont été jugées inexactes, contre 15,9 % pour les rapports humains, et l’IA n’a cité aucune source inventée.
L’étude n’a elle-même pas encore été évaluée par des pairs. Elle paraît alors que revues et conférences peinent à trouver des relecteurs face à l’afflux de soumissions.
Un système de relecture sous pression
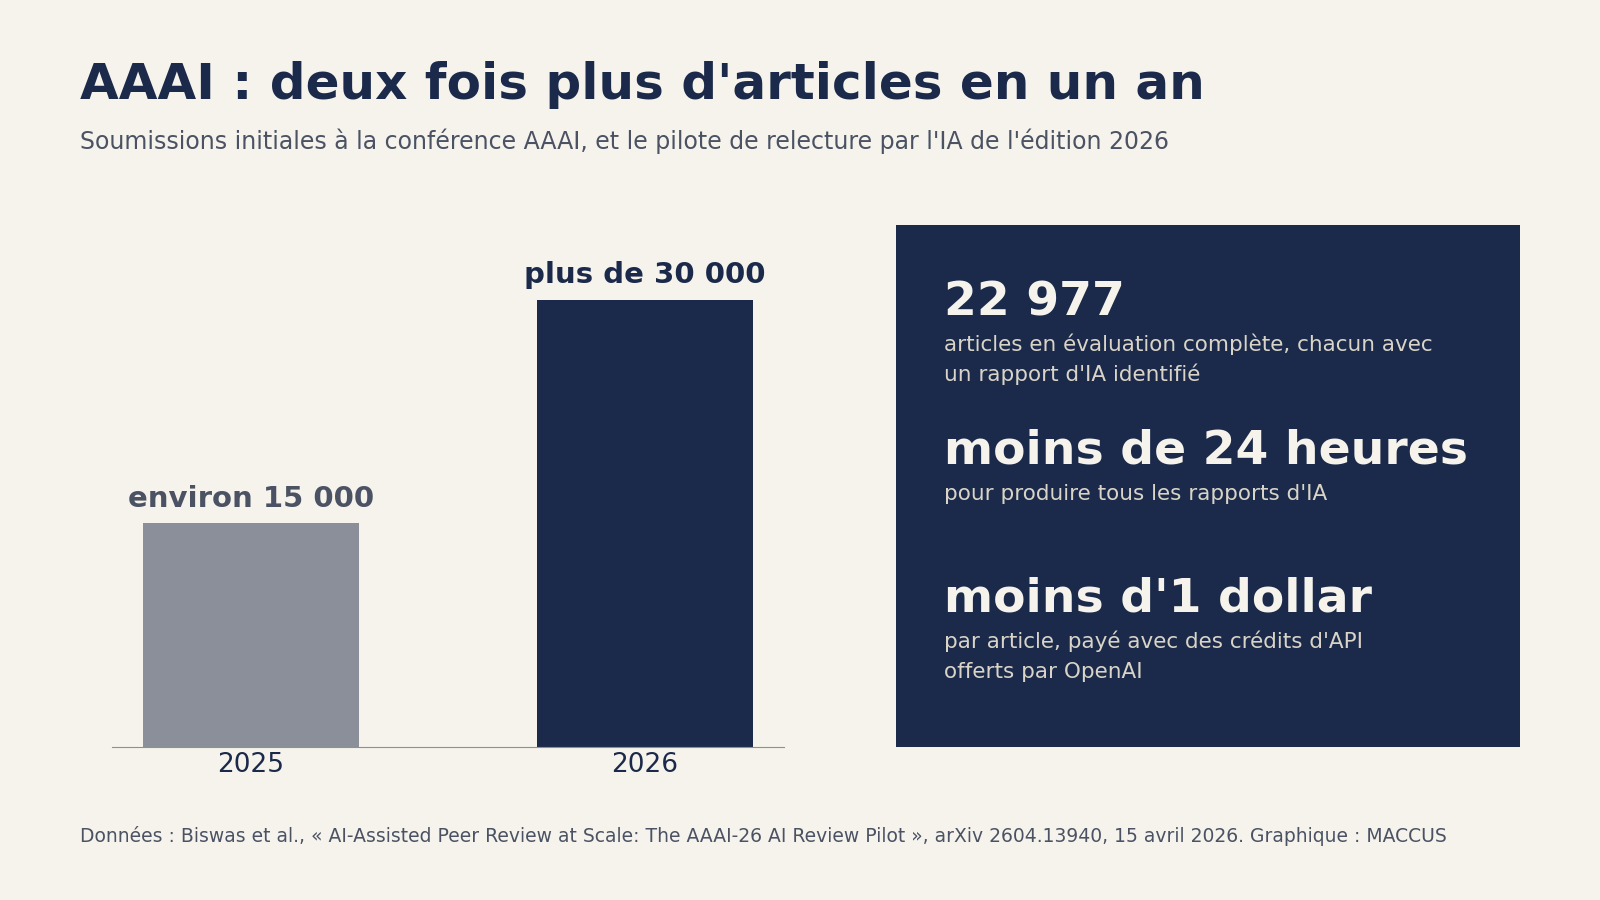
La conférence d’intelligence artificielle AAAI a reçu plus de 30 000 soumissions initiales pour son édition 2026, contre environ 15 000 un an plus tôt, selon un article publié en avril par l’équipe de son pilote de relecture par l’IA. Elle a dû recruter plus de 28 000 relecteurs et présidents de domaine, près de trois fois l’effectif précédent. ICML 2026, grande conférence d’apprentissage automatique, a traité plus de 24 000 articles avec 17 000 relecteurs.
The Economist a décrit la même tension le 23 octobre dans sa lettre Off the Charts : selon l’hebdomadaire, l’IA a aussi facilité la production de travaux médiocres, voire frauduleux, qui submergent les systèmes de modération et d’évaluation par les pairs. Le texte cite James Wilsdon, de l’University College London, à propos d’un chercheur de l’Ivy League qui consacrait une journée par semaine à ses demandes de financement et y passe désormais 45 minutes. Les articles arrivent aussi plus vite : un physicien de Harvard a signé 36 manuscrits en trois mois avec Claude, et trois équipes ont déposé en octobre des preuves obtenues avec l’IA d’une même conjecture de géométrie vieille de 31 ans.
Le protocole de Harvard
Les rapports humains proviennent de rapidPeer, créé par l’institut de Harvard puis étendu à plusieurs autres institutions : ce service offre aux enseignants-chercheurs une relecture en double aveugle de leurs manuscrits avant l’envoi à une revue. Les relecteurs, choisis par des spécialistes du domaine dans d’autres établissements, doivent rédiger au moins une page et demie à deux pages et sont, selon les auteurs, « bien » payés. Sur les 74 auteurs qui ont répondu à l’enquête, 88 % ont jugé leur rapport de qualité élevée ou très élevée. Le corpus réunit toutes les soumissions éligibles : 124 articles et 134 rapports humains reçus entre 2019 et 2026.
Claude Opus 4.8, réglé sur son niveau de raisonnement maximal, a rédigé pour chaque article un rapport dans deux conditions. Dans la version « appariée », il recevait le manuscrit et les consignes données aux relecteurs humains, sans aucun outil. Dans la version « optimisée », il disposait d’une consigne conçue pour un agent et de la recherche web, utilisée en moyenne 12,4 fois par rapport. Selon les auteurs, cette consigne a été écrite avant tout jugement et jamais ajustée aux notes des juges.
GPT-5.5 a jugé chaque paire deux fois, dans les deux ordres de présentation, et une victoire ne comptait que si le même rapport l’emportait les deux fois. Munis des mêmes consignes, les trois éditeurs étaient d’accord entre eux dans 80 % des cas, et avec le juge automatique dans 87 % des cas en moyenne.
Les contrôles derrière les chiffres
Pour vérifier que l’IA ne gagnait pas en écrivant plus long, les auteurs n’ont gardé que les 44 paires de rapports de longueur comparable : l’IA les a toutes remportées. L’avance de l’IA est la même pour les articles soumis en 2025 et 2026 que pour ceux de 2022 ou avant, ce qui indique que son avantage ne vient pas de travaux postérieurs qu’elle aurait pu lire pendant son entraînement.
Dans le test principal, l’IA remporte entre 92 % et 100 % des paires départagées dans chacun des sept domaines évalués, de la méthode aux figures et tableaux. Les sources sont le seul domaine où la version appariée, privée d’accès au web, n’a gagné que 62 % des paires ; avec la navigation, elle les a toutes gagnées. Dans une réplication avec d’autres consignes et une autre grille, où rapports d’IA et jugements venaient de Claude Opus et de GPT, l’IA l’a emporté dans 97,1 % des cas avec le juge Opus et 94,2 % avec le juge GPT, sur 416 comparaisons.
Le juge lui-même a été testé sur des copies de chaque rapport où l’on avait glissé une phrase exacte ou une phrase contraire au manuscrit : il a signalé les 258 phrases fausses et n’a signalé aucune des 258 phrases exactes. Ces modèles servent aussi à revérifier des travaux déjà publiés : le 16 octobre, un physicien a publié son calcul de thèse refait avec Claude, qui a révélé une erreur de signe dans un résultat paru en 2007.
22 977 rapports d’IA en moins de 24 heures
À AAAI-26, chacun des 22 977 articles envoyés en évaluation complète a reçu un rapport d’IA clairement identifié. L’ensemble a été produit en moins de 24 heures, pour moins d’un dollar par article, payé avec des crédits d’API offerts par OpenAI, sponsor de la conférence.
Conçu par l’équipe du pilote, ce système reposait sur un modèle d’OpenAI. Ses rapports s’ajoutaient à au moins deux rapports humains par article, sans note ni recommandation, et n’ont remplacé aucun relecteur. Dans une enquête comptant 5 834 réponses, les participants les ont préférés sur six critères sur neuf, dont la détection d’erreurs techniques.
Beaucoup de relecteurs utilisent déjà ces outils, parfois contre les règles. À ICML 2026, où une partie des relecteurs, tirée au sort, n’avait pas le droit d’utiliser de modèle de langage, 22,5 % des sondés soumis à cette interdiction ont déclaré en avoir utilisé un malgré tout. Plus de la moitié des quelque 1 600 universitaires interrogés par l’éditeur Frontiers avaient déjà utilisé l’IA pour évaluer un manuscrit, rapportait Nature en décembre 2025.
Les limites reconnues
Les auteurs indiquent leur principale limite : ils n’ont mesuré ni l’amélioration des articles après révision ni les effets collectifs d’un passage à la relecture par l’IA. Selon l’article, ces résultats concernent l’aide qu’un rapport apporte aux auteurs et laissent de côté la manière dont les éditeurs devraient choisir ce qu’ils publient. Le contrôle humain repose sur trois éditeurs et dix articles.
King et Worthington préviennent aussi que l’IA tend à pousser la recherche vers « le conventionnel, l’orthodoxe et le majoritaire » et que ses rapports pourraient uniformiser la science. Les comparaisons antérieures citées par les auteurs se contredisent : sur 119 articles de BMJ Open, les rapports humains soulevaient des points plus détaillés et plus variés que ceux de ChatGPT, mais deux éditeurs d’une revue de cardiologie ont mieux noté les rapports d’IA sur cinq critères sur sept, pour 40 manuscrits.
Un texte de position de Joachim Baumann, Jiaxin Pei, Sanmi Koyejo et Dirk Hovy, retenu pour une présentation orale à ICML 2026, soutient que les systèmes d’IA actuels ne devraient pas servir à produire des rapports de relecture. Sur des rapports d’ICLR 2026, ses auteurs observent un « effet de pensée unique », un excès d’accord, et montrent qu’un « blanchiment d’articles », la réécriture d’un article par un modèle de langage, peut faire monter ses notes auprès des relecteurs artificiels. Les participants à l’enquête AAAI jugeaient aussi les rapports d’IA plus enclins à grossir des points mineurs.
Notre analyse
L’IA a accéléré l’écriture scientifique bien plus que sa relecture : articles et demandes de financement s’écrivent plus vite, alors qu’un verdict de revue se fait toujours attendre des mois. Cette étude s’appuie sur des rapports humains choisis pour leur qualité, et le modèle l’emporte sur toutes les mesures construites par les auteurs, avec environ trois fois moins d’affirmations inexactes.
Les pistes des auteurs laissent la main à l’éditeur : une revue pourrait publier une consigne officielle de relecture par l’IA, demander aux auteurs de joindre un rapport d’IA accompagné d’une lettre de réponse, et soumettre de son côté l’article à une seconde consigne non divulguée, avec des tests contre la manipulation. Selon eux, une version de ces idées permettrait des décisions de publication « en quelques jours plutôt qu’en quelques mois », mais seul un éditeur humain peut décider si un article correct répond aux exigences d’une revue.
La première épreuve sera une réplication dans d’autres domaines de recherche, que les auteurs demandent eux-mêmes, avec davantage de juges humains. La deuxième sera de montrer que les articles révisés à partir de rapports d’IA s’améliorent, ce que l’étude n’a pas mesuré. La troisième tient à la manipulation. King et Worthington relèvent que des auteurs qui révisent leur texte pour une consigne publiée risquent de finir par optimiser pour elle, et Baumann et ses coauteurs ont montré qu’une simple réécriture par un modèle de langage peut faire monter les notes des relecteurs artificiels.
Sources
- AI Article Reviews Dominate Human Peer Reviews at Their Best: Evidence and Policy Choices, Gary King et Steven Worthington, Harvard IQSS, 22 octobre 2026
- AI-Assisted Peer Review at Scale: The AAAI-26 AI Review Pilot, J. Biswas et al., arXiv, 15 avril 2026
- Use and Effects of LLMs in Peer Review: A Randomized Experiment and Survey at ICML 2026, S. S. Y. Kim et al., arXiv, 16 septembre 2026
- Stop Automating Peer Review Without Rigorous Evaluation, J. Baumann, J. Pei, S. Koyejo et D. Hovy, arXiv (ICML 2026), 4 mai 2026, révisé le 5 juillet
- Could AI help scientists with their paperwork, The Economist, Off the Charts, 23 octobre 2026
- More than half of researchers now use AI for peer review, often against guidance, Miryam Naddaf, Nature, 15 décembre 2025
- Introducing Claude Opus 4.8, Anthropic, 28 mai 2026
Image d’en-tête : graphique MACCUS, données King et Worthington, document de travail de Harvard IQSS (22 octobre 2026)