Claude Sonnet 5, qu’Anthropic a lancé le 30 juin 2026, a réussi 4 des 70 tâches de Terminal-Bench-Science lors des tests de Vals AI. Claude Sonnet 5.5, sorti le 28 septembre au même tarif par token, en a réussi 33. Chaque tâche est un travail de recherche rédigé par un scientifique en activité et corrigé par des tests écrits par ce même scientifique. Vals a actualisé ces résultats le 14 octobre, puis intégré ce banc d’essai le 16 octobre dans un nouvel indice composite, le Vals Science Index.
Les modèles d’OpenAI et de Google font le même bond. Chez OpenAI, la gamme Sol passe de 14 tâches avec GPT-5.6 Sol, ouvert au public en juillet, à 37 avec GPT-6.1 Sol, sorti le 29 septembre. Chez Google, la préversion de février de Gemini 3.1 Pro réussissait une tâche, et Gemini 4 Argon en réussit 31.
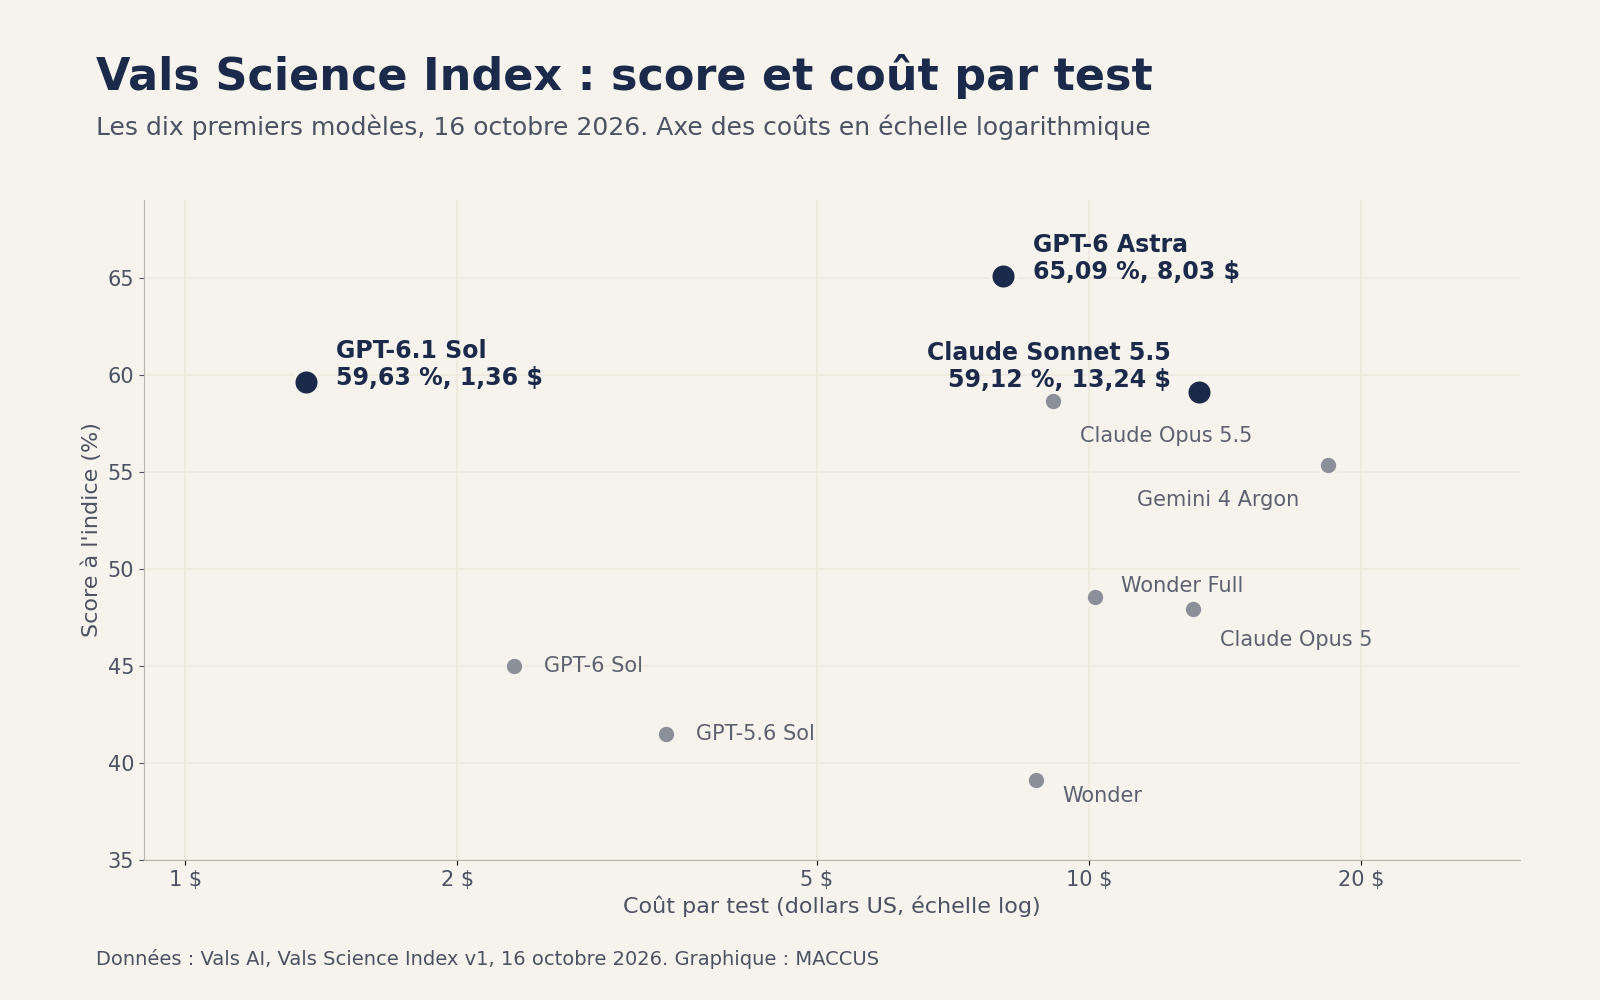
Sur le nouvel indice, GPT-6.1 Sol obtient 59,63 % pour 1,36 dollar par test, soit environ 1,21 euro (taux BCE du 16 octobre). Claude Sonnet 5.5 obtient 59,12 %, un demi-point de moins, pour 13,24 dollars (environ 11,77 euros).
Un indice construit sur trois bancs d’essai
Vals est une société indépendante d’évaluation des modèles d’IA. Son indice fait la moyenne simple de trois bancs d’essai « agentiques » : chacun fournit au modèle un jeu de données, un laboratoire simulé ou un terminal, et le note sur ce qu’il trouve.
BioMysteryBench, conçu par Anthropic et présenté en avril, pose 99 questions de bio-informatique sur des données réelles. Jusqu’à cinq experts du domaine ont tenté chaque question, et les 23 qu’aucun d’eux n’a résolues forment un lot dit « difficile pour les humains ».
MysteryMechanism, créé par Vals, cache 222 lois mathématiques tirées de la biologie, de la physique, de la chimie, de l’ingénierie, de l’écologie et de systèmes dynamiques abstraits. L’agent dispose de deux observations bruitées et d’un petit budget d’expériences, sans accès à internet ni indication sur le domaine, et doit rendre une loi exécutable.
Terminal-Bench-Science, de Steven Dillmann et de l’équipe Terminal Bench, accorde à l’agent jusqu’à huit heures par tâche, le double de la limite de quatre heures de BioMysteryBench. Ses 70 tâches se répartissent entre sciences de la vie (19), sciences physiques (17), mathématiques (17), ingénierie (9) et sciences de la Terre (8). Les tests de correction tournent dans un bac à sable hors de portée de l’agent. Aucun point partiel n’est accordé car, selon Vals, « un résultat de recherche presque juste est inutilisable ».
Quatre gammes de modèles, avant et après
Sur Terminal-Bench-Science, Vals note chaque modèle sur une seule passe, avec le même agent générique, mini-swe-agent. Le tableau compare le dernier modèle de chaque gamme à un modèle antérieur.
| Modèle précédent | Dernier modèle | Tâches réussies (sur 70) |
|---|---|---|
| Claude Sonnet 5 (30 juin) | Claude Sonnet 5.5 (28 septembre) | de 4 à 33 |
| Claude Opus 5 (24 juillet) | Claude Opus 5.5 (22 septembre) | de 19 à 33 |
| GPT-5.6 Sol (juillet) | GPT-6.1 Sol (29 septembre) | de 14 à 37 |
| Gemini 3.1 Pro Preview (19 février) | Gemini 4 Argon (30 septembre) | de 1 à 31 |
Chez Anthropic, Sonnet et Opus finissent à égalité, à 33 tâches ; notre guide des modèles Claude détaille ce qui les distingue. Le modèle intermédiaire d’OpenAI, GPT-6 Sol, en réussit 21. En tête, GPT-6 Astra, le modèle phare d’OpenAI, réussit 44 tâches, soit 62,86 %.
Sur leurs propres protocoles, les laboratoires mesurent le même bond, avec des scores plus élevés, comme Vals s’y attend. Dans l’annonce de Claude Opus 5.5, Anthropic donne 58,7 % sur Terminal-Bench-Science 0.1, contre 29,0 % pour Opus 5. L’erreur type est de 3,5 à 5 points par modèle.
OpenAI écrit que GPT-6.1 Sol « fait plus que doubler le score de GPT-6 Sol » avec un effort de raisonnement maximal, et que GPT-6 Astra reste en tête des modèles testés par OpenAI, avec 68,1 %. Ces chiffres d’éditeurs ne se comparent pas ligne à ligne avec ceux de Vals.
Le coût par test
Claude Sonnet 5 et Sonnet 5.5 ont le même prix catalogue, 2 dollars par million de tokens en entrée et 10 dollars en sortie. Sur Terminal-Bench-Science, Vals a mesuré pour les deux un coût par test presque identique, 30,30 et 32,52 dollars : le score a été multiplié par huit à coût à peu près constant. La gamme Sol d’OpenAI devient moins chère en progressant, de 7,32 dollars par test pour GPT-5.6 Sol à 3,44 pour GPT-6.1 Sol. Chez Google, le coût évolue en sens inverse, de 5,91 dollars par test pour la préversion de février à 44,90 dollars pour Gemini 4 Argon, le plus cher des quatre derniers modèles.
GPT-6.1 Sol et Claude Sonnet 5.5 ont eux aussi le même prix catalogue, mais sur l’indice, Sonnet 5.5 coûte environ dix fois plus cher par test. Il a consommé au total 20,05 milliards de tokens en entrée, contre 757 millions pour GPT-6.1 Sol. Les chiffres d’OpenAI sur Terminal-Bench-Science 0.1, à effort maximal, vont dans le même sens. Ils donnent 5,47 dollars par tâche pour GPT-6.1 Sol, contre 23,21 pour Opus 5.5 et 23,80 pour GPT-6 Astra.
Epoch AI a étudié l’ensemble du secteur dans une analyse publiée le 22 septembre. Dans « The plunging price of thought », Luke Emberson et David Roodman estiment que le coût d’un niveau de performance donné a baissé d’environ 47 % par trimestre depuis 2023, soit une division par 13 chaque année. Selon leur calcul, aucune des technologies comparées n’a vu ses coûts baisser aussi vite : le séquençage de l’ADN quatre fois moins vite, le prix de l’électricité 54 fois moins vite au cours du siècle qui a précédé 1973.
Pour une performance qui vient d’atteindre l’état de l’art, la baisse atteint 66 % par trimestre. L’estimation, une moyenne de cinq bancs d’essai (mathématiques, sciences dures, jeux de réflexion) sur de nombreux modèles, ne peut pas se lire comme la courbe de prix d’un modèle cité ici.
Les limites de la mesure
Les scores de Terminal-Bench-Science mesurés par Vals proviennent tous d’une seule passe par modèle ; BioMysteryBench, qui pèse un tiers de l’indice, fait la moyenne de trois passes. Sur 70 tâches, une tâche de plus ou de moins déplace le score de 1,43 point. Sur l’indice, Vals affiche une marge d’environ 2,3 points sur chacun des premiers scores, si bien que GPT-6.1 Sol et Claude Sonnet 5.5, séparés d’un demi-point, sont statistiquement à égalité.
Vals a relancé les tâches interrompues par une panne d’infrastructure et précise que quelques-unes ont alors été réussies. Le classement passe aussi de l’agent Terminus 2 à mini-swe-agent, et Vals s’attend à ce que les agents optimisés par les éditeurs fassent mieux que son agent générique.
Les refus comptent comme des échecs : sur BioMysteryBench, les filtres de contenu biologique ont bloqué certaines tâches pour plusieurs modèles, et Claude Sonnet 5.5 a refusé les trois mêmes tâches lors de chacune de ses trois passes. Anthropic a aussi constaté en avril que beaucoup de succès sur les questions difficiles pour les humains se reproduisent mal. Pour Claude Opus 4.6, 44 % des problèmes difficiles résolus ne l’ont été qu’une ou deux fois sur cinq essais, contre 9 % pour les questions que les experts savaient résoudre. Selon Anthropic, ces succès relèvent souvent de « chemins de raisonnement chanceux » plutôt que de solutions reproductibles de façon fiable.
Ces tâches couvrent un type de travail précis : un problème bien posé dont un programme peut vérifier la réponse. L’annonce de Vals présente l’indice comme une mesure de la capacité de l’IA à faire des découvertes scientifiques, alors qu’il note si le résultat d’un agent passe un contrôle automatique. Le choix de la question à poser échappe au test. Sur la partie testée, le premier du classement, GPT-6 Astra, échoue encore sur plus d’un tiers de l’indice. Le jour de la sortie de l’indice, le 16 octobre, le physicien Emre Onur Kahya publiait un audit, mené avec Claude, de son propre calcul de gravité quantique de 2007, qui y a trouvé une erreur de signe (voir notre article sur cet audit).
Notre analyse
Sur Terminal-Bench-Science, les quatre gammes de modèles des trois laboratoires réussissaient entre 1 et 19 tâches avec leur modèle antérieur, et leur dernière sortie en réussit entre 31 et 37, près de la moitié des 70. Le coût n’a pas évolué aussi uniformément que les scores. GPT-6.1 Sol, deuxième de l’indice, coûte environ dix fois moins par test que Claude Sonnet 5.5, troisième, alors que Gemini 4 Argon coûte plus cher par test que la préversion de février.
Pour les équipes de recherche, ces tâches correspondent à des étapes comme reconstituer un signal, calibrer un modèle, réduire les données d’un instrument ou démontrer une borne, les exemples donnés par Vals. Les cinq premiers modèles de Terminal-Bench-Science en réussissent désormais entre 44 % et 63 %, et GPT-6.1 Sol le fait pour 3,44 dollars par test dans la mesure de Vals.
Le même schéma ressortait de nos articles sur les contre-exemples à une conjecture de fusion de 1967 trouvés par des IA et sur les circuits quantiques conçus par Claude : l’IA progresse le plus vite là où un ordinateur peut vérifier le résultat. Les trois bancs d’essai de l’indice sont notés automatiquement, par les tests des auteurs des tâches, par des sondes cachées ou, sur BioMysteryBench, par un juge IA.
Les prochains chiffres à suivre viendront du classement officiel de Terminal-Bench-Science, qui fait la moyenne de trois essais par tâche et associe chaque modèle à l’agent de son éditeur, et des mesures de Vals sur la génération suivante. Sur BioMysteryBench, reste à savoir si un modèle résoudra les questions difficiles pour les humains lors de la plupart de ses essais.
Sources
- Vals Science Index Leaderboard and Methodology, Vals AI, 16 octobre 2026
- Terminal-Bench-Science Leaderboard and Methodology, Vals AI, 14 octobre 2026
- BioMysteryBench Leaderboard and Methodology, Vals AI, 12 octobre 2026
- Evaluating Claude with BioMysteryBench, Anthropic, 29 avril 2026
- Introducing Claude Sonnet 5, Anthropic, 30 juin 2026
- Introducing Claude Sonnet 5.5, Anthropic, 28 septembre 2026
- Introducing Claude Opus 5.5, Anthropic, 22 septembre 2026
- The plunging price of thought, Epoch AI, 22 septembre 2026
Image d’en-tête : graphique MACCUS, données Vals AI (classement Terminal-Bench-Science, 14 octobre 2026)