Le 12 novembre 2026, l’équipe d’IBM chargée des modèles d’IA Granite a publié deux préversions entraînées à ignorer les ordres cachés dans les documents qu’elles lisent. Cette attaque, l’injection de prompt indirecte, sert à détourner un assistant d’IA. Les deux modèles reposent sur LLMON, un balisage d’IBM qui sépare la consigne de l’utilisateur du contenu à traiter.
Baptisés granite-4.1-3b-llmon-preview et granite-4.1-8b-llmon-preview, les deux modèles comptent 3,7 et 8,8 milliards de paramètres, les valeurs apprises dont le nombre donne la taille d’un modèle. IBM les annonce à 3 et 8 milliards. Ils sont téléchargeables librement sur Hugging Face, plateforme de partage de modèles d’IA, sous licence Apache 2.0, qui autorise l’usage commercial. Leur taille permet en principe de les faire tourner sur les machines d’une entreprise, sans service en ligne.
IBM les a testés sur un banc d’essai public, une série d’attaques standard. Celles-ci réussissaient dans 96 à 100 % des cas contre les versions classiques de Granite 4.1, et dans 0,1 % au plus contre les préversions. IBM les réserve pourtant à l’exploration et à l’évaluation, et les déconseille pour un usage réel. Selon IBM, leur résistance reste un comportement appris que rien ne garantit.
L’injection de prompt indirecte, le risque visé
Le prompt est la consigne donnée à un modèle d’IA. L’injection indirecte en cache une autre dans un contenu que le modèle va lire : page web, courriel, PDF ou réponse d’un outil (un logiciel qu’il interroge). Le modèle peut alors l’exécuter comme un ordre de son utilisateur, par exemple divulguer des données ou abandonner sa tâche.
L’OWASP, fondation qui publie des référentiels de sécurité informatique, place l’injection de prompt en tête des dix principaux risques des applications d’IA générative (édition 2025). Selon elle, la gravité d’une attaque dépend du contexte et de l’autonomie laissée au modèle. Le risque est donc plus grand pour les agents, ces assistants qui enchaînent des actions et lisent eux-mêmes pages web, courriels ou fichiers d’un ordinateur.
Selon IBM, le problème tient à la forme de la requête envoyée au modèle. C’est un seul flux de texte, où consigne, document et résultat d’outil se suivent sans frontière nette. Les formats courants comme JSON, qui range les données en champs entre guillemets, ont été conçus pour des programmes. Pour le modèle, le guillemet d’un document et celui qui ferme un champ sont le même signe.
Un balisage impossible à contrefaire
LLMON, pour « LLM Object Notation » (LLM désigne les grands modèles de langage), transforme chaque morceau de la requête en bloc étiqueté : instruction, données, exigence, document, définition d’outil, réponse. Les balises utilisent six délimiteurs réservés, que le modèle lit comme des mots à part et qu’aucun texte ordinaire ne peut reproduire.
Un bloc final, appelé « exec », indique quelle instruction exécuter, sur quelles données, avec quelles contraintes, et où écrire la réponse. Un bloc que l’exec ne désigne pas reste visible pour le modèle, mais rien ne l’appelle.
La fiche du modèle sur Hugging Face résume la règle apprise : l’instruction et la consigne système (les règles de l’application) désignées par l’exec font autorité. Documents, données et résultats d’outils sont du contenu à lire, que le modèle ne doit pas traiter comme des ordres, « quelle que soit sa formulation ».
Un gabarit de conversation livré avec les modèles met les messages en forme et produit ce balisage. Le développeur nomme les parties d’un message et indique celles à exécuter. IBM publie aussi sur GitHub, plateforme d’hébergement de code, des outils de conversion du JSON en LLMON et des exemples, sous licence Apache 2.0.
Dès le soir du 12 novembre, un compte extérieur à IBM a publié sur Hugging Face des copies du modèle de 8 milliards aux formats ONNX et GGUF. GGUF est le format de llama.cpp et d’Ollama, deux logiciels qui font tourner un modèle sur son propre ordinateur ; ONNX, un standard d’échange de modèles. La page de la copie GGUF affiche le gabarit LLMON d’IBM parmi les métadonnées des fichiers. IBM ne documente pas ces usages : sa documentation s’appuie sur Transformers, la bibliothèque logicielle de Hugging Face.
Des pièges glissés dans l’entraînement
IBM est parti des versions de base de Granite 4.1, avant tout réglage pour la conversation. Le corpus d’entraînement compte 4,6 milliards de jetons (tokens), les fragments de texte que lit un modèle. Il mêle conversation générale, réponses fondées sur des documents et appels d’outils.
Une partie des exemples contient jusqu’à trois instructions concurrentes et des données hors sujet, présentes dans la requête mais jamais désignées par l’exec. Le corpus compte aussi 130 000 exemples d’injection, où une instruction malveillante est cachée dans un contenu à lire.
Ont suivi cinq étapes d’apprentissage par renforcement, une méthode qui récompense le modèle quand il répond bien. Une dernière étape lui a appris à préférer la bonne réponse dans environ 1 000 paires de réponses à des tentatives d’injection. Deux articles de chercheurs d’IBM, sur le site de prépublications arXiv, décrivent le format (23 mars 2026) et l’entraînement (28 octobre 2026).
Les chiffres publiés par IBM
IBM mesure la part d’attaques réussies sur deux bancs d’essai publics, face aux versions classiques de Granite 4.1, réglées pour la conversation. OPI cache l’ordre dans le texte à traiter lors de tâches linguistiques classiques. ASB le place dans la réponse d’un outil reçue par un agent : selon l’article d’IBM, c’est le point d’entrée qui compte pour les applications dotées d’outils.
Sur OPI, le taux d’attaques réussies tombe de 100 % à 0,1 % pour le modèle de 3 milliards, et de 96,3 % à 0,02 % pour celui de 8 milliards. Sur ASB, il passe de 99,2 % à 5,6 % pour le premier, et de 52,8 % à 3,1 % pour le second.
Le billet de blog d’IBM compare aussi les préversions à d’autres modèles, sur 9 000 attaques d’OPI. Elles en repoussent presque toutes, soit 47 points de pourcentage de plus que GPT-6 Astra d’OpenAI, le meilleur des modèles de pointe testés. Claude Opus 5.5, d’Anthropic, arrive loin derrière GPT-6 Astra. L’écart atteint 95 points avec le Granite 4.1 classique de 8 milliards, meilleur modèle ouvert du graphique, devant les modèles Gemma 4 de Google et Qwen d’Alibaba.
Les capacités générales bougent peu. L’article de recherche fait la moyenne de six familles de tests : connaissances et raisonnement, suivi d’instructions, mathématiques, code, appels d’outils et langues. Le modèle de 3 milliards garde son score, 66,7 sur 100, et celui de 8 milliards perd 1,4 point, de 74,2 à 72,8. Les mathématiques reculent le plus : pour le modèle de 8 milliards, la moyenne de quatre tests passe de 84,1 à 79,6.
Les limites reconnues par IBM
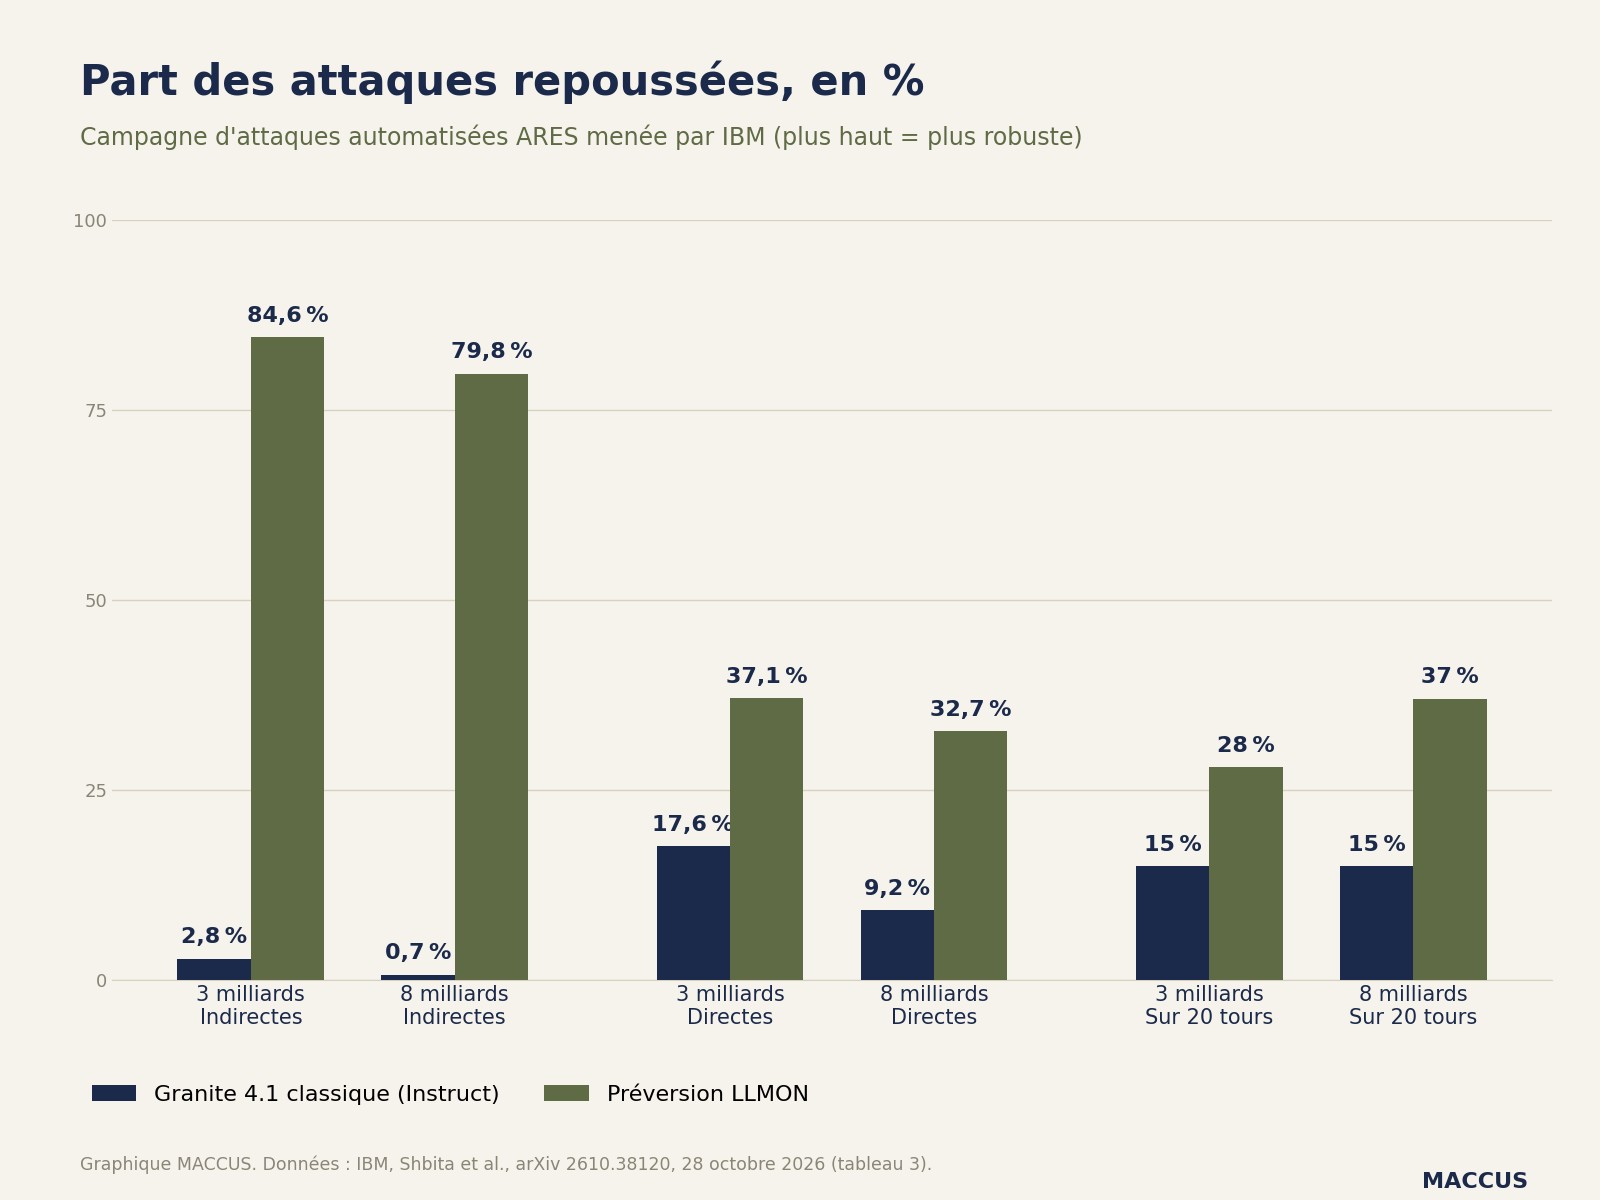
Lors d’attaques automatisées menées par IBM avec l’outil ARES, le modèle de 3 milliards repousse 84,6 % des attaques indirectes, contre 2,8 % pour sa version classique. Celui de 8 milliards en repousse 79,8 %, contre 0,7 %.
Les attaques directes, où l’utilisateur lui-même donne l’ordre malveillant, et celles étalées sur une conversation de 20 tours au plus réussissent bien plus souvent. Les préversions n’en repoussent que 28 % à 37 %, contre 9 % à 18 % pour les modèles classiques. Selon IBM, quand l’ordre vient de l’utilisateur, il n’y a plus de frontière à faire respecter entre consigne et données.
Selon l’article de recherche, les tests portent sur une seule famille de modèles et deux tailles. Les balises allongent les requêtes d’environ 7 à 15 %, et IBM n’a pas mesuré de façon systématique l’effet sur la vitesse. Le français figure parmi les douze langues prises en charge, mais le corpus LLMON est surtout en anglais.
Selon la fiche du modèle, une requête au format de conversation habituel, sans LLMON, sort de ce que le modèle a appris et dégrade ses réponses. La fiche demande de ne pas faire de cette protection la seule défense d’un agent qui accède à des systèmes sensibles. IBM dit travailler à mieux résister aux attaques qui s’adaptent au fil des échanges.
À notre connaissance, aucune reproduction indépendante des tests d’IBM n’avait été publiée au 14 novembre.
Notre analyse
Selon l’article d’IBM, certaines défenses existantes, comme la méthode Spotlighting, marquent les contenus douteux par des délimiteurs écrits dans le texte. D’autres, comme StruQ et SecAlign, entraînent le modèle sur des requêtes structurées.
IBM dit s’en distinguer de deux façons. Ses délimiteurs viennent d’une zone réservée du vocabulaire du modèle, qu’aucun texte ordinaire ne peut former. Seul le bloc exec donne autorité à une consigne.
Les premiers concernés sont les équipes qui confient à un petit modèle local des contenus extérieurs : tri de courriels, questions sur des documents, agents qui appellent des outils. La question se pose aussi pour des agents encore plus petits, conçus pour un téléphone. C’est le cas de BotPsy, publié par la société Tether le 11 novembre, qui agit sur la messagerie et l’agenda.
La protection suppose toutefois que l’application passe par le gabarit fourni et range les contenus extérieurs dans des champs à part. Le gabarit classe d’office la réponse d’un outil parmi les données. Un document collé dans le message de l’utilisateur est, lui, lu comme une consigne.
La baisse des attaques indirectes réussies est nette sur les bancs d’essai publics. Elle reste à vérifier face à des attaques qui s’adaptent, sur des documents en d’autres langues que l’anglais et par des équipes extérieures à IBM. Restent à suivre la prise en charge du format par les logiciels locaux comme llama.cpp et Ollama, une version stable des modèles et l’adoption éventuelle de LLMON par d’autres concepteurs.
Sources
- LLMON: An LLM-Native Markup Language, now in Granite 4.1 3B and 8B, IBM Granite, Hugging Face, 12 novembre 2026
- ibm-granite/granite-4.1-8b-llmon-preview, fiche du modèle, IBM, Hugging Face, 12 novembre 2026
- Post-Training Large Language Models with LLMON, Basel Shbita et al. (IBM), arXiv, 28 octobre 2026
- LLMON: An LLM-native Markup Language to Leverage Structure and Semantics at the LLM Interface, Michael Hind et al. (IBM), arXiv, 23 mars 2026
- generative-computing/llmon, IBM, GitHub, consulté le 14 novembre 2026
- LLM01:2025 Prompt Injection, OWASP Gen AI Security Project, consulté le 14 novembre 2026
- liodon-ai/granite-4.1-8b-llmon-preview-GGUF, Hugging Face, 12 novembre 2026
Image d’en-tête : graphique MACCUS, données d’IBM, Shbita et al., arXiv 2610.38120, 28 octobre 2026 (tableau 2)