
Anthropic, l’entreprise qui développe l’assistant Claude, a publié le 6 novembre 2026 un billet de son équipe d’ingénierie sur la mémoire des agents Claude. Ces programmes d’IA mènent seuls une tâche en plusieurs étapes et gardent des notes d’une session de travail à l’autre. Le billet décrit aussi le « dreaming » (« rêver ») : entre deux sessions, Claude relit ses échanges passés pour corriger et réorganiser ces notes.
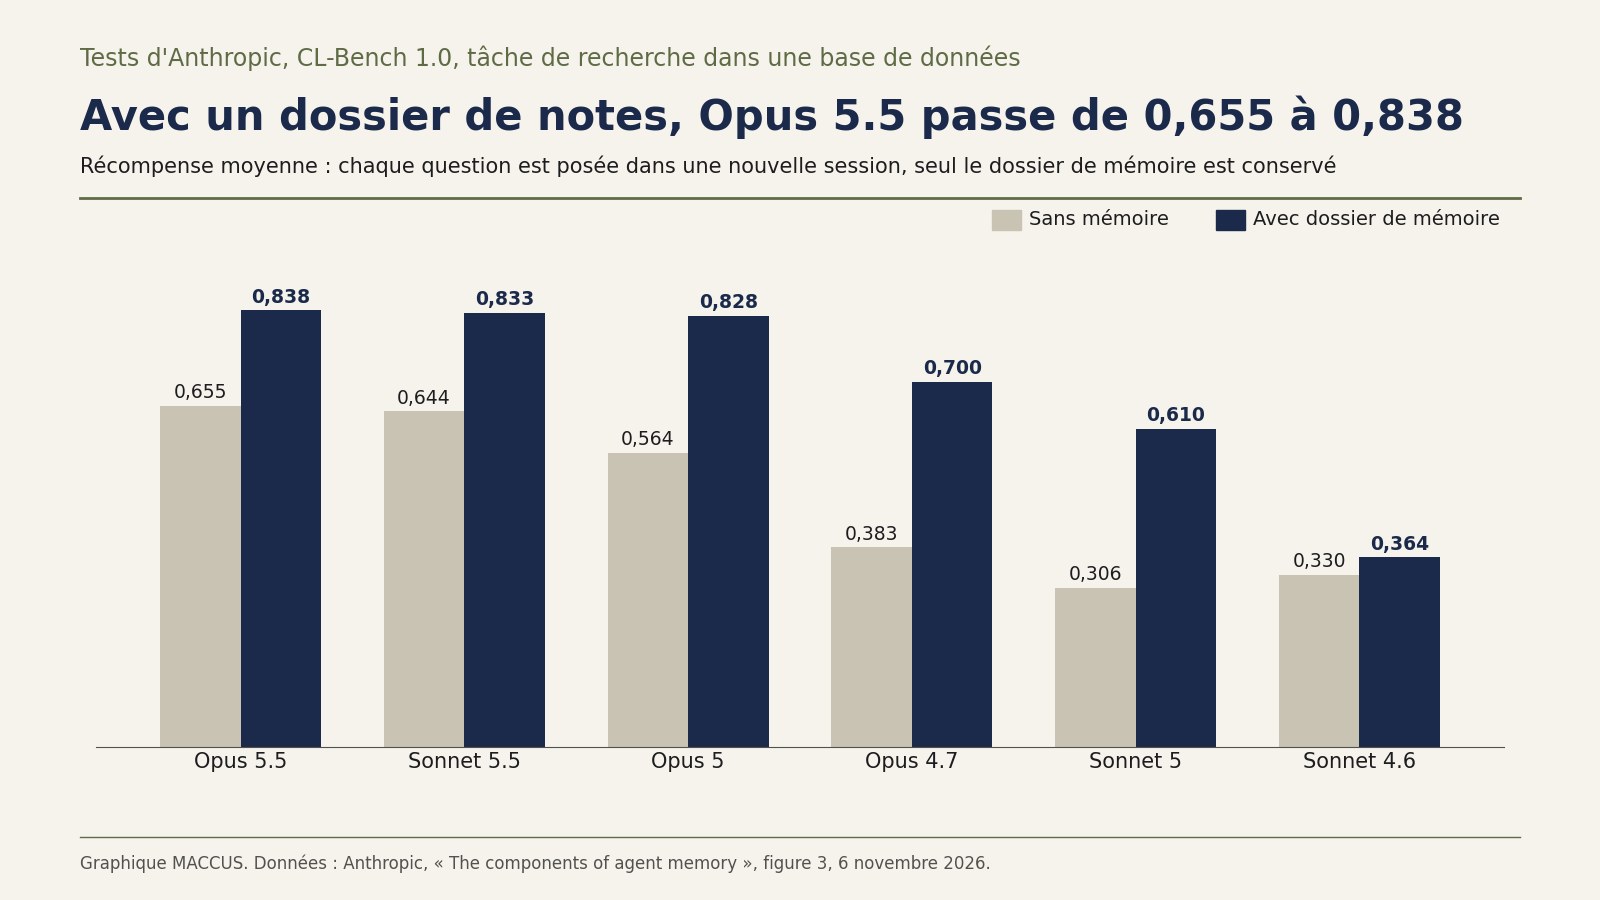
Le billet, qui n’annonce ni nouvelle fonction ni prix, s’appuie sur des tests internes. Sur une tâche de recherche dans une base de données, le score moyen du modèle d’IA Opus 5.5 passe de 0,655 sans notes à 0,838 avec un dossier de notes. Un wiki bâti par « dreaming » fait passer un autre score de 13 % après 2 sessions à 48 % après 128, mais cette méthode n’aide pas toujours.
Signé Lance Martin, ce billet s’intitule « The components of agent memory » (« Les composantes de la mémoire des agents »). Il vise les agents construits par les développeurs avec les outils d’Anthropic. La mémoire de l’application Claude, qui retient des faits sur ses utilisateurs, est un autre mécanisme, expliqué dans notre guide sur ce que Claude retient entre deux conversations. Les citations sont nos traductions de l’anglais.
Quatre couches, de l’historique brut aux notes chargées d’office
Pour Anthropic, la mémoire d’un agent est le savoir que Claude tire de l’expérience et conserve d’une session à l’autre, sous forme de texte à relire. L’entraînement, qui modifie le modèle lui-même, n’en fait pas partie.
Cette mémoire compte quatre couches. En bas, les transcriptions : l’historique complet des sessions, où Claude peut chercher. Au-dessus, les notes que Claude écrit pendant le travail. Puis des formes plus élaborées, comme un wiki, un ensemble de pages reliées. En haut, un petit bloc de notes chargé d’office au début de chaque session.
Le « dreaming » part des transcriptions et peut écrire dans les trois couches du dessus. Anthropic reprend une idée proposée en 2025 par des chercheurs de l’entreprise Letta et de l’université de Californie à Berkeley. Elle consiste à utiliser les temps morts entre deux échanges pour réorganiser le contexte dont le modèle dispose déjà. Elle compare ce travail au sommeil, pendant lequel le cerveau rejoue les expériences récentes.
Avec un dossier de notes, les modèles récents répondent mieux
CL-Bench 1.0 est un banc d’essai, une série d’épreuves standard qui mesure comment un agent se sert de sa mémoire sur des tâches longues. Dans l’épreuve retenue, Claude répond à des questions en cherchant dans une base de données. Après chaque réponse, il reçoit la bonne solution et peut écrire une note. Chaque question démarre dans une nouvelle session : seul le dossier de mémoire passe de l’une à l’autre.
Anthropic a mené ce test sur Claude Managed Agents, son service d’agents hébergés pour développeurs. Sonnet, Opus et Fable sont trois gammes de modèles Claude, de la moins à la plus puissante. Les scores sont des notes moyennes qu’Anthropic appelle « récompense » : plus le chiffre est haut, mieux Claude a répondu.
| Modèle | Sans mémoire | Avec dossier de mémoire |
|---|---|---|
| Opus 5.5 | 0,655 | 0,838 |
| Sonnet 5.5 | 0,644 | 0,833 |
| Opus 5 | 0,564 | 0,828 |
| Opus 4.7 | 0,383 | 0,700 |
| Sonnet 5 | 0,306 | 0,610 |
| Sonnet 4.6 | 0,330 | 0,364 |
Selon Anthropic, les modèles se distinguent par leur façon de tenir leurs notes. Sonnet 4.6, qui progresse à peine, accumule des fichiers épars d’hypothèses jamais vérifiées.
Opus 5 est « le premier de ces modèles à boucler la boucle », écrit Anthropic. Il note un échec, teste des hypothèses, puis en tire une règle, en précisant comment il sait qu’elle est juste. Opus 5.5 et Sonnet 5.5 font de même.
Dire à quoi sert la mémoire, sans dicter comment s’en servir
« Il est utile de dire à Claude à quoi sert la mémoire, mais pas comment l’utiliser », résume Anthropic. Sur CL-Bench, l’équipe a seulement signalé à Claude qu’un dossier de mémoire existait. Avec une règle plus stricte, « ne noter que les échecs », Opus 5 perd une grande partie du gain que lui apportait la mémoire : 0,234 point de récompense moyenne. Opus 4.7 en perd 0,150.
Les consignes aident surtout les modèles plus anciens. Sonnet 4.6 ne lisait souvent pas ses notes. Lui demander de les lire avant de répondre, puis de vérifier ses hypothèses, a presque doublé son score sur CL-Bench, de 0,330 à 0,641.
Un autre test, sur le jeu vidéo Pokémon Rouge, mesure ce que Claude juge utile de noter. Vers 10 000 étapes de jeu, l’ancien modèle Sonnet 3.7 avait écrit 413 fichiers, près de 978 000 caractères de notes, pour un seul badge, signe de progression dans le jeu. Au même stade, Fable 5, plus récent, s’en tenait à 10 fichiers et 43 406 caractères, pour quatre badges.
Fable 5 ne notait que ce que l’écran ne montre pas : plans, stratégies, règles vérifiées. Opus 5.5 a terminé le jeu avec un petit dossier de notes, réécrit au fil de la partie.
Le « dreaming » corrige une note fausse dans Pokémon
Une note fausse peut tromper Claude dans les sessions suivantes. Dans le jeu, Claude devait traverser d’ouest en est le mont Sélénite (Mt. Moon en anglais). Le Centre Pokémon qui lui servait de repère se trouve à l’entrée, côté ouest, mais Claude avait noté à tort qu’il était du côté est. Il s’est donc cru sorti, a noté « Mt Moon DONE » (« Mt Moon terminé »), puis est tombé d’un rebord qui l’a renvoyé sur la route d’où il venait.
Anthropic a ensuite lancé une séance de « dreaming » : Claude a comparé la note à l’historique, repéré l’erreur et l’a corrigée. Il est alors retourné dans la montagne et a atteint la ville d’Azuria à la 1 935e action.
Dans la partie restée sans correction, Claude est retombé trois fois, puis a écrit : « Je vais m’arrêter plutôt que de continuer à tourner en rond. » Une réponse automatique l’a relancé, mais il n’a jamais atteint Azuria, pas plus que dans la partie sans mémoire.
Le wiki de Stainless s’améliore au fil des sessions
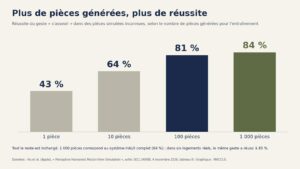
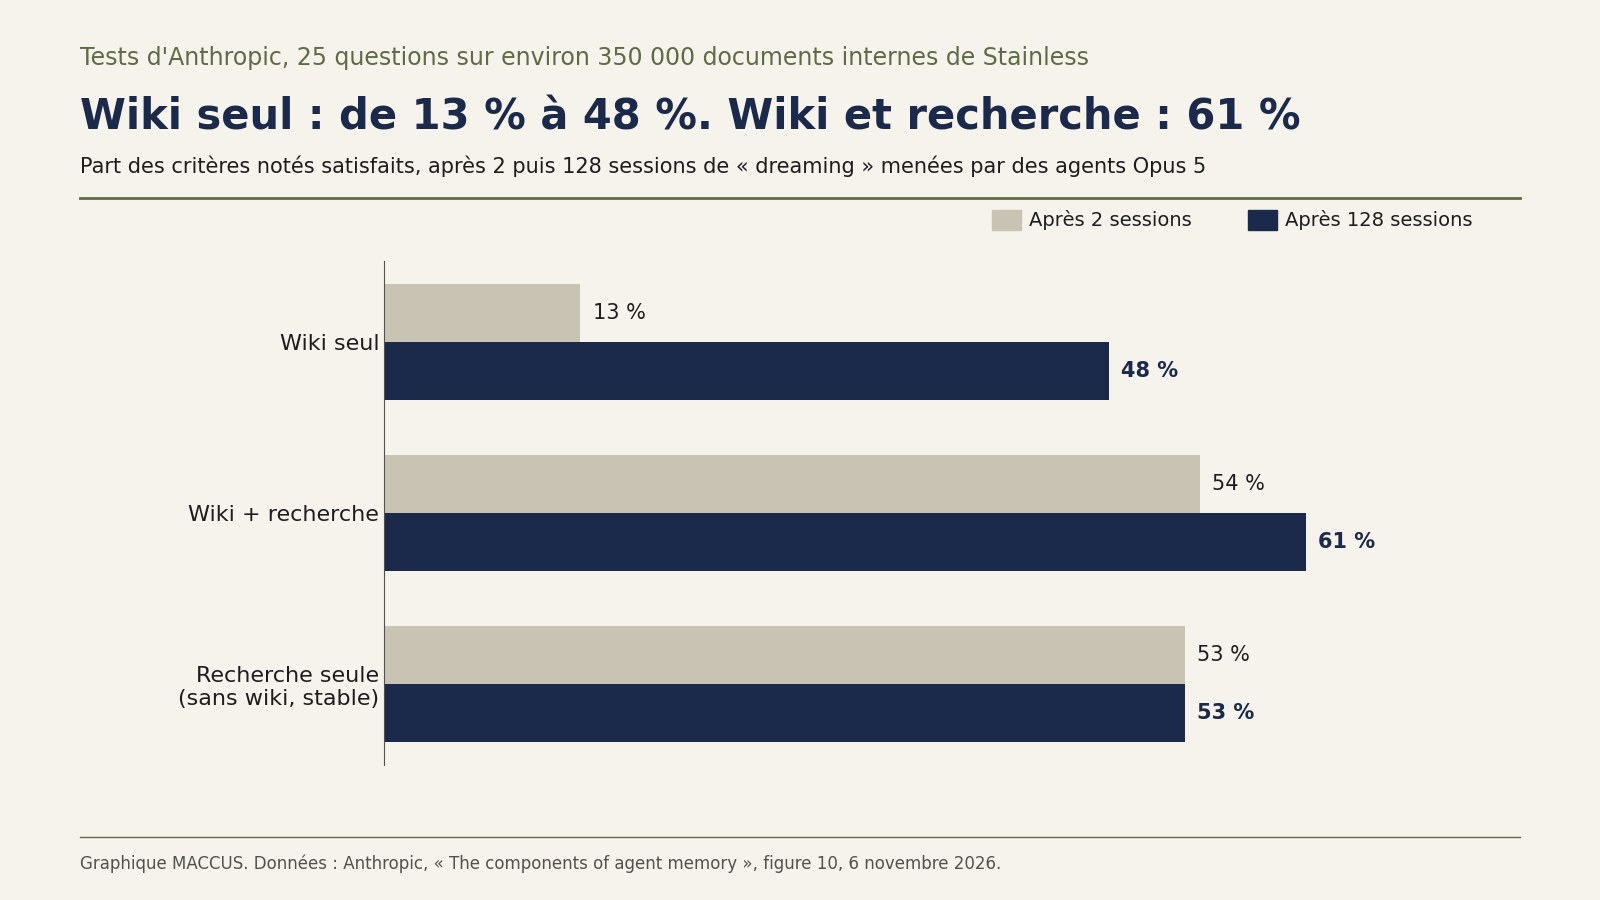
Anthropic a aussi testé le « dreaming » sur environ 350 000 documents internes de Stainless, une société de logiciels qu’elle dit avoir rachetée en mai. Elle a posé 25 questions sur ces documents. Des agents Opus 5 en ont tiré un wiki en 128 sessions, en vérifiant les affirmations dans les sources.
Quand Claude répond avec le wiki seul, la part des critères de notation remplis passe de 13 % après 2 sessions à 48 % après 128. Le meilleur score vient pourtant du wiki associé à un outil de recherche dans les fichiers : de 54 % à 61 %, contre 53 % avec la recherche seule.
Un wiki utile quand les réponses sont dispersées
Anthropic a également posé 24 questions sur les documents d’une fusion d’entreprises. Sur celles qui demandaient de croiser plusieurs documents, Claude a obtenu 87 % avec le wiki, contre 73 % avec la recherche seule.
Le wiki n’aide pas toujours. LAB, un banc d’essai de l’éditeur de logiciels juridiques Harvey, fait rédiger à Claude une synthèse juridique notée sur une liste de critères. Sur une tâche de LAB où la plupart des critères se trouvaient dans un seul document, le wiki n’a apporté aucun gain net.
Sur une autre tâche de LAB, le wiki a fini plus gros que ses sources : 203 kilo-octets (Ko) contre 115 Ko. Anthropic le compare à une nouvelle de l’écrivain argentin Borges, où une carte est aussi grande que l’empire qu’elle représente. Ce wiki, écrit-elle, « en pratique, ne résumait rien ».
Des consignes réécrites et une couche du haut à garder petite
Sur une tâche de LAB consacrée aux contrats d’un rachat, plusieurs agents bâtissaient le wiki en écrivant en même temps dans un tableau commun. Ils effaçaient le travail des autres. La synthèse tirée de ce wiki ne reprenait que 41 des 57 faits attendus (72 %). Claude a ensuite analysé ses échecs et réécrit les consignes de construction : une page par contrat, un seul agent par page, les clauses citées mot pour mot. Résultat : 57 sur 57.
La couche du haut, chargée à chaque session, doit rester petite, insiste Anthropic. Ces notes consomment des tokens, les unités de texte que traite le modèle. Une note fausse passe dans chaque session, et des instructions plus longues sont moins bien suivies. Claude Code, l’assistant de programmation d’Anthropic, ne charge ainsi que les 200 premières lignes ou les 25 premiers Ko de MEMORY.md, l’index de ses notes.
Le billet cite aussi Claude Duet, l’assistant proactif lancé en octobre : sa mémoire gagne souvent à être organisée autour de la personne aidée.
Une fonction encore réservée aux développeurs
Le « dreaming » n’est pas nouveau. Anthropic l’a présenté le 6 mai 2026 à Code with Claude, sa conférence pour développeurs, selon le site spécialisé SiliconANGLE. C’était une fonction de Managed Agents en préversion de recherche, accessible sur demande. La documentation d’Anthropic, consultée le 8 novembre, le présente toujours ainsi.
Une séance de « dreaming » part d’une mémoire existante et de 1 à 100 sessions passées, puis produit une nouvelle mémoire sans toucher à l’originale. Elle dure en général de quelques minutes à quelques heures et se facture au tarif normal des tokens du modèle choisi.
Le « dreaming » n’est proposé ni dans l’application Claude ni dans Claude Cowork, l’outil d’Anthropic qui prend en charge des tâches de bureau.
Des résultats maison, sans vérification extérieure
Tous les chiffres viennent d’Anthropic, sur des documents et des bancs d’essai qu’elle a choisis, sans vérification indépendante. Dans Pokémon, la comparaison repose sur une seule partie par modèle.
Anthropic liste elle-même ses questions ouvertes. Noter en cours de tâche détourne Claude de son travail, et les résultats du « dreaming » arrivent parfois en différé. Le « dreaming » consomme de la puissance de calcul : il faudra peut-être le réserver aux informations susceptibles de changer. Les wikis doivent être entretenus pour ne pas accumuler d’erreurs ou d’inventions.
Sur Hacker News, le forum de l’incubateur Y Combinator, le billet cumulait 159 points le 8 novembre. Un lecteur y estimait, d’après la figure 10 du billet, que le « dreaming » n’ajoutait qu’un gain marginal à la recherche, qu’il supposait bien moins coûteuse. Notre graphique ci-dessus reprend les données de cette figure.
Notre analyse
Le billet concerne d’abord les équipes qui construisent des agents sur Claude, puis les utilisateurs de Claude Code, dont le fichier MEMORY.md suit la même logique. Les modèles les plus puissants travaillent mieux avec une consigne générale, et un wiki aide surtout quand les réponses sont dispersées.
Ces résultats viennent d’une entreprise qui vend Managed Agents et facture le « dreaming » au tarif de ses tokens. Le billet paraît la même semaine que l’audit de METR, un organisme à but non lucratif qui évalue les modèles d’IA. Selon cet audit, Anthropic améliore probablement ses modèles environ deux fois plus vite qu’avant octobre 2025, surtout grâce à Claude.
Plusieurs points restent inconnus : l’arrivée d’un tel mécanisme dans l’application Claude, Cowork ou Duet, et le coût réel d’une séance de « dreaming » sur une grosse mémoire. Le billet ne dit rien non plus de son comportement sur des documents en français. À suivre : la fin de la préversion de recherche et d’éventuels résultats indépendants sur CL-Bench.
Sources
- The components of agent memory, Anthropic, 6 novembre 2026
- Dreams, Claude Platform Docs (Anthropic), consulté le 8 novembre 2026
- How Claude remembers your project, Claude Code Docs (Anthropic), consulté le 8 novembre 2026
- Sleep-time Compute: Beyond Inference Scaling at Test-time, Kevin Lin et al. (Letta, UC Berkeley), arXiv, 17 avril 2025
- Anthropic is letting Claude agents ‘dream’ so they don’t sleep on the job, SiliconANGLE, 6 mai 2026
- The Components of Agent Memory (discussion), Hacker News, 7 novembre 2026
Image d’en-tête : graphique MACCUS. Données : Anthropic, « The components of agent memory », figure 3, 6 novembre 2026