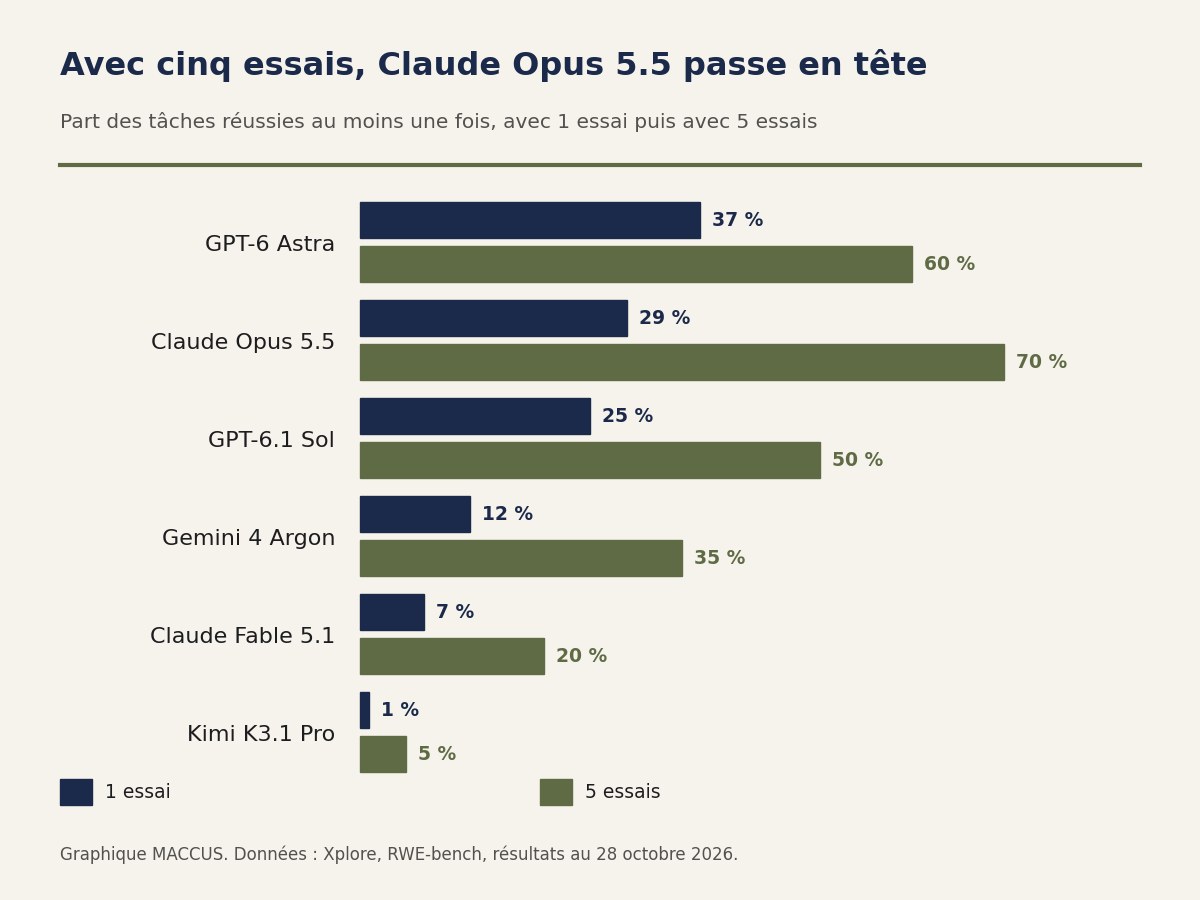
Le 27 octobre 2026, Xplore, une société qui conçoit des environnements d’entraînement pour modèles d’IA, a publié RWE-bench (Real World Engineering Bench). Ce banc d’essai confie à des agents d’IA vingt tâches de conception en génie mécanique, électronique et aérospatial. Un programme contrôle chaque rendu, en faisant tourner des solveurs physiques quand il le faut. Dans le classement daté du 28 octobre, GPT-6 Astra (OpenAI) arrive en tête avec 37 % d’essais réussis, devant Claude Opus 5.5 (Anthropic, 29 %) et GPT-6.1 Sol (OpenAI, 25 %).
Cinq des onze modèles testés n’ont réussi aucun essai. Quatre des vingt tâches ont résisté à tous les modèles, sur près de 1 100 essais. « L’IA n’est pas encore douée pour concevoir des fusées, des moteurs ou des puces », a écrit Xplore sur X en présentant le banc.
Vingt tâches tirées du métier
Le banc compte neuf tâches de génie mécanique, cinq d’électronique et six d’aérospatial. En mécanique, l’agent modélise en CAO des pièces de moteur, des pièces de tôlerie ou des mécanismes imprimés, puis le programme en vérifie la résistance, l’ajustement et la cinématique. En électronique, l’agent route des liaisons rapides (mémoire DDR, PCIe) sur des cartes denses déjà équipées. En aérospatial, il mène des calculs de mécanique des fluides numérique (CFD) et de transfert thermique, du maillage jusqu’à une solution convergée, sur des aubes de turbine, des ailes d’avion ou des tuyères de fusée.
Xplore détaille trois de ces tâches. La première demande de concevoir un vilebrequin monobloc en acier pour un moteur diesel à trois cylindres, avec ses perçages de lubrification. La pièce doit s’adapter aux paliers, au volant moteur et à l’entraînement fournis, sans dépasser une masse limite. À pleine charge, à 2 400 tours par minute, elle doit respecter ses limites de contrainte, de rigidité et de charge sur les paliers, et tenir des millions de cycles sans rupture par fatigue.
La deuxième porte sur le routage de la mémoire DDR3L d’une carte FPGA de série : un bus de 32 bits entre un circuit Zynq-7000 et deux puces mémoire. Il faut faire sortir 71 signaux d’un boîtier BGA de 484 billes, sur une carte de huit couches où près de 300 composants sont déjà placés et tous les autres signaux déjà routés, sans rien déplacer. La troisième consiste à calculer le transfert de chaleur autour d’une aube de turbine haute pression, placée juste derrière la chambre de combustion, là où le gaz est plus chaud que ce que le métal peut supporter.
Selon Xplore, chaque tâche a été rédigée par un ingénieur de son équipe, spécialiste du domaine. Il a aussi écrit le programme de vérification et une solution de référence qui remplit toutes les exigences, avec les outils mêmes que reçoivent les agents.
Une correction par programme, sans juge
Ni humain ni modèle de langage ne note les rendus. Un programme déterministe confronte chaque conception à chaque exigence du cahier des charges. Il suffit d’une exigence non remplie pour que l’essai échoue.
L’agent reçoit le même cahier des charges qu’un ingénieur. Il travaille dans un environnement isolé, avec des logiciels professionnels de CAO et de simulation, pendant 24 heures au plus. Un essai a duré en moyenne 3,4 heures, tous modèles confondus.
Chaque modèle travaille dans l’agent de son propre éditeur : Codex pour OpenAI, Claude Code pour Anthropic, Gemini CLI pour Google, Kimi Code pour Moonshot AI. Selon la page du banc, il dispose de cinq essais par tâche, avec l’effort de raisonnement maximal.
Le classement du 28 octobre
GPT-6 Astra réussit en moyenne 37 % de ses essais sur les vingt tâches, avec un intervalle de crédibilité à 95 % allant de 30,7 % à 43,8 %. Claude Opus 5.5 suit avec 29 % (de 21,9 % à 37,6 %), puis GPT-6.1 Sol avec 25 % (de 18,8 % à 31,9 %). Les intervalles des deux premiers se recouvrent de 30,7 % à 37,6 % : l’avance de GPT-6 Astra sur Claude Opus 5.5 reste donc incertaine. Le 3 novembre, OpenAI a indiqué que deux de ses salariés avaient conçu un petit appareil avec GPT-6 Astra, du boîtier au firmware, tout en notant que le modèle n’avait pas toujours tenu compte des tolérances du fabricant.
Gemini 4 Argon, de Google, s’arrête à 12 %. Claude Fable 5.1, d’Anthropic, n’atteint que 7 %, loin derrière Opus 5.5 ; notre guide des modèles Claude présente les deux familles.
Cinq modèles restent à zéro : DeepSeek V4.1 Flash, Qwen3.8 Max (Alibaba), GLM-5.3 (Z.ai), Grok 4.7 (xAI) et Muse Wonder, le modèle de Meta.
Cinq essais changent l’ordre
Xplore publie aussi un taux de réussite sur plusieurs tentatives : une tâche compte comme réussie dès qu’un essai passe. Avec cinq essais, Claude Opus 5.5 réussit 70 % des tâches et passe devant GPT-6 Astra (60 %) et GPT-6.1 Sol (50 %). Gemini 4 Argon monte à 35 % et Fable 5.1 à 20 %.
« Capable, mais pas encore régulier », résume la page à propos d’Opus 5.5. Le modèle d’Anthropic réussit moins d’un tiers des tâches du premier coup, contre plus des deux tiers en cinq tentatives.
Le prix d’un essai
Xplore indique pour chaque modèle la dépense moyenne d’API d’un essai sur une tâche, en dollars. Les montants ci-dessous sont convertis en euros au cours de référence de la BCE du 27 octobre 2026 (1 euro pour 1,115 dollar).
| Modèle | Réussite, 1 essai | Réussite, 5 essais | Coût moyen par essai | Durée moyenne |
|---|---|---|---|---|
| GPT-6 Astra (OpenAI) | 37 % | 60 % | 52,76 € | 2,8 h |
| Claude Opus 5.5 (Anthropic) | 29 % | 70 % | 51,59 € | 4,2 h |
| GPT-6.1 Sol (OpenAI) | 25 % | 50 % | 9,22 € | 3,2 h |
| Gemini 4 Argon (Google) | 12 % | 35 % | 21,22 € | 2,5 h |
| Claude Fable 5.1 (Anthropic) | 7 % | 20 % | 87,51 € | 3,7 h |
| Kimi K3.1 Pro (Moonshot AI) | 1 % | 5 % | 63,86 € | 4,1 h |
GPT-6.1 Sol revient en moyenne à 10,28 dollars d’API par essai, soit 9,22 euros. GPT-6 Astra (58,83 dollars, soit 52,76 euros) et Claude Opus 5.5 (57,52 dollars, soit 51,59 euros) coûtent près de six fois plus, pour respectivement 12 et 4 points de plus. « Dépenser plus rapporte peu », titre Xplore. Claude Fable 5.1 affiche le coût moyen le plus élevé du classement, 97,57 dollars par essai (87,51 euros), pour 7 % de réussite.
Selon Xplore, les essais les plus longs n’ont pas obtenu de meilleurs scores : GPT-6 Astra, en tête, compte parmi les plus rapides. Opus 5.5 a traité en moyenne 91,7 millions de tokens en entrée par essai, contre 32,8 millions pour Astra.
GPT-6.1 Terra, qu’OpenAI a présenté le 26 octobre comme neuf fois moins cher par tâche que Claude Opus 5.5 sur l’un de ses propres tests, ne figure pas dans ce classement.
Gemini 4 Carbon, le successeur d’Argon présenté par Google le 28 octobre, n’y figure pas non plus : le modèle prend la tête de l’indice d’Artificial Analysis avec un point d’avance sur Claude Opus 5.5.
Les limites de l’exercice
Le banc ne compte que vingt tâches, dont trois seulement sont décrites en détail. Xplore ne dit pas quelles sont les quatre tâches qu’aucun modèle n’a réussies, et la page ne propose ni les programmes de vérification ni les solutions de référence : l’accès passe par une prise de contact avec l’équipe. Le 28 octobre, nous n’avions trouvé aucune reproduction indépendante des résultats.
Le fichier de données publié avec la page se déclare lui-même provisoire : il provient d’un export du 25 octobre, réalisé alors que des essais tournaient encore, et le classement compte 99 ou 100 essais selon les modèles. Il indique aussi un effort « high » pour Gemini 4 Argon et « xhigh » pour Qwen3.8 Max et Grok 4.7, alors que la page annonce l’effort maximal pour tous. Aucune des deux sources ne précise si ces réglages sont les plus élevés que propose chaque outil. Comme chaque modèle travaille dans l’agent de son éditeur, le score mesure le couple formé par le modèle et cet agent.
La page ne donne pas non plus de référence humaine. Elle affirme qu’il faut un ingénieur spécialiste, formé aux logiciels d’ingénierie assistée par ordinateur, pour réussir une seule de ces tâches, mais ne publie ni taux de réussite ni durée mesurés chez des ingénieurs. Un message publié sur Reddit le 28 octobre avance que la plupart des gens n’en réussiraient aucune, ce que la page ne mesure pas.
Xplore vend aussi des environnements d’entraînement pour modèles, construits selon la même méthode que le banc, et précise que les tâches du banc ne sont jamais proposées sous licence pour l’entraînement. Un laboratoire peut demander à faire évaluer son modèle, et son score n’apparaît au classement que s’il le souhaite.
Le fonds Lightspeed a félicité l’équipe sur X le jour du lancement, et le podcasteur Dwarkesh Patel s’y est dit fier de la soutenir. Le site RuntimeWire, qui a couvert l’annonce le 27 octobre, note que l’activité d’Xplore dépend de la capacité de ces tâches d’experts à devenir une infrastructure d’entraînement utile.
Notre analyse
Lightspeed relève dans son message que l’ingénierie physique manque encore des évaluations et des récompenses vérifiables dont disposent le code et les mathématiques. RWE-bench mesure des livrables d’ingénierie, contrôlés par le calcul, et chiffre le coût de chaque essai. Le premier classement est net : dans les agents commerciaux de leurs éditeurs, les meilleurs modèles échouent sur la plupart de ces tâches au premier essai. Avec cinq tentatives, le meilleur en réussit pourtant sept sur dix.
Pour les bureaux d’études, les électroniciens et les ingénieurs indépendants qui suivent ces outils, le résultat le plus parlant tient à l’irrégularité : une même tâche peut passer à un essai et échouer au suivant, avec le même modèle et les mêmes outils. Le banc montre aussi qu’un prix plus élevé rapporte peu de points : le moins cher des trois premiers coûte près de six fois moins que les deux autres, pour 12 et 4 points de moins.
Ces échecs en conception tranchent avec une annonce de la même semaine : OpenAI a affirmé que son IA avait réfuté l’hypothèse du temps exponentiel, une conjecture d’informatique théorique. Dans son texte de présentation, Xplore décrit le même écart à partir d’un autre résultat : un modèle a produit cette année une preuve sur l’un des problèmes du prix du millénaire, consacré à l’écoulement des fluides, mais les modèles ne savent toujours pas concevoir de façon fiable un réseau de canalisations qui transporte vraiment l’eau.
Les chiffres restent ceux d’Xplore, sur ses tâches, avec ses programmes de vérification, dans une version marquée provisoire. La société annonce des tâches plus difficiles et de nouveaux domaines, dont le génie biomécanique, le génie civil et le génie des matériaux. Restent à voir la reproduction des résultats par un tiers, l’arrivée d’autres laboratoires au classement et l’évolution des scores avec les prochains modèles.
Sources
- RWE-bench · Real World Engineering Bench, Xplore, résultats au 28 octobre 2026
- Fichier de données du classement RWE-bench, Xplore, export du 25 octobre 2026
- Introducing Real World Engineering Bench (RWE-Bench), Xplore sur X, 27 octobre 2026
- The physical world is next, Xplore, consulté le 28 octobre 2026
- Xplore AI launches engineering benchmark, with GPT-6 Astra at 37%, RuntimeWire, 27 octobre 2026
- Message sur le lancement de RWE-bench, Lightspeed sur X, 27 octobre 2026
- Message de soutien à Xplore, Dwarkesh Patel sur X, 27 octobre 2026
- Cours de référence de l’euro en dollars, Banque centrale européenne, 27 octobre 2026
Image d’en-tête : graphique MACCUS, données Xplore (RWE-bench, résultats au 28 octobre 2026).