
Meta a présenté le 12 octobre 2026 Muse Wonder et Muse Wonder Full, ses deux modèles d’IA les plus puissants à ce jour, conçus pour des agents qui mènent des tâches personnelles et professionnelles. Muse Wonder est disponible dès maintenant dans l’API de Meta (Meta Model API) et dans Muse Code, son outil de programmation. Muse Wonder Full est réservé aux abonnés de Muse Code.
Dans le tableau publié par Meta, ses deux modèles arrivent en tête sur la moitié des tests, et Claude Opus 5.5, d’Anthropic, garde l’avantage sur presque tous les autres. Pour une petite entreprise qui utilise déjà Claude ou ChatGPT, rien ne presse : les chiffres viennent de Meta, le modèle est encore en préversion et la variante la plus performante n’est vendue qu’en abonnement.
Deux modèles, une seule version vendue à l’usage
Meta présente Muse Wonder comme la suite de Muse Spark, quatorze mois après avoir entrepris de reconstruire son activité d’IA.
L’annonce insiste sur deux capacités. La première, Active Memory, garde d’une conversation à l’autre le contexte important vous concernant et le ressort quand il devient utile. La seconde, Active Focus, pousse le modèle à continuer quand une tâche se complique : essayer une autre approche, contourner un blocage, demander une précision, puis vous consulter avant une action importante.
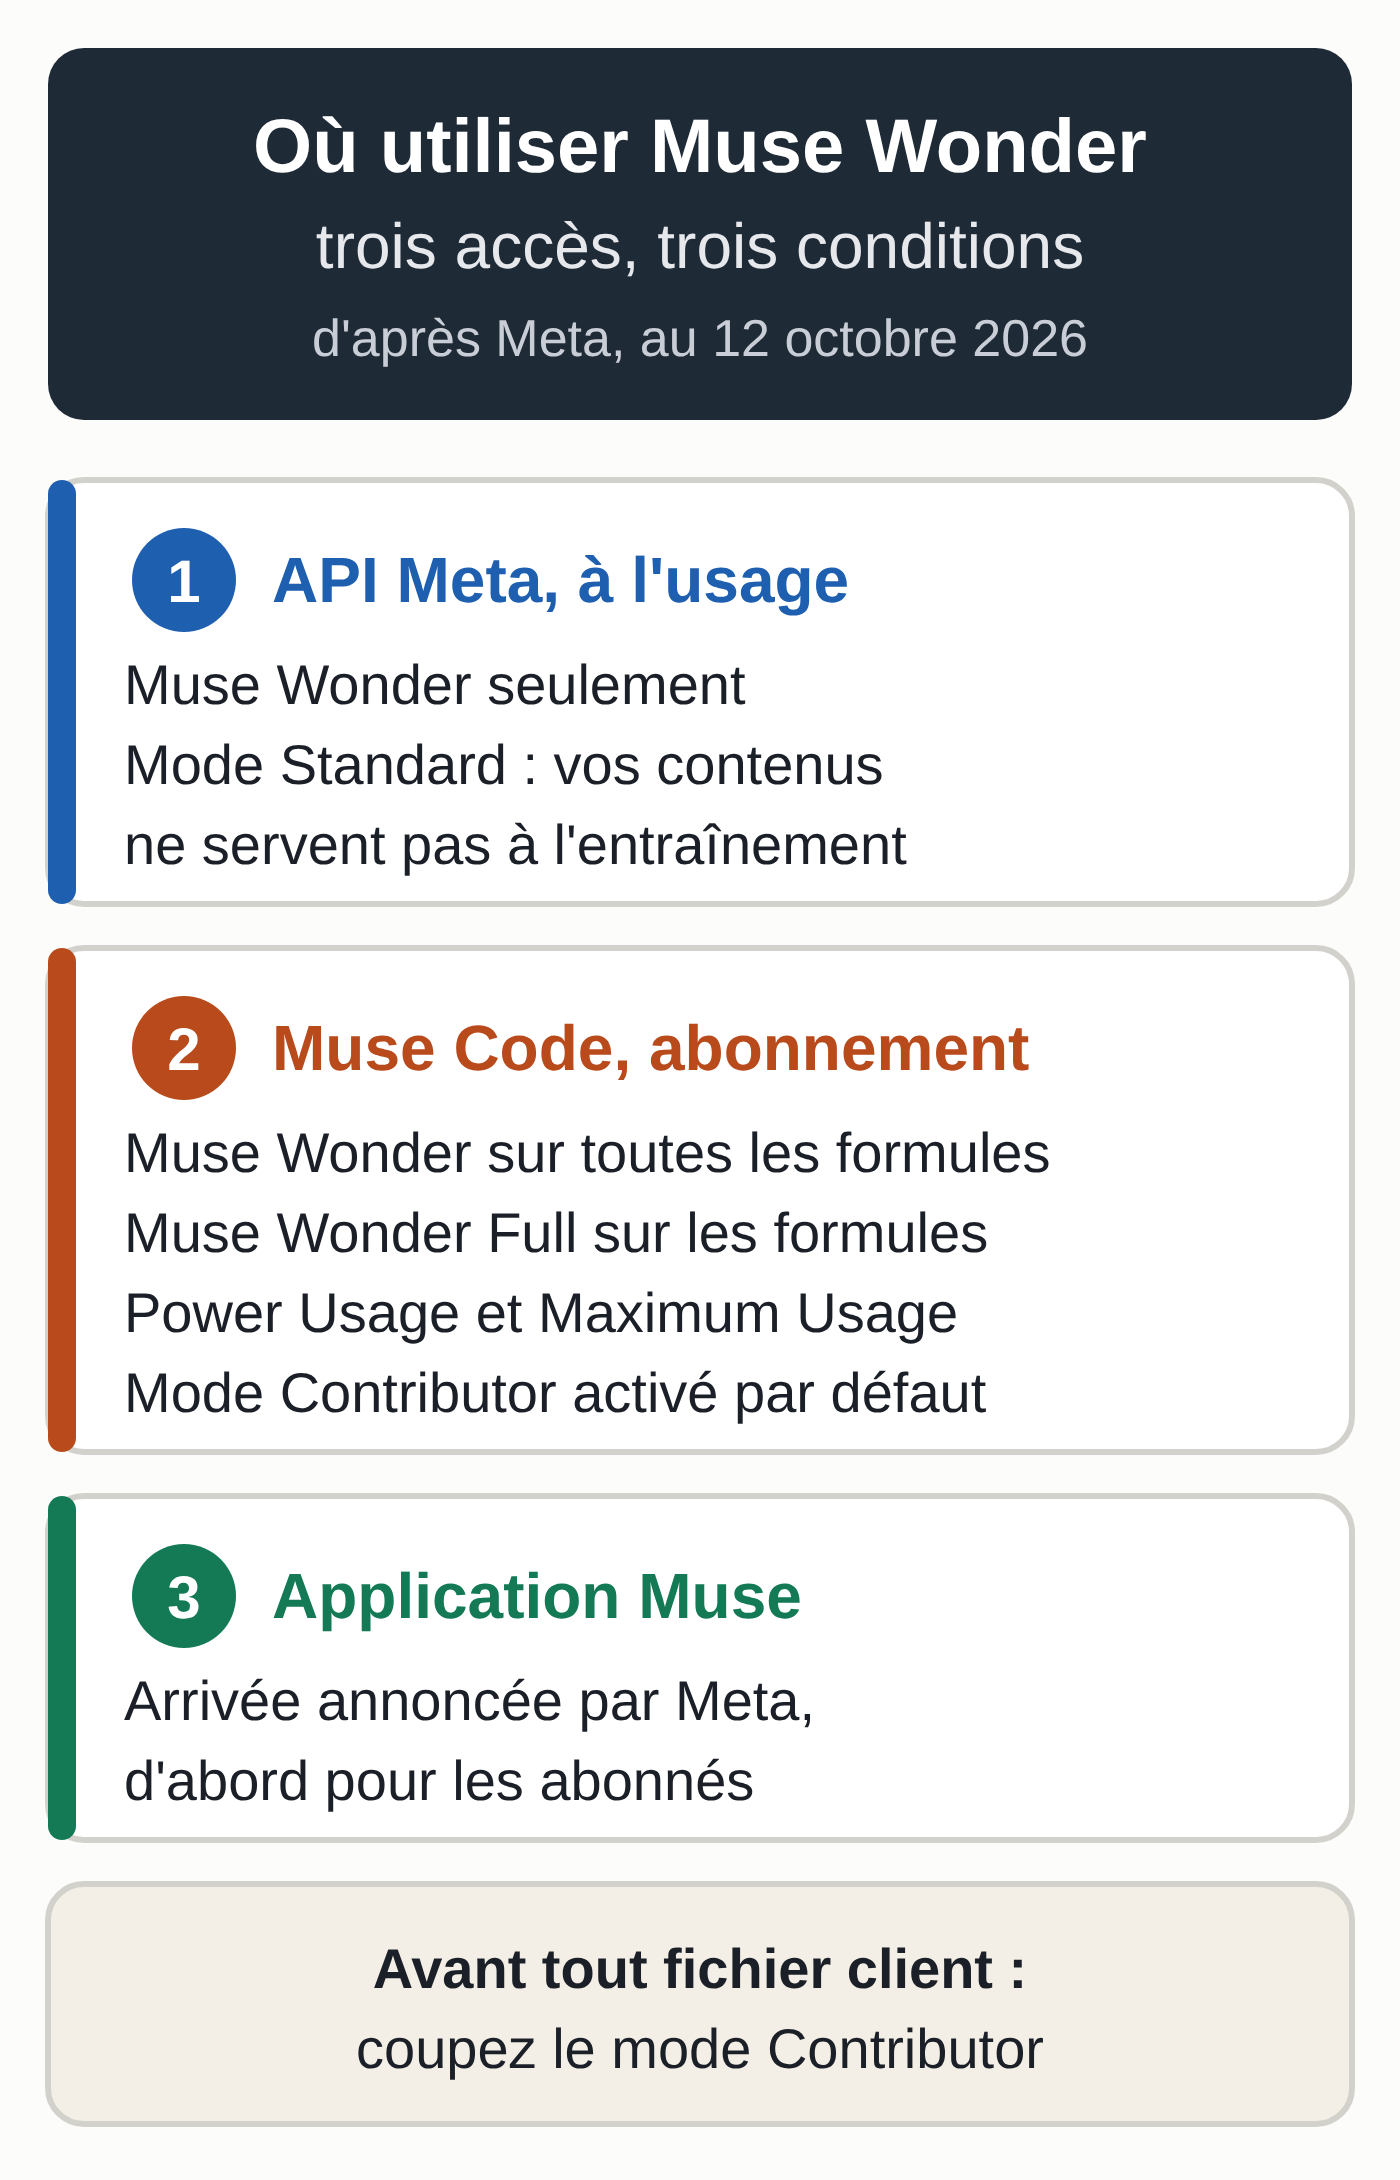
Muse Wonder (identifiant muse-wonder-1.0) se paie à l’usage par l’API et figure dans toutes les formules de Muse Code. Muse Wonder Full ne passe pas par l’API : il faut un abonnement Muse Code de niveau Power Usage ou Maximum Usage. Dans l’application grand public Muse, Muse Wonder arrivera « bientôt », d’abord pour les abonnés.
Combien coûte Muse Wonder ?
Sur l’API, Muse Wonder coûte 4 dollars par million de tokens en entrée et 20 dollars par million en sortie, soit environ 3,58 € et 17,89 € au cours de la BCE du 12 octobre (1 € = 1,1181 $). L’entrée mise en cache tombe à 0,20 dollar (environ 0,18 €). La recherche web s’ajoute à 2,50 dollars les 1 000 requêtes, et Meta n’applique pas de supplément pour les longs contextes.
Muse Spark 1.3 est facturé 1,25 dollar en entrée et 4,25 dollars en sortie : Muse Wonder coûte donc 3,2 fois plus cher en entrée et près de cinq fois plus en sortie. La documentation annonce une fenêtre de contexte de 1 048 576 tokens, des entrées en texte, image, vidéo, audio et PDF, et des réponses en texte.
La documentation de Meta ne donne pas le prix des quatre formules de Muse Code. Selon CNBC, Muse Wonder Full est réservé aux formules à 50 et 200 dollars par mois (environ 45 € et 179 €), et l’accès à Muse Wonder dans l’application Muse demandera un abonnement de 20 ou 100 dollars par mois (environ 18 € et 89 €). Alexandr Wang, responsable de l’IA chez Meta, a affirmé à la chaîne que l’offre pour les développeurs, plus chère que les abonnements standard, serait facturée « nettement en dessous » des meilleurs modèles d’OpenAI et d’Anthropic.
La disponibilité en France et en Belgique n’est pas précisée. La documentation de Meta indique que l’accès aux modèles « peut varier selon le pays » et cite une politique d’usage géographique dont la page affichait une erreur le soir du 12 octobre. La fiche technique désigne comme fournisseur « Meta Platforms, Inc. ou Meta Platforms Ireland Limited », sans liste de pays. OpenRouter, qui revend l’accès à de nombreux modèles, le référence déjà au même tarif.
Le mode Contributor, à désactiver avant tout dossier client
Avec le « mode Contributor », vous autorisez Meta à entraîner ses futurs modèles sur vos requêtes, votre code, vos fichiers, le contexte envoyé et les réponses reçues, en échange d’un prix réduit ou d’un volume d’usage plus élevé.
Sur l’API à l’usage, Muse Wonder ne fonctionne qu’en mode Standard, où vos contenus ne servent pas à l’entraînement. Les abonnements Muse Code, eux, activent le mode Contributor par défaut. Il se désactive à tout moment dans les réglages, et les contenus envoyés ensuite ne servent plus à l’entraînement. Faites-le avant d’ouvrir le moindre dossier client, et inscrivez la règle dans votre charte IA interne.
Les résultats publiés par Meta
Meta compare ses deux modèles à Claude Fable 5.1 et Claude Opus 5.5 (Anthropic) et à GPT-6 Astra (OpenAI), tous réglés sur l’effort de raisonnement maximal. Voici ses chiffres, en pourcentage de réussite ou en score selon le test.
| Test (domaine) | Muse Wonder Full | Muse Wonder | Claude Fable 5.1 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index (indice interne à Meta) | 59,1 | 54,3 | 49,9 | 54,5 | 55,2 |
| Harvey LAB-AA (travail juridique) | 13,1 | 10,0 | 6,4 | 8,6 | 4,2 |
| Vals Finance Agent V2 (analyse financière) | 59,1 | 56,6 | 58,9 | 53,5 | 58,6 |
| HealthBench Pro (questions de santé) | 62,3 | 60,5 | 62,1 | 65,3 | 65,6 |
| AutomationBench-AA (processus métier) | 45,4 | 39,1 | 32,1 | 41,6 | 41,2 |
| GDP.pdf (travail sur documents PDF) | 33,2 | 30,8 | 27,6 | 34,2 | 30,6 |
| JobBench (tâches de bureau) | 75,3 | 70,5 | 73,1 | 66,1 | 75,4 |
| OSWorld V2.1 (pilotage d’un ordinateur, score partiel) | 78,4 | 72,6 | 80,7 | 75,8 | 81,8 |
| MemoryBench (mémoire, test interne à Meta) | 85,5 | 85,6 | 79,0 | 81,4 | 81,5 |
| Terminal-Bench 4.0-AA (code en terminal) | 57,1 | 52,0 | 52,0 | 59,1 | 59,6 |
| DeepSWE 1.1 (code sur la durée) | 79,0 | 78,8 | 67,4 | 74,1 | 74,2 |
| SWE-Marathon (très longs projets de code) | 57,5 | 53,1 | 45,6 | 42,5 | 46,3 |
| ProgramBench (programme écrit de zéro) | 59,0 | 50,0 | 55,5 | 52,5 | 70,5 |
| Artificial Analysis Index (indice général) | 56 | 52 | 53 | 53 | 58 |
Source : Meta, 12 octobre 2026. En gras, le meilleur résultat de chaque ligne. Muse Wonder Full a été mesuré en effort « xhigh » sur SWE-Marathon.
Les modèles de Meta gagnent sept lignes sur quatorze, avec un écart net en droit et sur le code de longue durée. Claude Opus 5.5 en gagne six, dont la programmation de zéro (70,5 contre 59,0) et l’indice général d’Artificial Analysis (58 contre 56). La ligne restante, GDP.pdf, revient à GPT-6 Astra. Plusieurs écarts tiennent en quelques dixièmes, comme JobBench (75,4 contre 75,3) ou Vals Finance Agent V2 (59,1 contre 58,9).
La fiche technique de Meta signale elle-même trois réserves. Une partie des lignes reprend des mesures de tiers (Artificial Analysis, Vals AI, Datacurve), d’autres ont été mesurées par Meta lui-même, et trois chiffres viennent de tests internes impossibles à refaire de l’extérieur : le Personal Superintelligence Index, MemoryBench et FocusBench. Quand Meta a lui-même fait tourner les concurrents, il l’a fait « au mieux », avec des réglages qui ne sont pas forcément optimaux pour eux. Sur SWE-Marathon, enfin, GPT-6 Astra et Claude Fable 5.1 ont été évalués à travers Codex et Claude Code, donc pas dans le même environnement que les modèles de Meta.
Si vous comptez payer à l’usage, notez que la version vendue par l’API n’est pas celle qui domine le tableau. Sur l’indice général d’Artificial Analysis, Muse Wonder obtient 52, sous les trois modèles concurrents. Sur FocusBench, le test interne d’Active Focus, il passe aussi derrière GPT-6 Astra et Claude Opus 5.5 : 54,2 % pour Muse Wonder Full, 47,7 % pour GPT-6 Astra, 45,8 % pour Claude Opus 5.5, 44,9 % pour Muse Wonder et 36,6 % pour Claude Fable 5.1.
Meta publie aussi un graphique sur des tâches pour lesquelles le modèle n’a pas été spécifiquement entraîné. D’après notre lecture du graphique, à score égal sur les tâches entraînées, Muse Wonder Full y fait environ dix points de mieux que la tendance de Muse Spark 1.3. Meta attribue ce gain à un modèle de base plus grand et plus solide.
Les garde-fous annoncés
Meta dit avoir entraîné Muse Wonder à ne pas divulguer d’informations privées sans permission et à refuser les demandes dangereuses. Sur le test de refus des usages cyber malveillants publié par Meta, où Claude Opus 5.5 ne figure pas, Claude Fable 5.1 obtient 97,5 %, Muse Wonder Full 96,9 %, Muse Wonder 93,7 % et GPT-6 Astra 86,3 %. Sur son test de mauvaise gestion d’informations personnelles, où le taux le plus bas est le meilleur, Muse Wonder Full enregistre 2,2 % de manquements.
Selon CNBC, ces protections cyber ne concernent pour l’instant que le modèle payant. D’après la fiche technique, Meta n’exclut pas que le modèle, sans mesures de protection, atteigne son seuil de risque élevé dans le domaine chimique et biologique, d’où un entraînement de sécurité spécifique et des filtres ajoutés autour du modèle. Elle recommande aussi une confirmation humaine avant toute action irréversible, la même précaution que nous détaillons dans notre article sur les garde-fous à poser autour des agents IA.
Notre essai du modèle précédent
En septembre 2026, nous avons comparé à l’aveugle Muse Spark 1.3 à d’autres modèles sur la traduction de textes de recettes en 23 langues. En anglais, espagnol, allemand et polonais, sa prose a tenu la comparaison avec le meilleur modèle testé. Dans la plupart des autres langues, il restait derrière, avec des réponses environ six fois plus lentes que celles du modèle de référence. Sur des factures scannées, il relevait correctement montants et IBAN, mais une erreur de format nous a rappelé qu’il faut vérifier chaque extraction.
Faut-il tester Muse Wonder dans votre entreprise ?
Oui, si vous confiez déjà à l’IA des tâches longues ou des documents juridiques, et à condition de le tester sur votre travail réel.
- Prenez trois à cinq tâches réelles (résumer un contrat, analyser un tableau de chiffres, préparer une réponse client) et soumettez-les, avec les mêmes consignes, à Muse Wonder par l’API et à votre modèle actuel.
- Vérifiez dès l’ouverture du compte que l’accès fonctionne depuis votre pays : la page de Meta sur les restrictions par pays était inaccessible le 12 octobre au soir.
- Sur Muse Code, coupez le mode Contributor avant le premier fichier client.
- Suivez la consommation pendant l’essai. Un agent qui enchaîne les étapes renvoie souvent tout son contexte à chaque appel, et le tarif de l’entrée en cache devient alors déterminant pour la facture.
- Gardez une validation humaine pour tout envoi, paiement ou suppression.
Pour situer Muse Wonder parmi les modèles que vous connaissez, lisez notre guide pour choisir son modèle IA et organiser plusieurs agents et notre point sur les modèles GPT d’OpenAI. Si le prix est votre critère principal, Claude Haiku 5.5 coûte 40 fois moins cher par l’API, en entrée comme en sortie, pour les requêtes jusqu’à 100 000 tokens.
Points encore incertains
Au soir du 12 octobre, aucun organisme indépendant n’avait refait l’ensemble des tests, et le rapport de sécurité complet, annoncé « bientôt », n’était pas publié. Meta ne donne aucun résultat propre au français : sa fiche indique seulement que le modèle n’a pas été évalué dans toutes les langues et que ses performances peuvent baisser en dehors des langues les mieux prises en charge.
Si vous voulez un assistant configuré pour votre activité sans avoir à suivre vous-même chaque nouveau modèle, découvrez notre assistant IA.