
NVIDIA a publié le 15 octobre 2026 deux modèles ouverts de sa famille Nemotron 3.5, annoncés sur son blog, avec des poids téléchargeables le jour même sur Hugging Face. Le premier, Nemotron 3.5 Bolt 74B-A9B, compte 74 milliards de paramètres, compressés pour l’essentiel à environ 2 bits afin de tenir dans 24 Go de mémoire. Il peut ainsi tourner sur une seule machine : NVIDIA l’a notamment testé sur un PC équipé d’une GeForce RTX 5090 et sur un DGX Spark.
Le second, Nemotron 3.5 Super VL, compte 120 milliards de paramètres et a été conçu pour les agents IA : il lit du texte, des images, des vidéos courtes et des PDF. Les deux sont distribués sous la licence OpenMDW-1.1, qui autorise l’usage commercial.
Pour une TPE, un cabinet ou une agence, cela signifie qu’un modèle de cette taille, conçu pour les agents et qui prend en charge le français, tourne sur un seul poste de travail haut de gamme. Les documents des clients n’ont pas à partir vers un service en ligne. Notre guide de l’IA locale en entreprise détaille le choix de la machine et du modèle.
Les scores et les vitesses cités plus bas viennent de NVIDIA ou de ses partenaires, y compris quand NVIDIA invoque le classement d’Artificial Analysis.
Deux modèles disponibles, un troisième le 23 octobre
| Modèle | Paramètres (dont actifs) | Contexte maximal | Matériel cité par NVIDIA | Disponibilité |
|---|---|---|---|---|
| Super VL 120B-A12B | 120 milliards (12) | 1 million de tokens | 1 DGX Spark, 1 H200, 2 H100 ou 1 GB200 | 15 octobre 2026 |
| Bolt 74B-A9B 24GB | 74 milliards (9) | 256 000 tokens | PC GeForce RTX (RTX 5090 testée), DGX Spark, portables RTX Spark | 15 octobre 2026 |
| Bolt E4B 4GB | non précisé | non précisé | GeForce RTX, Jetson, RTX Spark et DGX Spark | 23 octobre 2026 |
Super VL et Bolt 74B sont des modèles à mélange d’experts (MoE) : pour chaque token, seule une partie des paramètres travaille, 12 milliards sur 120 dans le premier, 9 milliards sur 74 dans le second. Le calcul se rapproche donc de celui d’un modèle de 12 ou de 9 milliards de paramètres, mais la mémoire doit contenir le modèle entier.
Super VL lit les tableaux, les graphiques et les PDF
Côté vision, Super VL cible les documents qu’un agent croise au travail : texte à reconnaître (OCR), tableaux, graphiques, pages web et PDF. Selon sa fiche sur Hugging Face, il accepte des images JPEG ou PNG et des vidéos MP4 de deux minutes au plus, et répond en texte. Le français figure parmi les langues privilégiées lors de son affinage, avec l’allemand, l’italien, le japonais, l’espagnol et le chinois.
La même fiche affiche 52,3 sur OSWorld-Verified (l’usage d’un ordinateur par un agent) et 68,34 sur OCRBench v2 en anglais. L’éditeur revendique aussi, pour les tâches d’agent, un débit jusqu’à cinq fois supérieur à celui des autres modèles ouverts de même taille. Dans son blog technique, le graphique qui appuie ce chiffre classe des modèles ouverts selon l’indice d’Artificial Analysis et leur vitesse, avec 100 000 tokens en entrée : Super VL y dépasse 600 tokens générés par seconde sur le service de Baseten, cinq fois plus qu’Inkling Small.
Super VL n’est pas fait pour un PC de bureau ordinaire. Sa fiche liste quatre configurations : un DGX Spark, boîtier compact doté de 128 Go de mémoire, un GPU H200, deux H100 ou un GB200. Pour un usage local, elle cite aussi les portables RTX Spark et la carte professionnelle RTX PRO 6000.
Le modèle est publié sur Hugging Face et ModelScope, disponible en microservice NVIDIA NIM et accessible sur OpenRouter, qui en offrait une version gratuite le 15 octobre. Le blog technique ajoute les grands clouds (Amazon, Google, Microsoft, Oracle) et des hébergeurs comme Together AI.
Bolt 74B sur un poste de travail
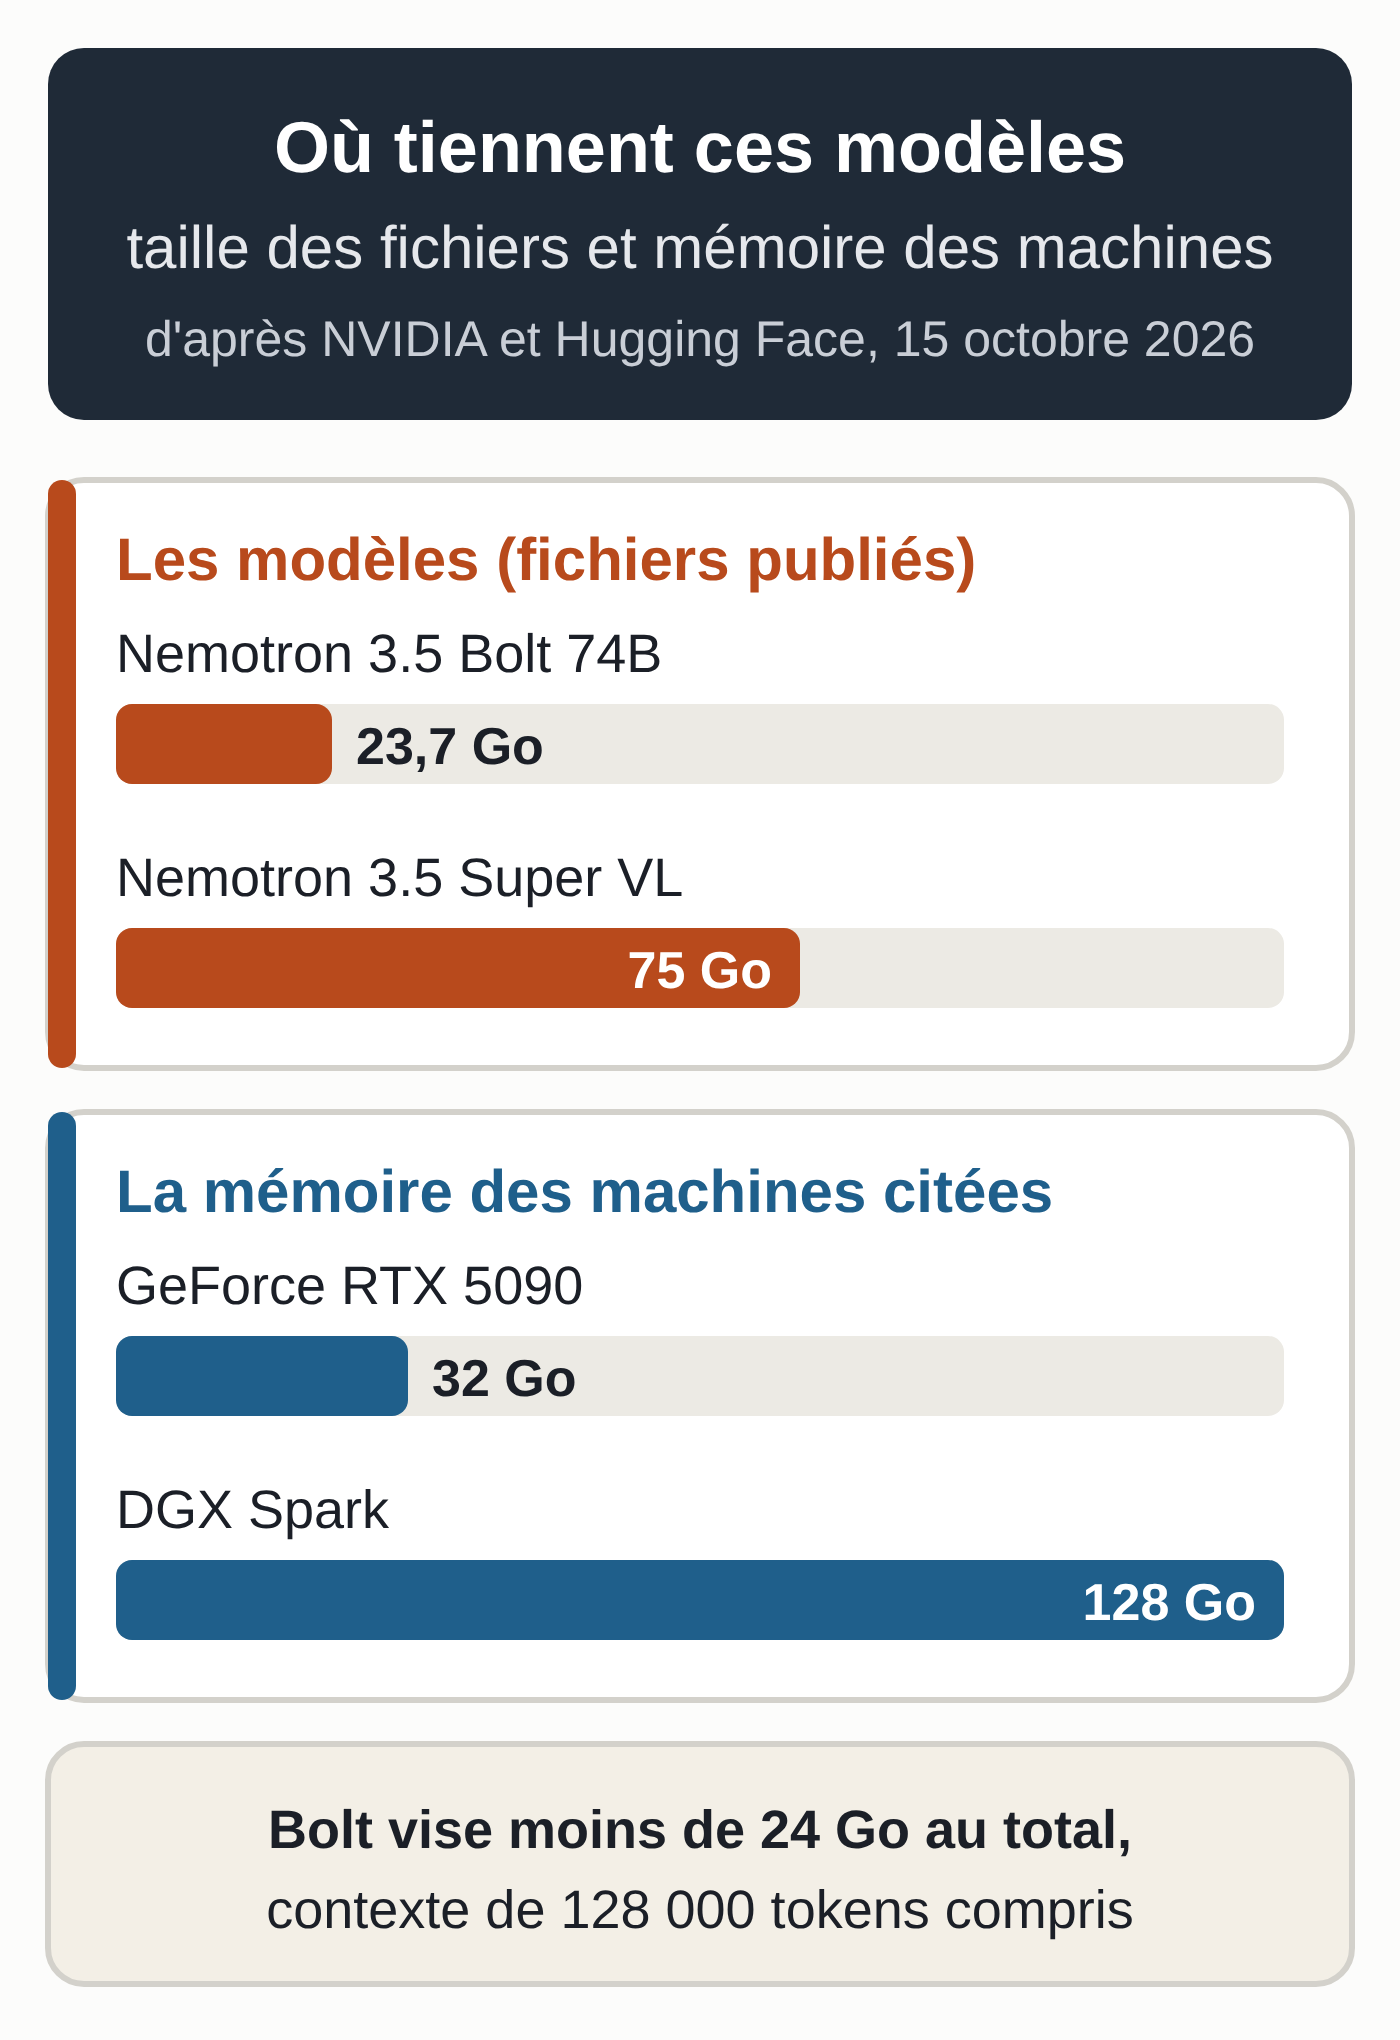
Bolt 74B-A9B est une version compressée de Super VL. Ses experts sont stockés sur environ 2 bits par paramètre (2,0625 exactement, au format IQ2-XXS), contre 16 bits dans la version de référence. NVIDIA visait moins de 24 Go pour une requête à la fois avec 128 000 tokens de contexte (256 000 au maximum). Le fichier publié par NVIDIA au format GGUF, celui de llama.cpp, pèse 22 Go, plus 1,7 Go pour la partie vision.
La fiche de Bolt le destine aux logiciels d’agents installés sur la machine et aux tâches qui demandent d’appeler des outils, de naviguer sur le web ou d’utiliser un terminal. Il travaille d’abord en anglais et dans les langages de programmation ; l’espagnol, le français, l’allemand, l’italien et le japonais sont « également pris en charge ». Comme Super VL, il lit le texte, les images et la vidéo.
NVIDIA dit avoir conçu Bolt pour les portables RTX Spark, attendus le 16 octobre, et indique qu’il tourne aussi sur les PC GeForce RTX, le DGX Spark, la DGX Station et les stations RTX PRO. La RTX 5090 testée par NVIDIA dispose de 32 Go de mémoire ; la RTX 4090 et ses 24 Go n’apparaissent ni dans la fiche ni dans l’annonce.
NVIDIA annonce la prise en charge de llama.cpp, Ollama, LM Studio, Unsloth et vLLM. Le 15 octobre en fin d’après-midi, Bolt ne figurait pas encore dans la bibliothèque d’Ollama, où la famille Nemotron 3.5 se limitait à Lightning, sorti en août.
Sur la fiche de Bolt, NVIDIA le compare à deux autres modèles ouverts, Qwen3.6-35B-A3B d’Alibaba et Gemma 4 26B-A4B de Google, testés dans leur version non compressée (BF16). Bolt obtient 66,75 sur BrowseComp (recherche sur le web), contre 48,74 et 26,30, et 50,98 sur Terminal-Bench 2.1 (tâches en ligne de commande), contre 44,38 et 37,22. Le blog de NVIDIA le présente comme le premier modèle ouvert de sa catégorie sur PinchBench, alors que le tableau de la fiche lui donne 87,82, juste derrière les 88,07 de Qwen.
Dassault Systèmes et Mistral AI dans l’écosystème de Super VL
NVIDIA cite six éditeurs de logiciels qui intègrent Super VL, dont Atlassian pour la recherche dans Jira et Confluence, Dassault Systèmes pour la conception et la simulation en ingénierie, et Salesforce pour automatiser des procédures d’administrations publiques ; CrowdStrike, Perplexity et Synopsys complètent la liste.
D’autres entreprises l’ont affiné sur leurs propres données. Selon le blog technique, Scale AI l’a adapté au traitement automatisé des avoirs fournisseurs de Skydance, ce qui devrait diviser le coût d’inférence par 40 et la latence par 5. Ramp convertit des photos de reçus en données structurées et en attend jusqu’à 50 % de débit en plus.
Super VL a été conçu avec la Nemotron Coalition, un groupe de laboratoires lancé par NVIDIA le 16 mars 2026, dont Mistral AI fait partie aux côtés de Perplexity, LangChain ou Cursor. Le blog technique cite les apports de Perplexity (des jeux de données) et de Prime Intellect (des environnements d’entraînement), sans préciser de rôle pour Mistral AI.
Un premier test en quatre étapes
- Choisissez une tâche documentaire répétitive et facile à contrôler : relever les montants et les dates de factures fournisseurs, retrouver une clause dans des contrats, résumer un dossier de cinquante pages.
- Essayez d’abord Super VL sur des documents sans données personnelles, via un service hébergé comme OpenRouter. Avant d’y envoyer un dossier client, lisez la politique de conservation des données du fournisseur qui héberge le modèle.
- Si les résultats sont concluants, refaites l’essai en local avec Bolt, sur un PC à RTX 5090 ou un DGX Spark par exemple. Comme c’est une version compressée de Super VL, ses résultats peuvent différer. Les documents restent alors au bureau, ce qui simplifie vos réponses aux questions RGPD de vos clients. Avant d’installer un agent, notre méthode de préparation d’un agent IA en PME liste les accès, les règles et la phase de test à prévoir.
- Comparez les résultats avec ceux de l’outil que vous utilisez déjà, Claude ou ChatGPT, sur les mêmes documents (une vingtaine suffit), et notez chaque erreur. Notre guide pour choisir son modèle IA propose sur ce principe un exercice d’extraction et de réconciliation des chiffres, avec des fichiers d’exemple.
Une licence qui autorise l’usage commercial
La licence OpenMDW-1.1 accorde gratuitement le droit d’utiliser, de modifier et de redistribuer le modèle « sans restriction », à condition de joindre la licence et les mentions d’origine en cas de redistribution. Elle n’impose rien sur les contenus produits et laisse à l’utilisateur la charge de vérifier les droits des tiers. Vos droits prennent fin si vous attaquez quelqu’un en justice en affirmant que le modèle enfreint un brevet ou un droit d’auteur, sauf si vous répondez à une action engagée contre vous.
« Ouvert » signifie ici que les poids, des jeux de données et les recettes d’entraînement sont publiés. Le matériel reste à acheter ou à louer. Trois jours plus tôt, Meta présentait Muse Wonder, accessible par son API et son outil Muse Code, comme le détaille notre article sur Muse Wonder. Avec Nemotron 3.5, le modèle lui-même se télécharge.
Des scores encore à vérifier
Le 15 octobre au soir, nous n’avons trouvé aucun banc d’essai indépendant sur Bolt, et le tableau de sa propre fiche montre des points faibles. Sur AA-Omniscience, un test de non-hallucination conçu par Artificial Analysis (plus le score est élevé, mieux c’est), Bolt obtient 61,27, contre 65,85 pour Qwen3.6 et 68,81 pour Nemotron 3.5 Lightning, le modèle plus petit sorti en août. NVIDIA ne publie aucun prix : le coût réel dépend de la machine achetée ou de l’hébergeur choisi.
Du modèle téléchargé à l’outil de travail
Un modèle téléchargé ne fait rien seul. Il faut l’installer, le relier à vos documents et décider de ce qu’il a le droit de faire. Si vous préférez un outil réglé sur votre métier, notre assistant IA se configure avec les seuls accès que vous choisissez.