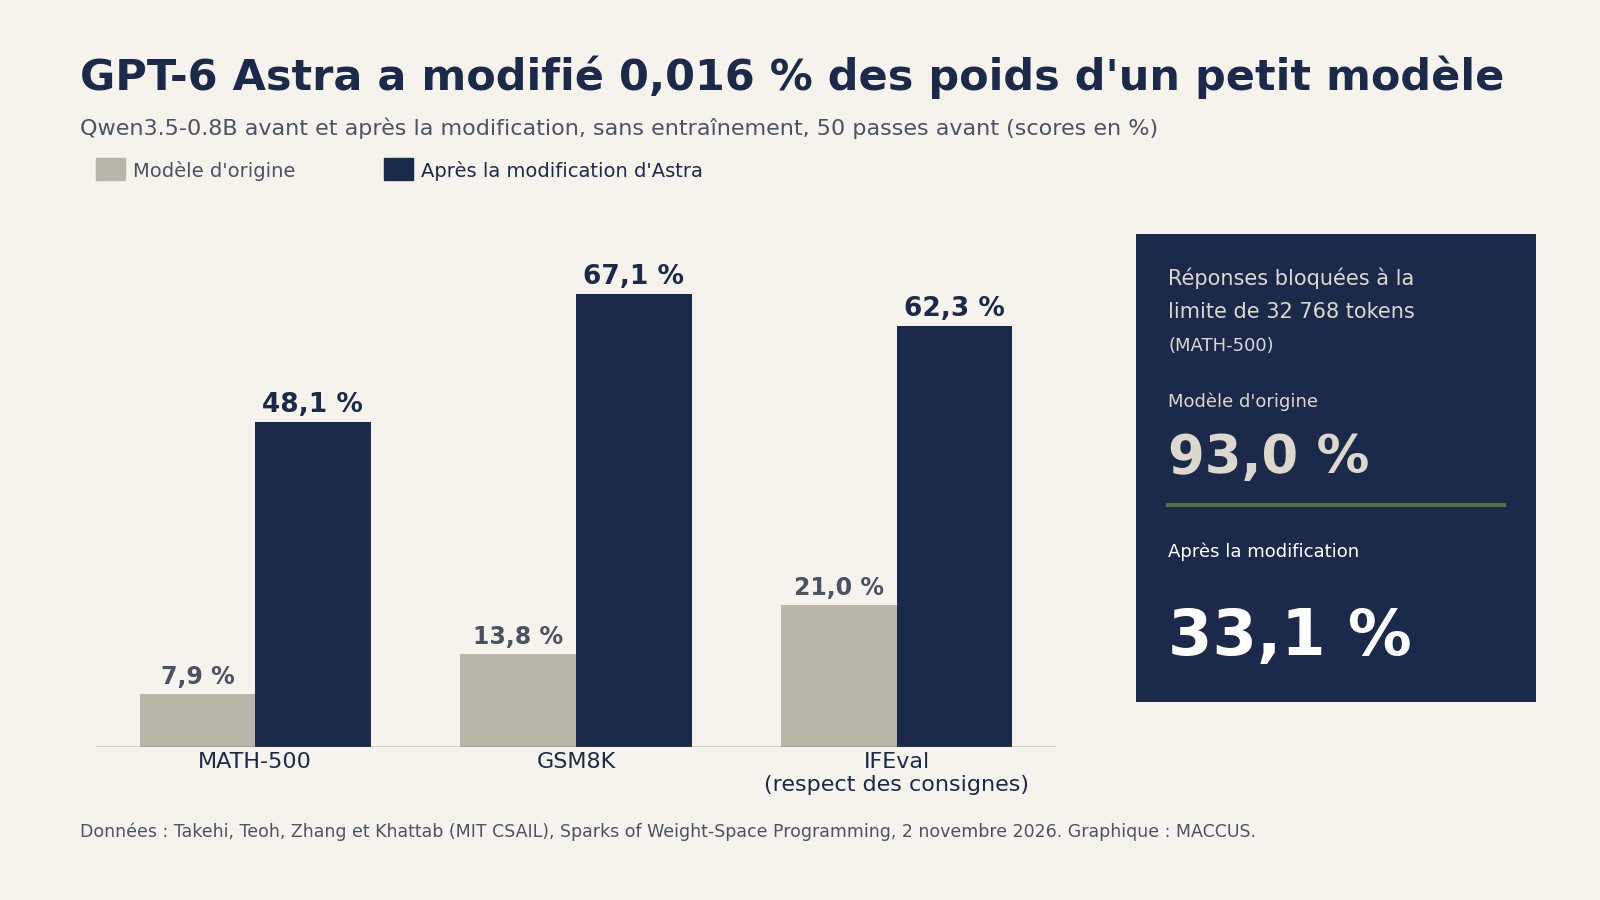

Le 2 novembre, quatre chercheurs du laboratoire d’informatique et d’IA du MIT (CSAIL) ont publié un billet de blog, appuyé par des journaux d’exécution publics, qui montre GPT-6 Astra, le modèle d’OpenAI, lire et réécrire directement les poids d’autres réseaux de neurones, sans optimiseur ni descente de gradient. Dans le test principal, Astra a modifié 0,016 % des poids de Qwen3.5-0.8B, petit modèle ouvert de l’équipe Qwen d’Alibaba, soit 131 072 sur quelque 0,8 milliard. Avec un budget de 50 passes avant (des exécutions du modèle sur des exercices), le score de Qwen au test MATH-500 est passé de 7,9 % à 48,1 %.
Le billet, « Sparks of Weight-Space Programming », est signé par Rikiya Takehi et Jayden Teoh, premiers auteurs, avec Alex Zhang et Omar Khattab. Les journaux complets, dont la modification d’Astra en diff exact au bit près, sont publics sur GitHub.
Des poids rarement réglés à la main
Un réseau de neurones est une longue liste de nombres, ses poids, presque tous fixés par l’entraînement : à partir de données et d’une mesure de l’erreur, un optimiseur comme la descente de gradient ajuste les poids jusqu’à faire baisser l’erreur. Concevoir un réseau à la main est « pratiquement impossible » pour presque tout le monde, écrivent les auteurs.
Jusqu’ici, lire des poids passait par des outils conçus pour cela, des méthodes d’interprétabilité aux simples statistiques : le 1er novembre, des utilisateurs de Hugging Face ont conclu qu’une prétendue fuite d’un modèle d’Anthropic n’était que du bruit aléatoire, d’après ses fichiers de poids. L’équipe du MIT se demande si un modèle généraliste, utilisé tel quel, peut comprendre ce que fait un réseau à partir de ses poids, puis les modifier à dessein, ce qu’elle appelle « Weight-Space Programming » (programmation dans l’espace des poids).
La boucle de Qwen
La fiche officielle du modèle prévient que Qwen3.5-0.8B « est plus enclin à entrer dans des boucles de réflexion que les autres modèles Qwen3.5, ce qui peut l’empêcher de terminer correctement sa génération ». Chargé d’améliorer Qwen en maths sans l’entraîner, Astra disposait d’une session Python sur les poids, sans GPU, d’environ 14 700 problèmes tirés des jeux d’entraînement de GSM8K et de MATH, et d’un budget de passes avant. Les tests finaux lui sont restés cachés.
Sur les 96 premières réponses du modèle d’origine aux exercices, 85 atteignaient la limite de 32 768 tokens. Astra a rattaché ces boucles à une seule direction écrite par les MLP des couches 15 et 19, puis l’a soustraite de 64 colonnes de sortie dans chacune.
Avec 50 passes avant, GSM8K, un test de maths de niveau scolaire, passe aussi de 13,8 % à 67,1 %. IFEval, un test de respect des consignes jamais visé par Astra, monte de 21,0 % à 62,3 % ; les auteurs notent que les boucles ne sont pas propres aux maths. La part des réponses à MATH-500 bloquées à la limite tombe de 93,0 % à 33,1 %. Avec 10 ou 25 passes avant, les boucles ont à peine reculé, et MATH-500 n’a atteint que 12,3 % et 14,1 %.
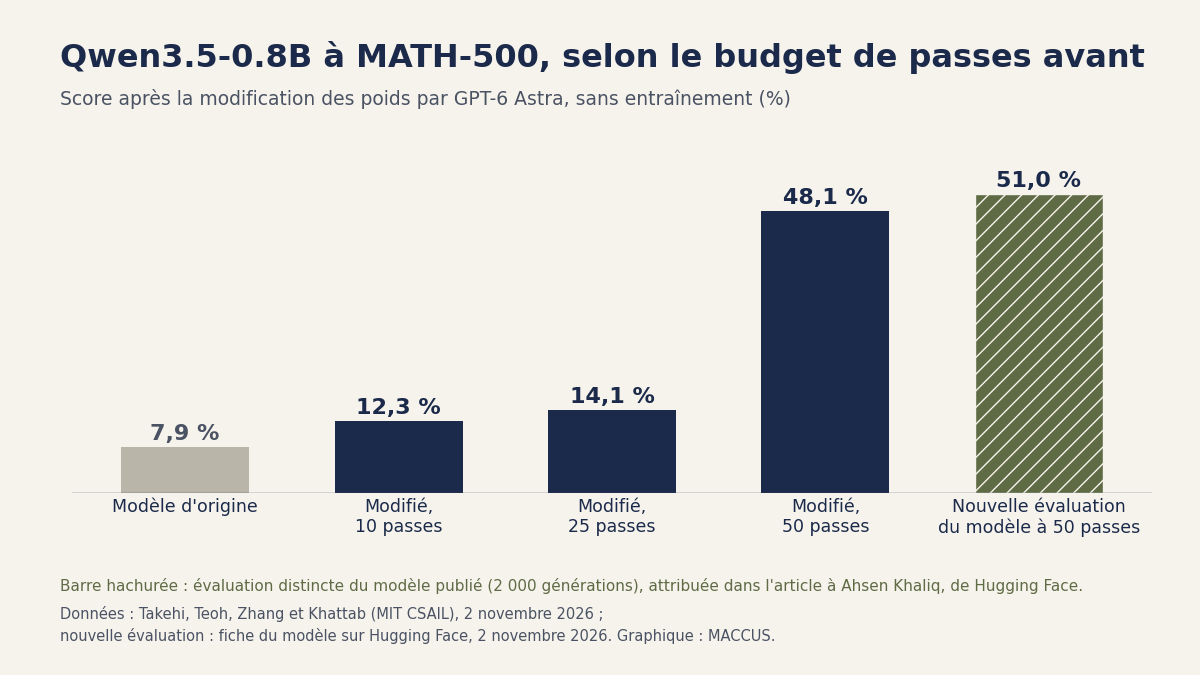
Le modèle modifié a été mis en ligne sur Hugging Face tard le 2 novembre. Sa fiche rapporte une nouvelle évaluation, que le billet attribue à Ahsen Khaliq, de Hugging Face, sur les 500 problèmes de MATH-500, quatre réponses par problème : 2 000 générations en 51 minutes sur une Nvidia H200. Le modèle obtient 51,0 %, et 31,6 % de ses réponses atteignent la limite. Seuls deux tenseurs diffèrent de la version de Qwen.
Lire et écrire de plus petits réseaux
Dans la première des huit expériences, Astra a reçu sous forme de texte les poids bruts de quatre réseaux entraînés à jouer, 17 253 pour chacun, et, sans qu’on lui donne de liste, a nommé le bon jeu pour les quatre. Dans la troisième, avec les seules couches centrales de trois petits modèles de langage, il a reconnu la langue d’entraînement de chacun et trouvé toutes les têtes de copie, ces têtes d’attention qui reproduisent un texte déjà vu, par une méthode d’Elhage et ses coauteurs que les auteurs disent ne jamais lui avoir indiquée.
Un réseau de conduite entraîné avec PPO, une méthode d’apprentissage par renforcement très répandue, échouait dans les 256 épisodes de test à faire franchir une rampe à sa voiture. En une seule réponse, sans outil, Astra a modifié 3,5 % de ses 171 664 poids, et la voiture a réussi les 1 024 épisodes d’évaluation.
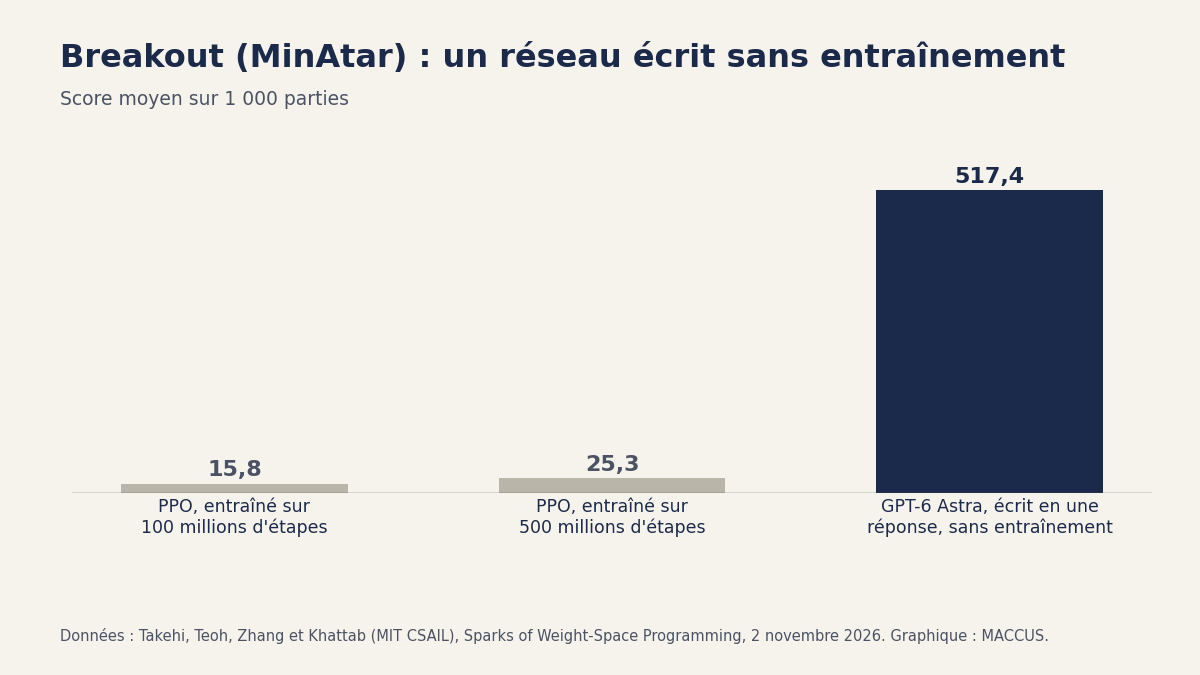
Pour trois jeux de la suite MinAtar, Astra a écrit des réseaux de toutes pièces en une seule réponse, sans données, sans fonction de perte, sans gradient ni outil, et aucun n’avait joué avant d’être noté. Les trois battent des réseaux PPO entraînés sur 100 millions d’étapes. À Breakout, le réseau d’Astra marque 517,4 points, contre 25,3 pour PPO après 500 millions d’étapes, environ 20 fois plus. À Seaquest, il atteint 60 % du score de ce PPO, et à Asterix il s’en approche.
Le plus grand réseau écrit de toutes pièces joue au go sur un plateau de 9 x 9. Ses 1 480 274 poids partaient tous de zéro, et Astra les a fixés dans un bac à sable Python, sans bibliothèque de go, sans internet et sans entraînement. Avec 50 passes avant, il bat le réseau PPO de même taille entraîné sur 20 millions de parties.
Un essai parallèle avec Claude
Le 2 novembre aussi, Chandan Singh a mis la même idée à l’épreuve sur de petites tâches aux solutions connues. Claude, en agent de programmation autonome, a reçu un transformeur vierge et l’interdiction de tout entraînement. Sur 13 tâches, il a écrit 959 programmes dans l’espace des poids, et les dix tâches algorithmiques ont atteint 100 % de précision en trois tentatives au plus.
Le compte rendu, informel, porte sous la signature de Singh la note « Sorry for the AI writing! » (désolé pour la rédaction par IA). Ces tâches simples, menées avec un autre modèle, ne confirment pas le résultat sur Qwen.
Les limites reconnues par les auteurs
Le billet n’a pas été relu par des pairs, et aucun article n’était paru sur arXiv aux premières heures du 3 novembre. Les auteurs parlent de « résultats très préliminaires » et jugent ces capacités « enthousiasmantes mais encore limitées ». Le plus grand réseau modifié par Astra compte 0,8 milliard de poids, une fraction d’un modèle de pointe, et le réseau de go n’a été comparé qu’à des réseaux PPO, sans essai face à un moteur de haut niveau ou à un humain.
Deux tests ont échoué. Face aux poids de deux copies affinées de Gemma 3 270M, de Google, dont l’une entraînée à reprendre la réponse suggérée par l’utilisateur, Astra n’a pas su désigner le modèle flagorneur en quatre tentatives ; il ne l’a reconnu qu’une fois autorisé à voir les schémas d’attention. Chargé d’améliorer en maths ce même modèle, qui tourne rarement en boucle, Astra a gagné un point au mieux sur MATH-500, de 6,8 % à 7,7 %.
Les auteurs écrivent : « Modifier les poids a pu lever un obstacle qui masquait une capacité, mais pas ajouter une capacité qui manquait au modèle. » Le score de 51,0 %, publié sur la page Hugging Face des auteurs eux-mêmes et obtenu par une personne qu’ils remercient dans le billet, vérifie le modèle publié ; la méthode elle-même reste sans examen extérieur.
Le dépôt d’Anthropic à la SEC, le même jour
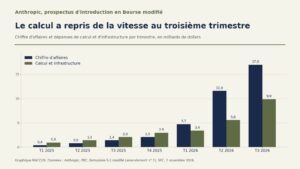
Le 2 novembre, Anthropic a remis à la SEC une version amendée de son S-1. L’entreprise écrit dans ses facteurs de risque que « nos estimations internes et nos attentes concernant de futurs modèles, plutôt que nos modèles actuels, indiquent que nous pourrions atteindre de manière imminente la définition, dans notre Responsible Scaling Policy, d’un “progrès considérablement accéléré attribuable à l’IA” ». Le même passage indique que, par le passé, elle n’a repéré une accélération significative de son rythme de développement qu’après coup, et que cela pourrait se reproduire.
Le billet du MIT, qui ne mentionne pas Anthropic, n’aborde ce thème qu’une fois, comme usage possible : un modèle capable d’améliorer ses propres poids, « ou ceux d’un modèle plus récent », offrirait selon les auteurs « une voie plus riche, plus native » vers l’auto-amélioration récursive. Aucune expérience ne montre un modèle qui se modifie lui-même : Astra a travaillé sur d’autres réseaux, bien plus petits.
Notre analyse
Cet automne, plusieurs résultats de l’IA en science étaient vérifiables par des chercheurs, comme la preuve, trouvée par GPT-6 Astra, d’une conjecture vieille de 24 ans ou les contre-exemples à une conjecture de 1967 sur la fusion. Les travaux du MIT braquent le même type d’outil sur l’IA elle-même, sur la partie d’un modèle qu’un optimiseur écrit presque toujours. Astra a lu un réseau qu’il n’avait pas entraîné, remonté à l’origine d’un défaut documenté par son éditeur et fait passer de 93 % à 33 % la part des réponses de maths bloquées à la limite.
La démonstration reste étroite : lectures de poids, réparations et réseaux écrits de toutes pièces, sur des modèles de 0,8 milliard de poids au plus. Les auteurs espèrent davantage, notamment repérer des portes dérobées dans des poids, optimiser à moindre coût et ajouter ou retirer des compétences sans nouvelles données.
Un modèle qui en modifie un autre directement, sans entraînement, irait plus loin que l’écriture de code, où la part de l’IA se mesure déjà : selon GitHub, des agents IA ont lancé plus de 40 % des pull requests de la plateforme en septembre.
Les prochains repères : le banc d’essai et l’environnement de test que les auteurs disent préparer, un article relu par des pairs, des reproductions sur de plus grands modèles par d’autres équipes, et l’éventuelle annonce d’un laboratoire utilisant un LLM pour modifier les poids de ses propres modèles en production.
Sources
- Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights, Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab, MIT CSAIL, 2 novembre 2026
- RikiyaT/lm_understand-logs, Rikiya Takehi, GitHub, 29 octobre 2026
- Qwen3.5-0.8B, edited by an LLM with no training (Weight-Space Programming), fiche du modèle sur Hugging Face, 2 novembre 2026
- Qwen3.5-0.8B, Qwen (Alibaba), fiche du modèle sur Hugging Face, 2 mars 2026
- Weight-Space Programming from scratch on simple tasks, Chandan Singh, 2 novembre 2026
- Anthropic, PBC, Form S-1/A (Amendment No. 1), Anthropic, PBC, SEC EDGAR, 2 novembre 2026
Image d’en-tête : graphique MACCUS, données de Takehi, Teoh, Zhang et Khattab (MIT CSAIL), Sparks of Weight-Space Programming, 2 novembre 2026