Le 12 novembre 2026, l’entreprise italienne Domyn a publié un billet technique sur EUROPA, le modèle d’IA ouvert que la Commission européenne lui a confié en juin. Elle y décrit ses essais d’entraînement d’un modèle de près de 1 000 milliards de paramètres sur un supercalculateur public.
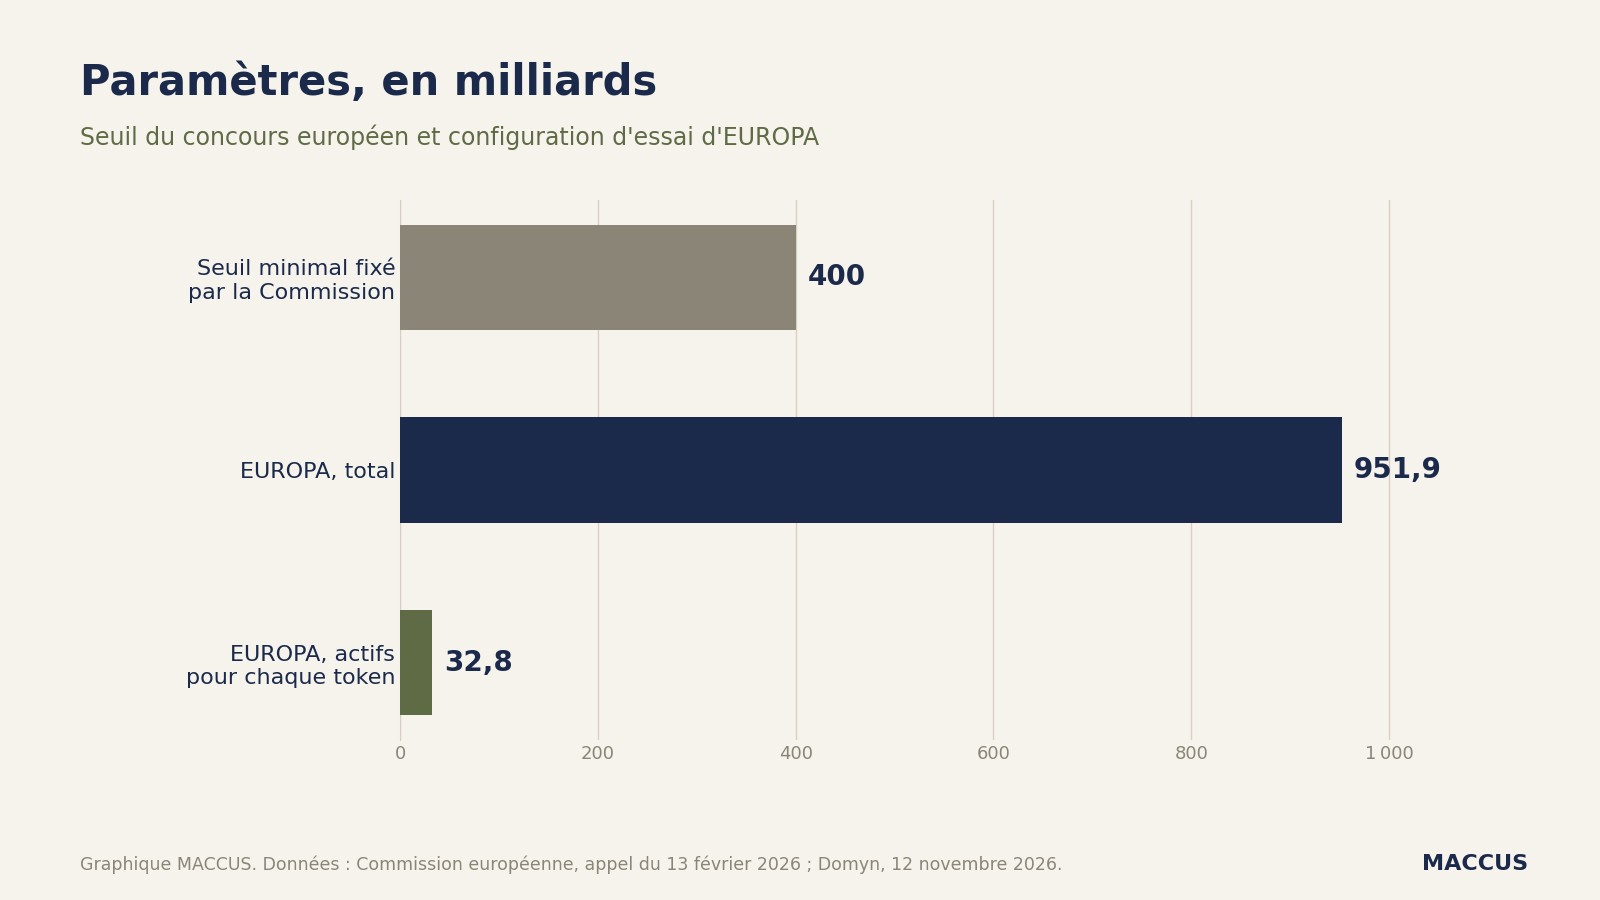
Les paramètres sont les réglages internes qu’un modèle apprend pendant son entraînement. Dans sa configuration d’essai, EUROPA en compte 951,9 milliards. Ce supercalculateur, JUPITER, est installé à Jülich, en Allemagne, et partagé avec des centaines d’autres projets. Domyn dit y avoir rendu l’entraînement 14 fois plus rapide qu’à ses débuts sur la machine.
Les poids du modèle, c’est-à-dire les fichiers qui contiennent ses paramètres et permettent de l’installer sur ses propres machines, ne sont pas encore publiés. Domyn promet de les rendre publics à la sortie d’EUROPA, avec le détail de ses méthodes d’entraînement, sans donner de date. En juin, le site Declic Media rapportait que Domyn visait une sortie « dans l’année ».
Un projet choisi par la Commission en juin
Le 13 février 2026, la Commission européenne a lancé le Frontier AI Grand Challenge, un concours organisé avec l’entreprise commune EuroHPC, qui pilote le réseau européen de supercalculateurs publics. Le concours devait retenir un seul projet, chargé d’entraîner un modèle de pointe d’au moins 400 milliards de paramètres. Le lauréat reçoit jusqu’à 2,5 % de la capacité de calcul totale d’EuroHPC, pendant un an.
La Commission attend des modèles ouverts, mis à la disposition des administrations, des chercheurs et des entreprises. Le 19 juin, elle a désigné le lauréat, le consortium EUROPA. Ce groupement est mené par Domyn, une entreprise milanaise anciennement appelée iGenius, avec deux instituts allemands du réseau de recherche Fraunhofer, l’IAIS et l’IIS. Le modèle doit couvrir les 24 langues officielles de l’Union.
« L’Europe peut être en tête de l’IA avancée, à ses propres conditions », a déclaré Henna Virkkunen, vice-présidente exécutive de la Commission chargée de la souveraineté technologique, de la sécurité et de la démocratie.
Une configuration de 951,9 milliards de paramètres
Domyn explique avoir visé environ 1 000 milliards de paramètres, la taille actuelle des modèles de pointe. C’est plus du double du seuil de 400 milliards fixé par la Commission.
EUROPA repose sur une architecture dite « mélange d’experts » : le réseau est découpé en 384 sous-réseaux spécialisés, appelés experts. Seuls 8 d’entre eux travaillent sur chaque token, ou jeton, l’unité de texte que traite le modèle : un mot ou un morceau de mot. Ainsi, 32,8 milliards de paramètres seulement, sur 951,9 milliards, sont actifs pour chaque token, ce qui réduit le calcul nécessaire.
Pendant l’entraînement, le modèle lit des séquences de 65 536 tokens d’un seul tenant. Domyn précise que ces chiffres valent pour ses essais et que « certaines valeurs peuvent changer avant le lancement de l’entraînement ».
JUPITER, une machine conçue pour la science
Selon le centre de recherche de Jülich, JUPITER est le premier supercalculateur européen de classe exaflopique, c’est-à-dire capable de plus d’un milliard de milliards d’opérations par seconde. Il appartient à l’entreprise commune EuroHPC, qui le finance à hauteur de 250 millions d’euros. L’État fédéral allemand et le Land de Rhénanie-du-Nord-Westphalie apportent 125 millions d’euros chacun.
Domyn utilise le module Booster de JUPITER, formé de 5 884 nœuds, des ordinateurs reliés en réseau. Chaque nœud associe quatre puces NVIDIA GH200. Chacune réunit un processeur central et un processeur graphique (GPU), la puce qui fait l’essentiel des calculs d’IA.
Selon Domyn, les modèles de cette taille ont surtout été entraînés jusqu’ici sur des grappes dédiées de puces NVIDIA plus récentes, de génération Blackwell. Sur JUPITER, Domyn n’a qu’un accès d’utilisateur. Elle ne peut modifier ni le système, ni le réseau, ni la mémoire des nœuds, tous réglés pour la simulation scientifique.
L’entraînement peut faire tourner plusieurs copies du modèle en parallèle. Chaque copie occupe 384 GPU répartis sur 96 nœuds, qui doivent échanger des données. Or le lien réseau entre deux nœuds est 36 fois plus lent que celui qui relie chaque GPU à son processeur central.
De 90 à environ 1 300 tokens par seconde et par GPU
Au départ, chaque GPU traitait 90 tokens par seconde et passait l’essentiel de son temps à attendre les données du réseau. Domyn a d’abord allongé les séquences de texte, pour donner aux GPU plus de calcul entre deux échanges. L’équipe a ensuite déplacé une partie des données intermédiaires vers la mémoire du processeur central, pour libérer celle du GPU.
Le calcul le plus lourd de l’optimiseur Muon, l’algorithme qui corrige les paramètres à chaque étape, est passé du processeur central au GPU. L’étape d’optimisation est tombée de 41,7 à 2,2 secondes.
D’autres réglages ont réduit le volume de données envoyé sur le réseau. Les poids des experts, les valeurs de leurs paramètres, circulent compressés au format FP8, sur 8 bits par valeur. Les gradients, les corrections calculées à chaque étape, circulent au format bf16, sur 16 bits par valeur.
Un correctif sur la gestion de la mémoire a augmenté le débit de 21 %. Le débit final atteint 1 293 tokens par seconde et par GPU, contre 90 au départ. Domyn a reversé ses correctifs à PyTorch et TorchTitan, les logiciels libres qui lui servent à entraîner le modèle.
À ce rythme, une copie du modèle traite environ 43 milliards de tokens par jour, selon Domyn. Avec quatre copies en parallèle sur 1 536 GPU, l’entreprise estime le volume à environ 150 milliards de tokens par jour, soit 89 % de la vitesse par GPU obtenue avec une seule copie.
Le quotidien italien Quotidiano Nazionale en déduit que le pré-entraînement complet, la grande phase d’apprentissage sur du texte brut, durerait environ quatre mois.
Les limites de la démonstration
Le billet s’ouvre sur une affirmation : l’entreprise a « récemment commencé l’entraînement » d’un modèle de pointe. Le reste du texte ne décrit pourtant que des essais. Les débits publiés sont des valeurs médianes, mesurées de la 4e à la 10e étape de chaque essai. La configuration peut aussi changer avant le lancement de l’entraînement.
Le Quotidiano Nazionale le résume ainsi : la démonstration « n’équivaut pas encore à l’achèvement de l’entraînement ».
Domyn signale ses propres incertitudes. Une règle qui répartit les tokens à parts égales entre quatre groupes de 96 experts, un par GPU, accélère le calcul. D’après les premiers essais de Domyn, cette règle « peut effectivement nuire à l’entraînement ».
L’entreprise affirme que la compression en FP8 et l’envoi des gradients en bf16 ne modifient pas de façon mesurable l’erreur du modèle, l’écart entre ses prédictions et le texte réel. Ses comparaisons ne portent toutefois que sur dix étapes d’entraînement. Le billet ne dit rien des données d’entraînement, de la part de chaque langue, des performances attendues ni de la licence d’utilisation.
Domyn Edge et les autres projets européens
Domyn a déjà publié un modèle ouvert, beaucoup plus petit : Domyn Edge, diffusé à partir du 20 octobre 2026. Il compte 4 milliards de paramètres. Domyn l’a entraîné sans partir d’un modèle existant, sur 13 000 milliards de tokens. L’entreprise a utilisé Leonardo, un supercalculateur européen hébergé par le centre de calcul CINECA, en Italie.
Domyn Edge est publié sous licence Apache 2.0, une licence libre qui autorise l’usage commercial. La publication comprend aussi une partie des données, le code et des versions intermédiaires du modèle. Le français fait partie de ses cinq langues principales.
Le site Declic Media relevait en juin que l’Europe mène au moins trois projets de grands modèles d’IA dits souverains, développés sous contrôle européen. OpenEuroLLM, un autre projet doté de 37,4 millions d’euros, annonçait des modèles de 7 à 175 milliards de paramètres. Le site soulignait que l’objectif d’EUROPA dépassait tout ce que l’Europe avait tenté jusque-là. L’auteur notait aussi que le modèle de Domyn n’avait alors « pas écrit sa première ligne de poids ».
Notre analyse
Le billet du 12 novembre montre un projet bien plus gros que la commande : la Commission exigeait au moins 400 milliards de paramètres, le consortium en vise environ 1 000 milliards. Ses mesures d’essai indiquent qu’une machine publique partagée, conçue pour la science, peut atteindre une vitesse d’entraînement utilisable à cette échelle. La démonstration reste technique : l’entraînement complet est encore à mener, puis le modèle devra être évalué et publié.
Côté privé, la société française Mistral AI a déjà publié le 29 octobre les poids de Mistral Large 4, un modèle d’environ 1 000 milliards de paramètres. Financée par des capitaux privés, elle dit l’avoir entraîné dans ses propres centres de données en Europe.
Même compressé, EUROPA demanderait beaucoup de mémoire pour tourner en local. Avec la compression courante dans cet usage, à 4 bits par paramètre, ses poids pèseraient au moins 476 Go selon notre calcul, sans compter la mémoire de travail. C’est l’ordre de grandeur de Muse Spark Open, le modèle ouvert de Meta. Ce modèle compte 816 milliards de paramètres et tourne sur deux Mac Studio d’Apple de 512 Go de mémoire chacun.
Plusieurs questions restent sans réponse. Ni la Commission ni Domyn n’ont nommé la licence d’EUROPA. Les données, la place du français, les résultats aux tests de performance et la date de sortie restent inconnus.
L’allocation de calcul d’EuroHPC ne court que sur un an. Trois étapes seront à suivre : le lancement effectif de l’entraînement complet, les comptes rendus que Domyn prévoit de publier « au fil de l’entraînement » et le rapport technique de Domyn Edge, attendu en novembre.
Sources
- Training a 1T-Parameter MoE on EU public infrastructure with PyTorch and TorchTitan, Domyn, 12 novembre 2026
- Training a 1T-Parameter MoE on EU public infrastructure with PyTorch and TorchTitan, PyTorch, 12 novembre 2026
- Commission selects EUROPA consortium as the winner of the Frontier AI Grand Challenge, Commission européenne, 19 juin 2026
- Turning strategy into action: Commission launches Frontier AI Grand Challenge, Commission européenne, 13 février 2026
- JUPITER, Forschungszentrum Jülich, consulté le 15 novembre 2026
- IA, la sfida europea dei supercomputer: testato un modello da quasi mille miliardi di parametri, Quotidiano Nazionale, 13 novembre 2026
- Domyn Edge Base (fiche du modèle), Domyn sur Hugging Face, consulté le 15 novembre 2026
- Europe Names Its 3rd Sovereign LLM, Ships None, Declic Media, 27 juin 2026
Image d’en-tête : graphique MACCUS, données Domyn (billet technique du 12 novembre 2026).