
Six revues de probabilités et de statistique ont suspendu, de façon concertée, les nouvelles soumissions. EDP Sciences a annoncé le 19 octobre 2026 que l’une d’elles, sa revue ESAIM: Probability and Statistics, n’accepte aucune nouvelle soumission du 19 octobre au 8 novembre et rouvre le 9 novembre. L’éditeur invoque « une hausse importante des soumissions de manuscrits dans toute la discipline, due en grande partie au développement rapide de l’intelligence artificielle ».
La pause suit un mois de nouvelles règles. Le 1er octobre, arXiv a annoncé avoir reçu 40 363 soumissions en septembre, près de deux fois plus qu’il y a deux ans, et a limité chaque déposant à deux articles par mois. Plusieurs conférences d’apprentissage automatique plafonnent aussi le nombre d’articles par auteur. Dans le même temps, OpenAI a retiré trois manuscrits rédigés par son modèle à cause d’une erreur de signe, deux mathématiciens ont retrouvé l’origine de cette erreur et deux autres ont réécrit une preuve de la machine pour des lecteurs humains.
Une pause concertée en probabilités
Les six titres cités dans l’annonce d’EDP Sciences sont ESAIM: Probability and Statistics, l’Electronic Journal of Probability, Electronic Communications in Probability, Stochastic Processes and their Applications, Bernoulli et les Annales de l’Institut Henri Poincaré, Probabilités et Statistiques. L’annonce ne précise les dates que pour ESAIM, où seuls les nouveaux articles sont concernés : les versions révisées restent acceptées et les évaluations en cours se poursuivent.
Selon l’éditeur, ce volume exerce « une pression considérable sur les comités de rédaction et les relecteurs » et complique une évaluation par les pairs « rigoureuse et équitable ». Le comité d’ESAIM profitera de ces trois semaines pour revoir le périmètre de la revue et ses consignes sur l’usage de l’IA par les auteurs et les relecteurs.
Le volume d’arXiv a doublé en deux ans
arXiv est le serveur de prépublications ouvert où déposent physiciens, mathématiciens et informaticiens. Dans un billet du 1er octobre, Kat Boboris donne les chiffres de septembre : 9 869 soumissions en 2016, 20 569 en 2024 et 40 363 en 2026, « un nouveau record ». Ce seul mois a valu près de 9 000 demandes d’assistance à l’équipe et aux modérateurs. Les dépôts dans cs.AI, la catégorie de l’intelligence artificielle, ont été multipliés par plus de six en deux ans, et ceux des autres catégories ont doublé.
arXiv attribue une partie de cette hausse aux outils d’IA, qui rendent selon lui « certains aspects de la recherche plus rapides et plus faciles ». Ses modérateurs bénévoles signalent aussi davantage d’articles minces « à la portée étroite », d’articles « salami » qui découpent un même travail en tranches et « une nette augmentation d’articles denses, écrits par l’IA ».
Thomas Dietterich, qui préside le conseil consultatif éditorial d’arXiv, écrit qu’« une proportion relativement faible d’auteurs soumet un grand nombre d’articles de faible qualité » et que les articles des autres « peuvent être retardés de plusieurs jours, voire de plusieurs semaines ». Depuis le 1er octobre, chaque déposant peut envoyer au plus deux articles par mois civil, en plus de la limite existante de trois soumissions actives. arXiv présente la règle comme une solution provisoire, le temps de définir de nouvelles bonnes pratiques pour les auteurs qui utilisent l’IA et d’améliorer ses outils de modération.
Les conférences plafonnent les soumissions par auteur
Les soumissions à ICLR 2027, grande conférence d’apprentissage automatique, « devraient dépasser 62 000, contre 490 il y a dix ans », rapportait Nature le 13 octobre. ICLR acceptera au plus 20 soumissions par auteur, et une seule pour qui n’a jamais eu d’article accepté dans une grande conférence d’IA, sauf si un coauteur remplit cette condition. Jacob Andreas (MIT), président du comité de programme, a dit à Nature vouloir décourager l’envoi d’un « très grand nombre d’articles, généralement générés par l’IA ».
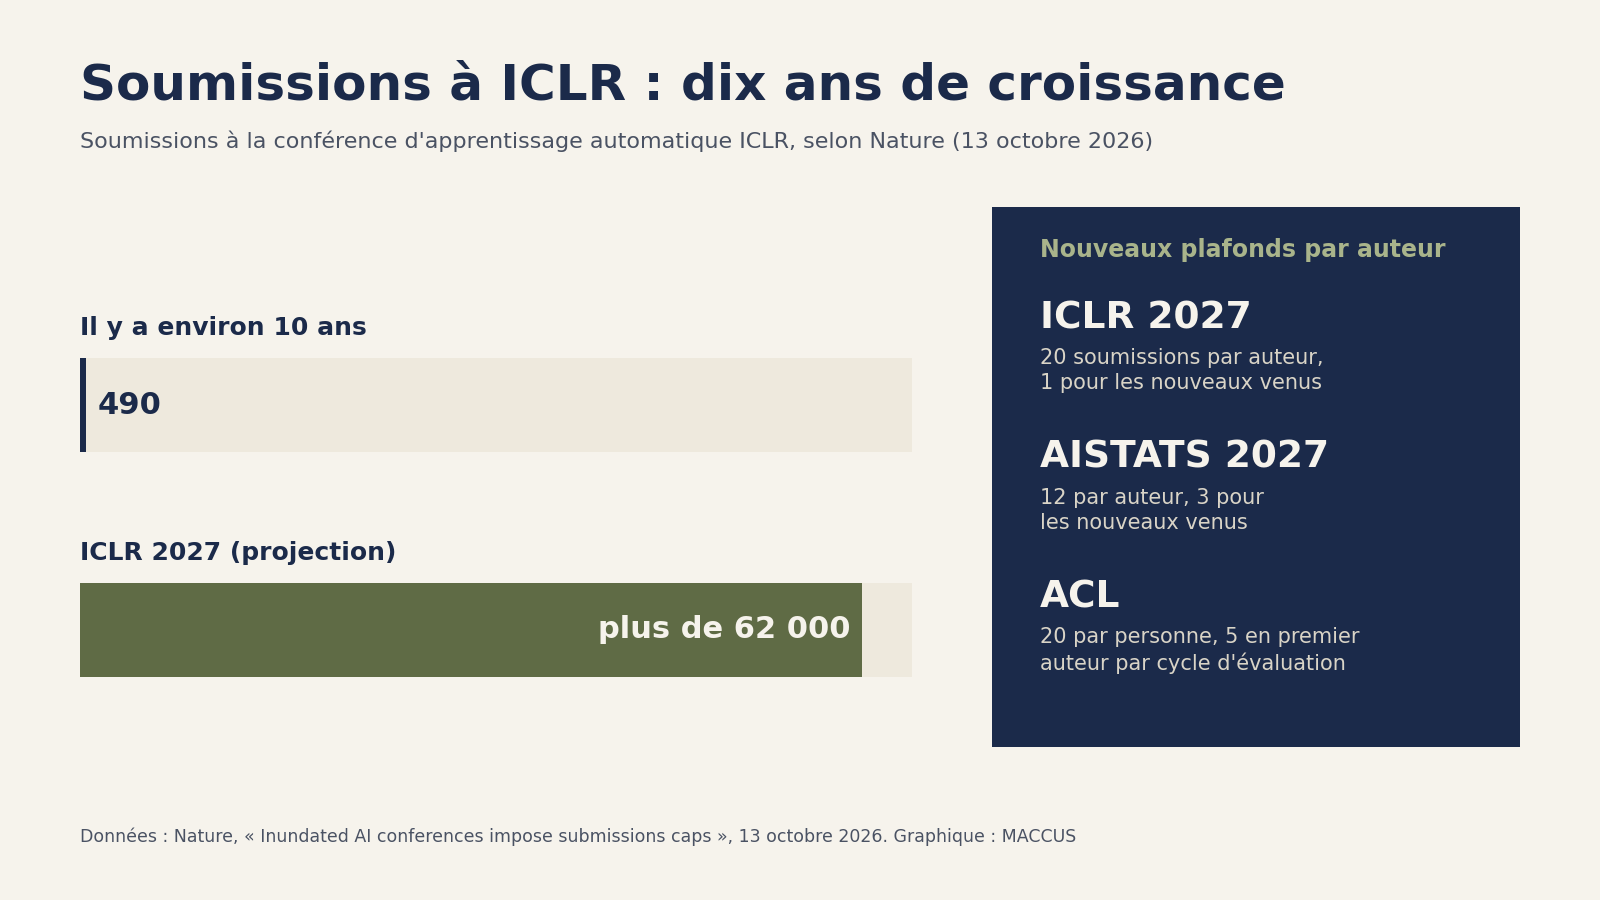
AISTATS 2027 fixe le plafond à 12 soumissions par auteur, 3 pour les nouveaux venus. L’Association for Computational Linguistics en autorise 20 par personne et 5 en premier auteur par cycle d’évaluation, en invoquant un « rythme de soumissions intenable ». La revue Transactions on Machine Learning Research a instauré des quotas en juin, après un triplement de ses soumissions en un an ; celles signées par un seul auteur ont été multipliées par 13.
Des mathématiciens vérifient les preuves de la machine
OpenAI tient une collection publique de 719 manuscrits produits par un modèle interne non commercialisé. Selon l’entreprise, environ 4 000 problèmes ont été soumis au modèle, et chaque résultat a demandé environ trois heures de calcul en mode réflexion de ChatGPT Pro, en moyenne.
Son journal des modifications du 7 octobre mentionne trois manuscrits retirés après qu’une « erreur de signe » a invalidé un argument commun, 14 autres révisés (preuves réparées, énoncés corrigés) et 13 de plus mis à jour pour citer les nouvelles versions. D’après OpenAI, 300 des 719 résultats principaux, soit environ 42 %, disposent désormais d’une preuve formelle en Lean, un assistant de preuve qui vérifie chaque étape par machine. Le 26 octobre, OpenAI a publié un article d’un modèle interne qui affirme réfuter l’hypothèse du temps exponentiel, accompagné d’une preuve en Lean.
Le 22 octobre, Yanki Lekili et Nick Sheridan ont déposé un article de neuf pages qui explique où les trois documents retirés ont fait fausse route. Ces documents, qui affirmaient démontrer des cas de la conjecture de Hodge, butaient tous trois au même endroit. Ils calculaient les signes de certains points d’intersection selon la convention usuelle, alors que le résultat de 2013 dont ils partaient emploie la convention inverse sans le dire. Les deux mathématiciens écrivent néanmoins que l’approche proposée « est intéressante et mérite d’être poursuivie ».
Neuf jours plus tôt, Sang-hyun Kim et Yash Lodha avaient déposé une présentation rédigée par des humains de la preuve d’OpenAI selon laquelle le groupe F de Thompson n’est pas moyennable. Leur note reformule l’argument de la machine à l’usage des spécialistes de la théorie des groupes.
Le 23 octobre, Terence Tao, médaillé Fields et professeur à UCLA, a déclaré à The Observer que les entreprises d’IA « produisent ces preuves épouvantables. D’excellents résultats, mais elles se moquent de l’élégance des solutions, de savoir qui les comprend ou de la suite à leur donner ».
En août, il avait esquissé le problème dans un modèle jouet aux chiffres « inventés », de son propre aveu. Si l’IA ramène le temps de résolution d’un problème de six mois à une journée, alors qu’une rédaction soignée passe seulement d’un mois à trois semaines, « 90 % de la littérature sera désormais mal rédigée », et les revues à comité de lecture traditionnelles « seraient submergées ».
Les réserves des sources elles-mêmes
Aucune de ces institutions ne dit combien des nouveaux articles ont été écrits avec l’IA. arXiv et les revues présentent l’IA comme un moteur de la hausse, sans chiffrer sa part. Les 40 363 soumissions couvrent toutes les disciplines d’arXiv, et les 62 000 d’ICLR restent une projection.
D’après arXiv, une petite part des auteurs envoie beaucoup d’articles de faible qualité et mobilise une part disproportionnée du temps des modérateurs, mais les plafonds s’appliquent à tous. Aylin Yener, de l’université d’État de l’Ohio, citée par Nature, a demandé pourquoi arrêter « un doctorant productif » qui a deux articles à envoyer, alors qu’un laboratoire déjà publié dans de grandes conférences peut en soumettre 20.
Les preuves formelles ne couvrent qu’environ 42 % des résultats principaux d’OpenAI ; les 58 % restants dépendent encore de lecteurs humains. Terence Tao écrit qu’un filtrage plus automatisé par les revues « peut aider un peu ». Il s’attend malgré tout à ce que la part bien sélectionnée de la littérature devienne « une fraction de plus en plus petite d’un océan bien plus vaste de résultats de moindre qualité (quoique souvent techniquement corrects) ».
Notre analyse
Écrire un article est devenu l’étape la moins chère. Le volume mensuel d’arXiv a doublé en deux ans, ICLR 2027 devrait recevoir plus de 62 000 soumissions et six revues ont suspendu les nouveaux dépôts, l’une d’elles pour revoir ses règles sur l’usage de l’IA. La ressource rare est désormais le temps des relecteurs, des modérateurs et de ceux qui formalisent les preuves, et plusieurs travaux mathématiques d’octobre relevaient de cette vérification.
Si la relecture et la preuve formelle se généralisent au même rythme que la génération, le prochain gain de vitesse de la recherche viendra de la vérification, vers laquelle se tournent déjà les outils d’IA. Dans un document de travail de Harvard publié le 22 octobre, trois anciens éditeurs de revues ont préféré, dans des comparaisons à l’aveugle, la relecture écrite par l’IA à celle d’experts humains dans 26 jugements sur 30. La même semaine, Anthropic a indiqué que Claude avait écrit des preuves d’absence de plantage vérifiées par machine pour 123 bibliothèques open source. Quand trois équipes ont déposé début octobre des preuves de la conjecture de Kannan-Lovász-Simonovits obtenues avec l’IA, une formalisation en Lean est apparue sur GitHub en quelques jours.
ESAIM: Probability and Statistics rouvre aux nouveaux articles le 9 novembre, après une révision de ses consignes sur l’usage de l’IA. arXiv indique qu’il suivra l’effet de ses limites et les ajustera si nécessaire. Le journal des modifications d’OpenAI dira si la part formalisée de ses résultats principaux continue de grimper.
Sources
- ESAIM: Probability and Statistics takes action to address increasing manuscript submissions, EDP Sciences, 19 octobre 2026
- Fair Moderation, Equitable Access, and AI: arXiv’s Updated Rate Limit Policy, Kat Boboris, blog d’arXiv, 1er octobre 2026
- Inundated AI conferences impose submissions caps, Dalmeet Singh Chawla, Nature, 13 octobre 2026
- openai/math (README and History), OpenAI, GitHub, journal des modifications du 7 octobre 2026
- Rigidity, flexibility, and a sign error, Yanki Lekili et Nick Sheridan, arXiv:2610.30976, 22 octobre 2026
- A note on the proof of nonamenability of F, Sang-hyun Kim et Yash Lodha, arXiv:2610.18360, 13 octobre 2026
- Terence Tao: AI turns beautiful mathematics into ‘toxic waste’, James Tapper, The Observer, 23 octobre 2026
- Fil sur une variante du paradoxe de Simpson (modèle jouet, 4 messages), Terence Tao, Mathstodon, 27 août 2026
Image d’en-tête : graphique MACCUS, données du blog d’arXiv (1er octobre 2026) et d’EDP Sciences (19 octobre 2026)