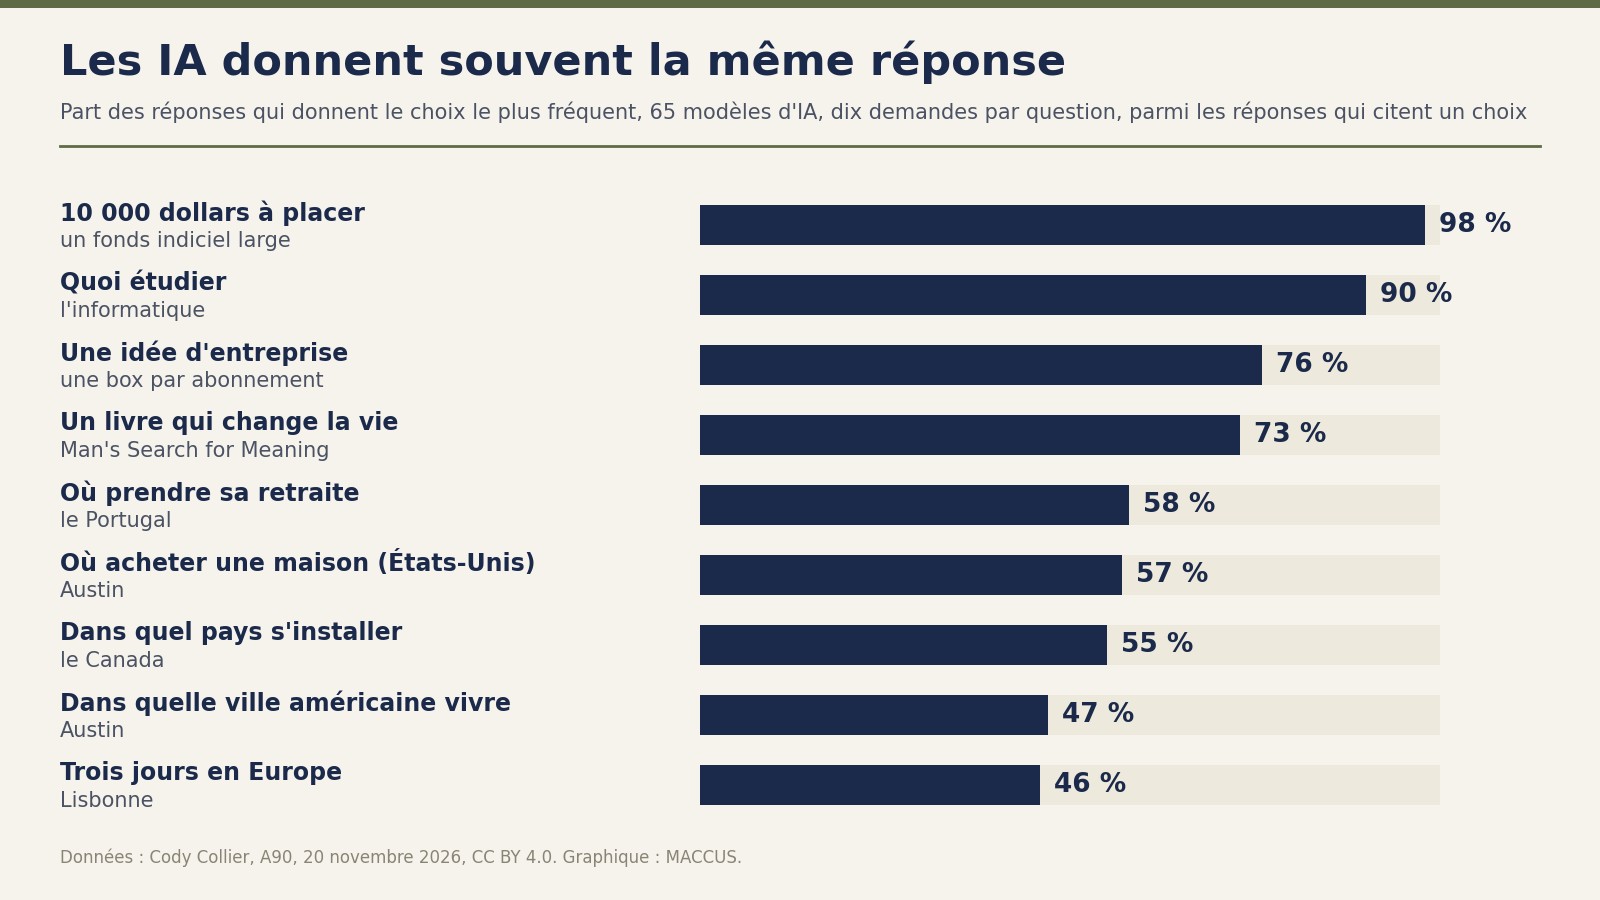
Quand on leur demande un livre qui changera une vie, 65 modèles d’intelligence artificielle citent le même titre dans 73 % des réponses. Il s’agit de Man’s Search for Meaning, de Viktor Frankl. Cody Collier a publié ce test le 20 novembre 2026 sur son site A90. « Chaque réponse semble écrite pour vous, écrit-il. Vous ne voyez jamais tous ceux qui ont reçu la même. »
Le phénomène touche aussi l’argent et le lieu de vie. À la question « où placer 10 000 dollars ? », 98 % des réponses qui font un choix citent un fonds indiciel large, qui suit un grand indice boursier comme le S&P 500. Pour la ville américaine où s’installer, 47 % des réponses qui citent une ville nomment Austin. Une étude distincte, menée sur une application de placement américaine, montre que ce type de conseil est suivi.
Dix demandes par question, souvent la même réponse
Collier a soumis à ces 65 modèles, conçus par 30 entreprises, des questions que les gens posent chaque jour aux chatbots : 127 918 demandes au total. Chaque modèle a reçu chaque question dix fois, via OpenRouter, un service qui donne accès à de nombreux modèles d’IA avec un seul compte.
Il a gardé les réglages par défaut, sans consigne système, ces instructions cachées qu’une application ajoute avant la question de l’utilisateur. Le raisonnement, la réflexion que certains modèles mènent avant de répondre, était désactivé ou réglé au plus bas. Toutes les réponses figurent dans un fichier public sous licence libre CC BY 4.0, où nous avons recompté le chiffre du livre : 472 réponses sur 649.
Même les petites questions obtiennent souvent la même réponse. Pour une idée d’entreprise en une phrase, 76 % des réponses proposent un coffret par abonnement. Pour trois jours de voyage en Europe, 46 % citent Lisbonne.
Les questions qui engagent une vie obtiennent aussi des réponses semblables : 90 % des réponses qui nomment une filière universitaire citent l’informatique. Pour la retraite, 58 % désignent le Portugal, et pour changer de pays, 55 % citent le Canada. Ces parts ne comptent que les réponses qui font un choix : selon la question, les modèles refusent de trancher dans 6 % à 23 % des cas.
Les modèles surestiment leur propre variété
Après chaque réponse, Collier demandait au modèle quelle part des personnes posant la même question recevait la même réponse. Un modèle qui venait de répondre Austin l’a estimée à environ 15 %, alors qu’il avait donné cette ville dans 80 % de ses réponses. Plus de réflexion ne rend pas les réponses plus variées : avec le raisonnement activé, Austin passe de 47 % à 57 % des choix de ville.
Se décrire en une ligne mène seulement au choix par défaut propre à ce profil. Pour un enseignant retraité du New Jersey, 92 % des réponses sur le pays où s’installer citaient le Portugal. Pour un infirmier de l’Ohio avec deux enfants, 82 % citaient le Canada.
La variété n’apparaît qu’à l’intérieur d’une même conversation. Interrogés huit fois de suite dans un seul échange, avec « un autre, s’il te plaît », six modèles ont chacun donné huit livres différents. Dans huit nouvelles conversations, chacun a donné huit fois le même livre.
Les modèles inventent aussi les mêmes personnes. Sur 3 151 personnes « au hasard » qu’ils ont créées, 69 % avaient exactement 34 ans et 81 % étaient des femmes, contre 51 % des adultes américains.
Sur une application de placement, les conseils sont suivis
L’étude sur les investisseurs est un article de recherche de Valerie Baldinger, doctorante à l’école de commerce Stern de l’université de New York, daté de novembre 2026. Son directeur de thèse, le professeur de finance Arpit Gupta, l’a résumé le 9 novembre. Baldinger étudie Mezzi, une application américaine qui regroupe les comptes de placement de ses utilisateurs et propose depuis novembre 2024 un assistant fondé sur ChatGPT et Gemini. Elle a relié 69 598 questions et réponses d’environ 1 900 investisseurs aux opérations qui ont suivi.
Parmi les réponses de l’assistant qui contiennent une recommandation d’achat, 36 % sont suivies de cet achat dans les dix jours de bourse suivants. Après l’adoption de l’assistant, la part des nouveaux investissements placée en fonds indiciels plutôt qu’en actions individuelles augmente de 7,6 points de pourcentage.
VTI, le fonds de Vanguard qui réplique toute la bourse américaine, reçoit 53,9 % des recommandations de l’assistant qui nomment un fonds de sa catégorie. Il ne pèse pourtant que 15,8 % des actifs de cette catégorie.
Le risque propre aux titres achetés, hors variations de l’ensemble du marché, baisse de 11 % à 14 %, et les fonds choisis prélèvent des frais plus bas. Selon l’estimation de Baldinger, le rendement auquel ces investisseurs renoncent faute d’un portefeuille aussi diversifié qu’il pourrait l’être baisse de 43 points de base par an en moyenne, soit 0,43 point de pourcentage.
En décembre 2025, Mezzi a modifié ses consignes cachées pour demander à l’assistant de citer des titres précis quand c’était possible. La part des réponses qui recommandent des fonds est passée de 18,9 % à 34,2 %. Chez les utilisateurs de l’assistant, la part des fonds dans les nouveaux investissements a gagné 8,1 points par rapport aux non-utilisateurs.
En janvier 2026, une nouvelle consigne lui a demandé d’éviter les titres précis. La part des réponses recommandant des fonds est tombée à 4,5 %, et la part des fonds dans les nouveaux investissements a perdu 7,7 points. Les utilisateurs voient rarement ces consignes, comme l’a montré en octobre le chatbot d’assistance de WhatsApp, à qui un texte caché demandait de ne recommander aucune autorité de protection des données.
Les choix par défaut des IA se retrouvent en ligne
Collier a aussi cherché sur GitHub, la principale plateforme de partage de code, les noms inventés par les modèles. « Elena Vance », une personne que les modèles Gemini créent souvent, figure dans la page de présentation, ou README, de 684 nouveaux projets créés en 2026, et d’aucun projet antérieur à 2025. Elena Garcia, un nom réel courant, figure dans 68 nouveaux projets.
Deux travaux distincts retrouvent ces choix par défaut là où ils font des dégâts. Michał Brzozowski et Neo Christopher Chung ont recensé sur Zenodo 1 655 fiches signées par des auteurs qui n’existent pas. Cette archive de recherche, gérée par le CERN, attribue de vrais identifiants de documents. Les fiches portent des dates de publication inventées, et 991 ont été enregistrées en un seul mois.
L’entreprise de sécurité GitGuardian a examiné 34 millions de mots de passe repérés sur GitHub entre novembre 2025 et mars 2026. Elle en a classé environ 28 000 comme écrits par des modèles d’IA ; selon elle, ces mots de passe suivent des motifs communs et sont donc prévisibles.
Les limites du test et de l’étude
Le test de Collier est le travail d’une seule personne, publié sur son propre site, sans relecture par des spécialistes extérieurs. Chaque modèle a été interrogé chez un seul fournisseur et peut répondre autrement ailleurs ou après une mise à jour, précise-t-il. Les applications grand public ajoutent leurs propres consignes et une mémoire des échanges passés, ce qui peut changer la réponse.
Le test mesure ce que répondent les modèles, et seule l’étude de Baldinger mesure ce que font les gens, chez les clients d’une seule application. Ces investisseurs sont plus aisés que la plupart des détenteurs d’actions américains. Leur portefeuille médian atteint 555 700 dollars, contre 155 000 dollars pour ceux de l’enquête de 2022 de la Réserve fédérale sur les finances des ménages. Ce travail de doctorat, que Baldinger présente pour obtenir un premier poste, n’a pas encore été relu par des pairs.
Une même réponse n’est pas forcément mauvaise, note Collier : « pour certaines questions, comme celle de savoir où placer 10 000 dollars, la même réponse peut être la bonne ». Le constat rejoint une étude antérieure, Artificial Hivemind, présentée en séance orale à NeurIPS 2025, l’un des principaux congrès de recherche en IA. Sur 26 000 vraies questions ouvertes d’utilisateurs, elle montre que chaque modèle se répète et que les modèles se ressemblent encore plus entre eux.
Notre analyse
À l’échelle où les chatbots sont utilisés, leur réponse la plus fréquente peut devenir un choix par défaut pour toute une société : un livre, une ville, une filière, un fonds. En septembre 2025, OpenAI indiquait 700 millions d’utilisateurs hebdomadaires pour ChatGPT ; 49 % de leurs messages servaient à demander une information ou un conseil. La moitié des jeunes qui utilisent l’IA chaque jour s’en sont déjà servis comme d’un ami, selon Gallup, et les devoirs scolaires sont passés de Wikipédia à ChatGPT.
Pour l’argent, le choix par défaut est un bon conseil et il est suivi ; Baldinger estime qu’il réduit les frais et le rendement perdu. Pour le lieu de vie, les modèles désignent Austin dans près de la moitié des choix de ville, et aucun des travaux cités ne dit si les gens le suivent. L’épisode Mezzi montre aussi que celui qui écrit les consignes peut déplacer ce choix. « Aujourd’hui, il se trouve que les modèles recommandent Vanguard, écrit Gupta, mais que se passera-t-il quand tout le monde aura intégré les intérêts commerciaux en jeu ? »
Dans la dernière série de Collier, des détails personnels précis, comme « J’ai 43 ans, je suis hygiéniste dentaire à Leeds », font passer de 34 % à 4 % la probabilité qu’un inconnu obtienne la même réponse. Demander dix options puis en choisir une la ramène à 7 %. Ajouter « Ne me donne pas la réponse la plus courante » envoie tout le monde vers le même second choix : Ljubljana, pour 58 % des réponses sur le voyage. Pour l’instant, selon le test, la variété dépend de ce que tape chaque utilisateur.
Sources
- AI is giving everyone the same advice, Cody Collier, A90, 20 novembre 2026
- Generative AI and Retail Investment, Valerie Baldinger, Stern School of Business (université de New York), job market paper, novembre 2026
- Your Portfolio on AI, Arpit Gupta, Arpitrage, 9 novembre 2026
- The Ghost Couple: Correlated LLM Name Priors and Their Haunting of the Web and Academic Publishing, Michał Brzozowski et Neo Christopher Chung, arXiv, 1er juin 2026, révisé le 29 juillet 2026
- The Bot Left a Fingerprint: Detecting and Attributing LLM-Generated Passwords, GitGuardian, 28 avril 2026
- Artificial Hivemind: The Open-Ended Homogeneity of Language Models (and Beyond), Liwei Jiang et al., arXiv, NeurIPS 2025, 27 octobre 2025
- How people are using ChatGPT, OpenAI, 15 septembre 2025