
Sur les offres grand public, la plupart des assistants d’IA peuvent se servir de vos conversations pour entraîner leurs prochains modèles, tant que vous ne le refusez pas dans les réglages. Sur la plupart des offres professionnelles, c’est l’inverse : l’éditeur s’engage à ne pas le faire par défaut. Dans une entreprise, tout dépend donc du compte avec lequel chaque personne utilise l’outil.
Le tableau ci-dessous couvre onze outils courants dans une PME : ChatGPT, Claude, Gemini, Microsoft Copilot, Perplexity, Mistral, Notion AI, DeepL, LinkedIn, GitHub Copilot et Grammarly. Chaque ligne a été vérifiée le 10 octobre 2026 sur les pages officielles de l’éditeur. Suivent les limites d’un refus, la question des comptes personnels utilisés au travail (le shadow AI) et une liste de contrôle à copier. Pour les pages publiques de votre site, le refus de l’entraînement s’exprime dans le robots.txt, avec la ligne Content Signals décrite dans notre guide d’un site prêt pour les agents IA.
Compte personnel ou compte professionnel : la règle de base
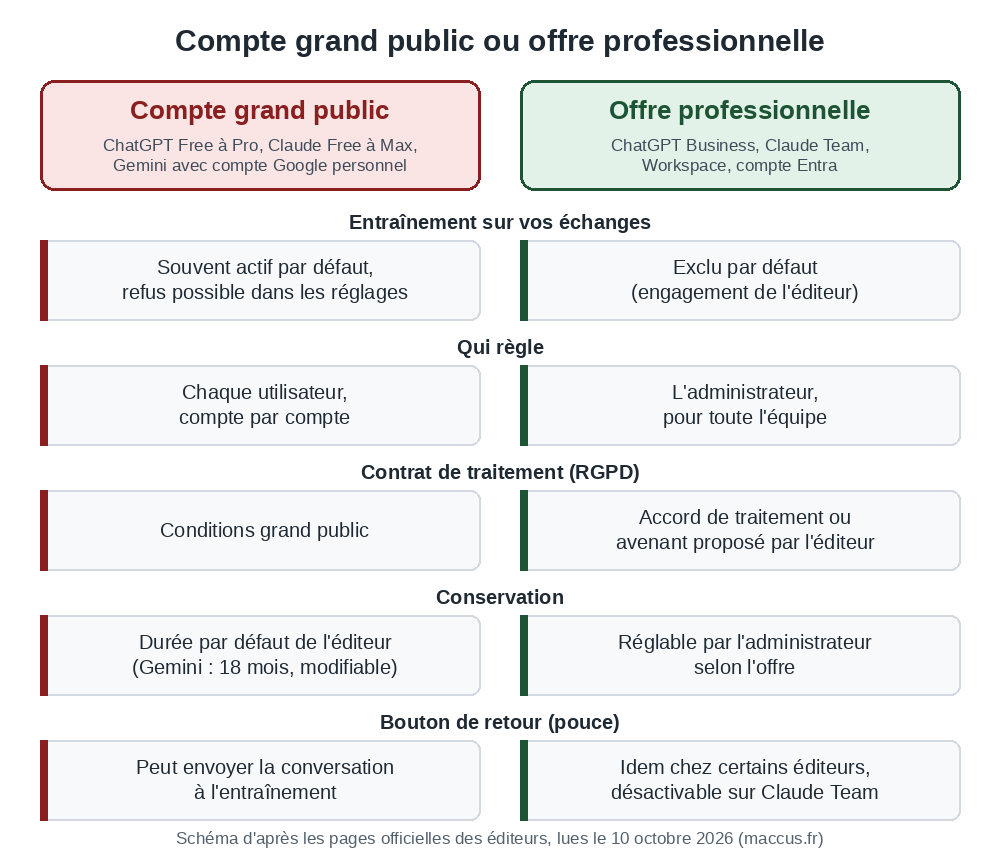
Le prix payé ne change pas la catégorie. Chez OpenAI, ChatGPT Plus et Pro font partie des services pour les particuliers, comme la version gratuite. Chez Anthropic, Claude Pro et Max sont des offres grand public. Gemini utilisé avec un compte Google personnel relève de l’avis de confidentialité des applications Gemini, abonnement Google AI compris.
Les offres professionnelles reposent sur d’autres engagements. OpenAI écrit qu’il n’utilise pas par défaut les données de ChatGPT Business, Enterprise et Edu, ni celles de son API, pour entraîner ses modèles. Anthropic dit la même chose de Claude for Work (Team et Enterprise) et de son API. Google place Gemini dans Workspace sous l’avenant relatif au traitement des données dans le cloud, et Microsoft exclut de l’entraînement les comptes professionnels Entra.
OpenAI propose en plus un accord de traitement des données (DPA) pour Business, Enterprise et l’API : c’est le contrat que le RGPD exige dès qu’un prestataire traite des données personnelles pour votre compte.
La CNIL trace la même ligne de partage dans ses questions-réponses sur l’IA générative. Pour des usages non confidentiels, l’utilisation d’un service grand public « pourra être envisagée » avec des adresses électroniques professionnelles dédiées, en évitant les comptes ouverts avec des adresses personnelles, et en désactivant si possible la réutilisation des données d’usage par le fournisseur. Dès qu’il s’agit de données de clients ou de salariés, ou de documents stratégiques, elle juge généralement « plus opportun et plus sécurisé » un déploiement sur site. Notre guide de l’IA locale en entreprise détaille cette option, matériel et coûts compris.
Le tableau des réglages, outil par outil
Méthode : chaque ligne vient de la page d’aide, de confidentialité ou de documentation de l’éditeur, lue le 10 octobre 2026. Les noms de menus sont ceux de ces pages, souvent en anglais ; l’interface française peut les traduire autrement, et nous n’avons pas cliqué dans chaque interface. Si un menu ne correspond pas, cherchez le réglage par son nom. Le tableau est relu chaque trimestre et à chaque changement de règles annoncé par un éditeur ; la date de vérification affichée fait foi.
Vérifié le 10 octobre 2026 sur les pages officielles de chaque éditeur (liste sous le tableau).
| Outil et offre | Entraînement sur vos données | Comment refuser | Conservation et remarques |
|---|---|---|---|
| ChatGPTFree, Go, Plus, Pro | Oui par défaut Oui, sauf refus. | Paramètres > Data controls : désactiver « Improve the model for everyone », ou choisir « Do not train on my content » sur privacy.openai.com. | Discussions supprimées effacées sous 30 jours, sauf raison de sécurité ou obligation légale. Discussions temporaires : jusqu'à 30 jours. |
| ChatGPTBusiness, Enterprise, Edu, API | Non par défaut Non par défaut. | Rien à régler pour l'entraînement. L'administrateur règle la conservation. | Business, Enterprise, Edu : durée fixée par l'administrateur, conversations supprimées effacées sous 30 jours sauf obligation légale. API : entrées et sorties gardées 30 jours au plus. |
| ClaudeFree, Pro, Max | À choisir Seulement si vous l'acceptez (question posée à l'inscription), hors retours (pouce) et conversations signalées par les filtres de sécurité. | Paramètres > Confidentialité : « Help improve our AI models » (appelé aussi « Model Improvement »). Les discussions Incognito ne servent jamais. | Conversation supprimée : retirée de l'historique tout de suite, effacée des serveurs sous 30 jours. Entraînement accepté : jusqu'à 5 ans sous forme dé-identifiée. |
| ClaudeTeam, Enterprise, API | Non par défaut Non par défaut, sauf retours envoyés (pouce, bug). | Les propriétaires peuvent retirer le bouton de notation : « Rate chats », dans Organization settings > Data and Privacy. | API : effacement sous 30 jours. Team et Enterprise : conversation supprimée effacée sous 30 jours ; durée personnalisable en Enterprise. |
| GeminiCompte Google personnel, avec ou sans abonnement Google AI | Oui par défaut Oui : « Conserver l'activité » est activé par défaut dès 18 ans, et des réviseurs humains lisent une partie des discussions. | gemini.google.com > Activité > Désactiver. Les discussions temporaires ne servent pas à l'entraînement. | 18 mois par défaut (3 mois, 36 mois ou sans limite au choix). Réglage coupé : 72 heures. Discussions relues par des humains : jusqu'à 3 ans, dissociées du compte. |
| GeminiGoogle Workspace (compte professionnel) | Non par défaut Non : pas d'entraînement hors de votre domaine sans autorisation, pas de relecture humaine. | Rien à régler pour l'entraînement. L'administrateur Workspace gère l'historique. | Application Gemini : jusqu'à 36 mois selon l'administrateur. Gemini dans Gmail ou Docs : de 90 jours à sans limite. |
| Microsoft CopilotCompte Microsoft personnel, application mise à jour (depuis le 18 août 2026) | Non par défaut Non : invites, réponses et fichiers ne servent pas à entraîner les modèles de fondation. | Rien à régler pour l'entraînement. Mémoire : Paramètres > Personnalisation. | Pas de durée publiée : conversations supprimables une à une ou en bloc (tableau de bord de confidentialité). Ancienne application non mise à jour : entraînement possible sauf refus, historique gardé 18 mois par défaut. |
| Microsoft 365 CopilotCompte professionnel (Entra) | Non par défaut Non : requêtes, réponses et données Microsoft Graph exclues de l'entraînement des modèles de base. | Rien à régler. Rétention réglable par l'administrateur dans Microsoft Purview. | Selon les règles de conservation de l'organisation. |
| PerplexityFree, Pro, Max | Oui par défaut Oui : « AI data retention » est activé par défaut, selon le centre d'aide de Perplexity. | Paramètres > Preferences : désactiver « AI data retention ». Le refus vaut pour les données collectées ensuite. | Pas de durée publiée : « aussi longtemps que nécessaire » selon l'avis de confidentialité. |
| PerplexityEnterprise | Non par défaut Jamais, selon le centre de confiance de Perplexity. | Rien à régler. | Selon le contrat. |
| Mistral Vibe (ex-Le Chat)Gratuit et Pro | Oui par défaut Oui, sauf refus. | Admin > Vibe > Privacy : couper « Allow your interactions to be used to train our models ». Mobile : Settings > Data & Account Controls, décocher « Enable data sharing ». | Conversation supprimée : retirée après un court délai de grâce, sans durée publiée. Pas de « zéro conservation » sur Vibe. |
| Mistral VibeTeam, Enterprise | À choisir Team : l'administrateur peut couper l'entraînement pour toute l'organisation. Enterprise : non par défaut. | Admin > Vibe > Privacy. L'API (Mistral Studio) a son propre réglage : « Anonymous improvement data ». | Comme ci-dessus. « Zéro conservation » possible seulement sur l'API en paiement à l'usage, sur demande acceptée. |
| Notion AIToutes les offres | Non par défaut Non : les contrats de Notion interdisent à ses sous-traitants d'IA d'entraîner leurs modèles sur vos données. | Rien à régler. | Chez les fournisseurs de modèles : aucune conservation (Enterprise), 30 jours au plus (autres offres). Page supprimée : récupérable 30 jours, puis effacée. |
| DeepLTraducteur et Write gratuits | Oui par défaut Oui : les textes servent à entraîner les réseaux de DeepL, et ses conditions interdisent d'y saisir des données personnelles. | Pas de réglage : passer à une offre DeepL Pro. | DeepL Pro : textes effacés une fois la traduction livrée, jamais utilisés pour améliorer le service. |
| LinkedInComptes membres | Oui par défaut Oui, sauf opposition : profil, contenus et saisies dans les fonctions d'IA. Messages privés exclus. | Préférence « Données pour l'amélioration de l'IA générative ». Les commentaires envoyés à LinkedIn restent utilisables. | Saisies dans les fonctions d'IA gardées jusqu'à ce que vous les supprimiez. |
| GitHub CopilotFree, Pro, Pro+, Max | Oui par défaut Oui depuis le 24 avril 2026, sauf refus : entrées, sorties, extraits de code et contexte. | Photo de profil > Copilot settings : « Allow GitHub to use my data for AI model training » sur Disabled. | Copilot Business et Enterprise : jamais d'entraînement (accord de protection des données), le réglage n'apparaît pas. |
| GrammarlyFree, Premium, Pro à un utilisateur | Oui par défaut Oui, sauf refus, y compris les textes traités par les fonctions d'IA générative. | Free et Premium : account.grammarly.com/security/privacy. Pro à un utilisateur : account.grammarly.com/admin/data_settings. Réglage « Product Improvement and Training ». | Comptes d'équipe achetés en ligne : activé au départ, l'administrateur peut le couper pour toute l'organisation. Comptes Business, Education, Pro et Enterprise achetés auprès de l'équipe commerciale : désactivé par défaut. Les statistiques d'écriture peuvent servir dans tous les cas. |
Oui par défaut : vos échanges peuvent servir à entraîner les modèles tant que vous ne le refusez pas. Non par défaut : l’éditeur s’engage à ne pas le faire sans votre accord. À choisir : la décision revient à l’utilisateur ou à l’administrateur.
Sources consultées le 10 octobre 2026 : OpenAI, contrôles des données de ChatGPT, utilisation des données pour améliorer les modèles et confidentialité des entreprises ; Anthropic, centre de confidentialité (offres grand public, offres commerciales, conservation) ; Google, avis de confidentialité des applications Gemini et guide de confidentialité de Workspace ; Microsoft, Copilot pour les particuliers et Microsoft 365 Copilot ; Perplexity, avis de confidentialité et centre de confiance ; Mistral, refus de l’entraînement ; Notion ; DeepL ; LinkedIn ; GitHub ; Grammarly. Pour le shadow AI : CNIL, Ipsos et Greenworking, Netskope (rapport mondial 2026, rapport Europe 2026) ; pour Mistral Vibe, l’annonce du 28 mai 2026.
Deux lignes ont bougé cette année. Microsoft a sorti le 18 août 2026 une nouvelle application Copilot dont les échanges ne servent pas à entraîner les modèles de fondation ; l’ancienne version, tant qu’elle n’est pas mise à jour, garde l’entraînement par défaut avec possibilité de refus. GitHub, à l’inverse, utilise depuis le 24 avril 2026 les échanges des offres Copilot Free, Pro, Pro+ et Max pour entraîner ses modèles, sauf refus. Mistral a de son côté renommé Le Chat en Vibe le 28 mai 2026, en conservant abonnements, historiques et réglages : les options se trouvent désormais sous ce nom.
Un refus suffit-il ?
Le bouton de retour passe outre. OpenAI écrit qu’un pouce levé ou baissé, envoyé après un refus, peut faire entrer la conversation entière dans l’entraînement. Anthropic garde la conversation liée à un retour jusqu’à cinq ans, détachée de votre identifiant, et peut s’en servir pour entraîner ses modèles, offres professionnelles comprises.
Mistral applique cette règle des retours à tous ses abonnements, et LinkedIn exclut de sa préférence les commentaires que vous lui envoyez. Sur Claude Team et Enterprise, les propriétaires de l’organisation peuvent retirer ce bouton.
Un refus ne retire rien des modèles déjà entraînés : Anthropic, LinkedIn et Perplexity le précisent. Chez OpenAI et Perplexity, il vaut pour les échanges suivants ; Anthropic et LinkedIn cessent en plus de puiser dans vos anciennes données pour les entraînements à venir. Chez Anthropic, le choix est posé à l’inscription depuis l’annonce du 28 août 2025, et il se modifie à tout moment dans les paramètres.
Après un refus, une partie des échanges reste conservée. OpenAI garde les discussions temporaires jusqu’à 30 jours pour des raisons de sécurité. Google conserve 72 heures les discussions Gemini quand « Conserver l’activité » est coupé, et sa page précise que des réviseurs humains peuvent alors les lire pour la sécurité. Anthropic garde jusqu’à deux ans les échanges que ses systèmes signalent comme contraires à sa politique d’utilisation.
Certains réglages vont par deux. Chez OpenAI, Codex a son propre réglage (« Include environments ») pour le contexte des environnements de code, et la mémoire de ChatGPT se règle à part : OpenAI la présente comme un réglage distinct de l’entraînement.
Les réglages vont aussi par deux chez Mistral : l’interrupteur de Vibe et celui de l’API sont indépendants. Anthropic exclut de l’entraînement le contenu brut lu par les connecteurs, comme un fichier Google Drive ; la conversation elle-même reste concernée si l’entraînement est accepté. Avant de brancher un assistant sur la messagerie ou l’agenda, notre guide des connecteurs MCP pour PME aide à distinguer lecture seule et écriture.
Sur une offre grand public, enfin, le réglage est personnel. Rien ne garantit que chaque salarié l’a coupé, ni qu’il l’a fait sur chaque navigateur où il utilise ChatGPT sans être connecté (le choix est alors enregistré dans ce navigateur seulement). Seule une offre gérée par un administrateur fixe la règle pour toute l’équipe.
Le shadow AI : les comptes personnels au travail
On parle de shadow AI, ou d’IA fantôme, quand des salariés se servent d’outils d’IA hors du cadre fixé par l’entreprise, le plus souvent avec un compte personnel. L’éditeur de sécurité Netskope le définit comme l’usage de l’IA qui se fait hors de la vue et du contrôle de l’organisation.
En France, l’Observatoire Greenworking x Ipsos bva, mené du 12 au 25 mai 2026 auprès de 1 100 salariés du privé, mesure l’écart. 73 % des salariés utilisent l’IA au travail, 45 % disent qu’elle est officiellement déployée dans leur entreprise, et seuls 37 % des utilisateurs passent systématiquement par des outils homologués. Plus de six utilisateurs sur dix sortent donc, au moins de temps en temps, du cadre prévu, comme le relève Ipsos.
Les relevés de Netskope, tirés des données d’usage agrégées d’une partie de ses clients européens entre mars 2025 et mars 2026, montrent la même tendance. Dans son rapport publié le 25 mai 2026, la part des utilisateurs d’IA passant par une application personnelle est tombée de 79 % à 43 % en un an, celle des outils gérés par l’organisation est montée de 28 % à 72 %. Les infractions aux règles de protection des données, sur les applications d’IA et de stockage personnelles, portent d’abord sur des données réglementées (59 %), puis sur du code source (15 %), de la propriété intellectuelle (13 %) et des mots de passe ou clés d’API (12 %). À l’échelle mondiale, son rapport de janvier 2026 compte en moyenne 223 incidents par mois et par organisation, le fait de 3 % des utilisateurs d’IA.
Chaque compte personnel ramène les valeurs par défaut des lignes grand public du tableau : entraînement souvent actif, aucun contrat entre l’entreprise et le fournisseur, personne pour fixer la durée de conservation. Quand un salarié colle le dossier d’un client dans ce compte, l’entreprise reste tenue envers ce client, et, pour les données personnelles, au titre du RGPD.
Les mesures à la portée d’une PME
Netskope observe chez ses clients que le blocage des applications indésirables fonctionne bien, mais il suppose un outil de filtrage que peu de PME possèdent. Greenworking et Ipsos bva constatent de leur côté que les usages avancent plus vite que les cadres proposés par les organisations. La réponse la plus simple consiste à ouvrir une offre professionnelle pour l’outil que l’équipe utilise déjà, puis à demander que les comptes personnels ne servent plus pour le travail.
Les règles se mettent ensuite par écrit. La CNIL recommande d’encadrer l’IA générative par des politiques ou chartes internes qui définissent les usages autorisés et interdits, et, selon le mode de déploiement, d’interdire la saisie de certaines données confidentielles ou personnelles. Notre modèle de charte IA pour PME classe les données en trois niveaux et dit lesquelles peuvent aller dans quel outil ; le tableau ci-dessus aide à choisir le compte adapté à chaque niveau.
Pour savoir où vous en êtes, posez la question franchement, sans chercher de coupable : quels outils, avec quel compte, pour quelles tâches. Notez les réponses dans l’inventaire des outils de notre modèle de registre de formation IA. Pour les données les plus sensibles (dossiers médicaux, secret professionnel, code propriétaire), le choix reste entre une offre professionnelle sous contrat et un modèle installé en local.
La liste de contrôle à copier
Cette liste reprend les points du tableau dans l’ordre où une petite équipe peut les traiter. Copiez-la dans votre outil de suivi ou imprimez-la.
LISTE DE CONTRÔLE : IA ET DONNÉES DE L'ENTREPRISE
(maccus.fr, version du 10 octobre 2026)

COMPTES
[ ] Lister les outils d'IA utilisés dans l'équipe, y compris ceux payés par les salariés eux-mêmes.
[ ] Pour chaque outil, noter le type de compte : personnel ou géré par l'entreprise.
[ ] Ouvrir une offre professionnelle pour les outils les plus utilisés (Business, Team, Enterprise, Workspace, compte Entra).
[ ] Demander ou signer l'accord de traitement des données (DPA) de chaque fournisseur.
[ ] Interdire les comptes ouverts avec une adresse personnelle pour le travail.

RÉGLAGES (comptes grand public encore utilisés)
[ ] Désactiver l'entraînement sur chaque compte : ChatGPT, Gemini, Perplexity, Mistral Vibe, GitHub Copilot, Grammarly, LinkedIn, et l'ancienne application Microsoft Copilot (ou la mettre à jour).
[ ] Sur Claude, vérifier le choix fait à l'inscription dans Paramètres > Confidentialité.
[ ] Vérifier les réglages séparés : Codex chez OpenAI, API chez Mistral.
[ ] Couper ou encadrer les boutons de retour (pouce) : un retour peut envoyer la conversation entière à l'entraînement.
[ ] Utiliser les discussions temporaires ou Incognito pour les demandes ponctuelles.

DONNÉES
[ ] Classer les données en trois niveaux : publiques, internes, confidentielles.
[ ] Aucune donnée confidentielle dans un outil grand public, même avec l'entraînement coupé.
[ ] Pas de données personnelles de clients ou de salariés dans DeepL gratuit (interdit par ses conditions).
[ ] Données couvertes par un secret professionnel : outil professionnel sous contrat, ou IA installée en local.
[ ] Vérifier ce que lisent les connecteurs (messagerie, Drive, agenda) avant de les activer.

RÈGLES ET SUIVI
[ ] Écrire les règles dans une charte d'utilisation de l'IA et la faire connaître.
[ ] Nommer une personne référente pour les questions et les demandes de nouvel outil.
[ ] Relire ce tableau de réglages chaque trimestre : les éditeurs changent leurs règles.
[ ] Garder une trace des réglages vérifiés (date, outil, personne).
Avant d’ouvrir un nouvel outil à l’équipe
Les règles des éditeurs bougent : en 2026, Microsoft et GitHub ont modifié les leurs, et Mistral a renommé son assistant. Avant chaque nouvel abonnement, relisez la page de confidentialité de l’éditeur, cherchez la mention de l’entraînement et de la durée de conservation, et notez la date de votre vérification.
Si vous voulez mettre à disposition de l’équipe un assistant sur Telegram, en français, en anglais ou en néerlandais, avec des accès à vos outils décidés au cas par cas, parlez-nous de votre activité.