Le 9 novembre 2026, Claude Fable 5.2, le nouveau modèle d’IA d’Anthropic, a obtenu 41,3 % au Remote Labor Index, un test fondé sur de vraies missions freelance payées. Sur cette part des projets, des évaluateurs formés ont jugé qu’un client aurait accepté son travail. Au lancement de l’indice, fin octobre 2025, le meilleur score plafonnait à 2,5 %.
L’indice évalue des agents d’IA, c’est-à-dire des systèmes d’IA qui travaillent seuls : ils ouvrent des fichiers, utilisent des logiciels et rendent un travail fini. Il est tenu par le Center for AI Safety (CAIS), un organisme de recherche à but non lucratif, et par Scale Labs, qui appartient à l’entreprise Scale AI.
Fable 5.2 fait presque deux fois mieux que le deuxième du classement, Opus 5.5 (21,25 %), un autre modèle d’Anthropic. Il fait plus de deux fois mieux que son prédécesseur, Fable 5.1 (17,92 %).
Anthropic a lancé Fable 5.2 le même jour (notre article sur le lancement). L’entreprise affiche le même 41,3 % dans le tableau de résultats de son annonce, mesuré avec son réglage d’effort « High ».
Des missions réelles, notées comme le ferait un client
Les auteurs de l’article de recherche qui présente l’indice ont recruté 358 freelances au compte vérifié sur Upwork, une plateforme qui met en relation clients et indépendants. Ils leur ont acheté des travaux déjà livrés : sur 550 projets réunis, 240 ont été retenus. Ces projets couvrent 23 catégories de métiers, dont le développement de jeux vidéo, le design produit, l’architecture, l’analyse de données et l’animation vidéo.
Chaque projet comprend le cahier des charges du client, les fichiers fournis et le travail remis par le freelance. Les freelances y ont passé 28,9 heures en moyenne, et la moitié des projets leur ont pris 11,5 heures ou moins. Les plus longs ont dépassé 100 heures.
D’après les prix déclarés par les freelances, l’ensemble vaut 143 991 dollars, soit environ 128 000 euros au taux de la Banque centrale européenne du 10 novembre 2026. Un projet vaut 632,60 dollars en moyenne, et la moitié valent 200 dollars ou moins. Les plus chers ont dépassé 10 000 dollars.
La notation est confiée à des humains. Un évaluateur formé ouvre les fichiers rendus par l’IA à côté de ceux du freelance. Il se demande si un « client raisonnable » accepterait la version de l’IA comme le travail commandé.
Chaque projet reçoit la note 1 (échec), 2 (au niveau attendu) ou 3 (au-dessus). Trois évaluateurs examinent chaque livrable, la majorité l’emporte, et Scale Labs annonce 94,4 % d’accord entre eux. Le « taux d’automatisation », le score du classement, est la part des projets notés 2 ou 3. Le classement repose sur 230 de ces projets, gardés secrets pour limiter le risque que de futurs modèles soient entraînés dessus.
Le CAIS a tenté de confier la notation à une IA, sans succès pour l’instant. Dans un billet du 1er juillet 2026, il indique que ce juge automatique surestimait les scores. Il donnait à GPT-5.5, un modèle d’OpenAI, un score environ 2,9 fois trop élevé, et à Opus 4.8 un score environ 2,3 fois trop élevé.
Juger un livrable demande de l’ouvrir dans Blender, un logiciel de 3D, ou dans un logiciel de conception assistée par ordinateur (CAO), et de savoir s’en servir. C’est justement ce que les agents font le moins bien. Un « rendu » de salle de bains livré par GPT-5.5, une image censée sortir d’un modèle 3D, avait en fait été fabriqué avec un générateur d’images, ce que seul l’examen du vrai modèle 3D a révélé.
De 2,5 % à 41,3 % en un peu plus d’un an
Au lancement, l’article de recherche concluait que les agents d’IA restaient « près du plancher » : le meilleur, l’agent Manus, réussissait 2,5 % des projets. « Le taux d’automatisation actuel est inférieur à 3 % », écrivait sur X Dan Hendrycks, l’un des chercheurs qui ont dirigé l’étude, le 29 octobre 2025.
Le 1er juillet 2026, le CAIS annonçait 15,8 % pour Fable 5, un modèle antérieur de la même famille. Le record précédent, 4,17 %, revenait à Opus 4.6 utilisé dans Claude Cowork, un environnement d’agent d’Anthropic. Opus 4.8 obtenait alors 8,3 % et GPT-5.5, 6,3 %. Selon le CAIS, le meilleur score avait « plus que quadruplé en moins de huit mois ».
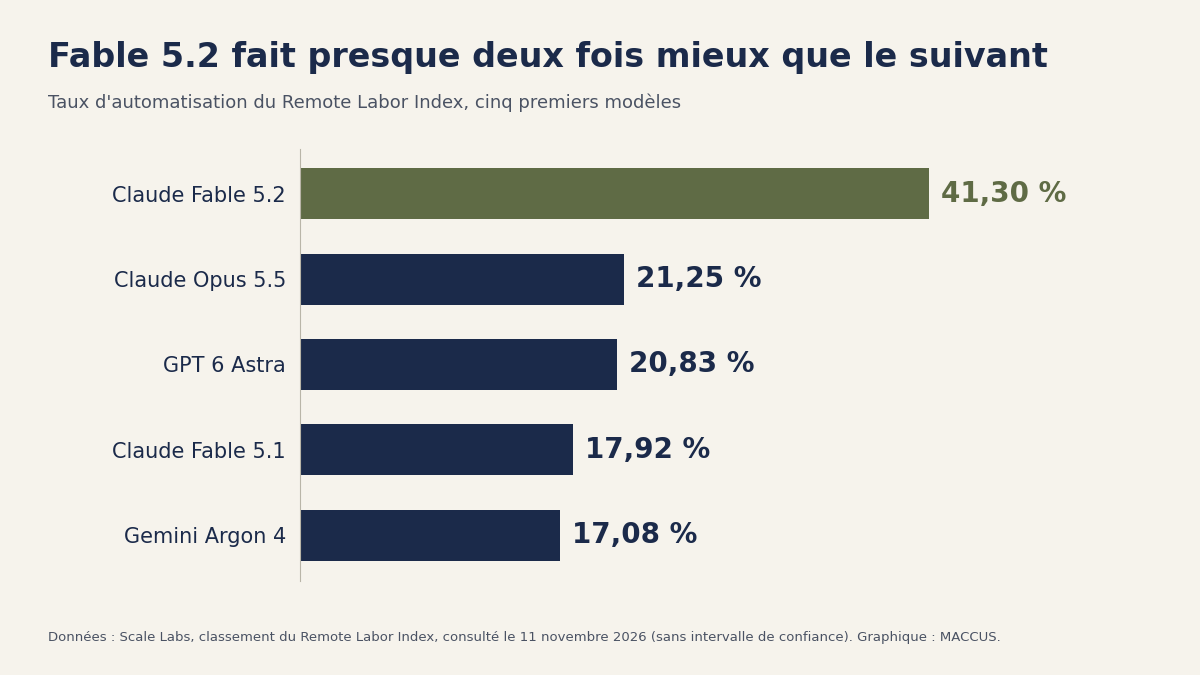
Quatre mois plus tard, Fable 5.2 atteint 41,3 %, plus de 16 fois le score du lancement. Ce dernier bond est aussi le plus grand : selon notre calcul, Fable 5.2 devance le deuxième, Opus 5.5, de 20 points de pourcentage. Avant lui, le record n’avait gagné que 18,75 points en tout, des 2,5 % du lancement aux 21,25 % d’Opus 5.5.
Le site de l’indice estime que le meilleur taux double environ « tous les 3,3 mois » sur les douze derniers mois. Notre propre calcul donne un ordre de grandeur proche. Entre le 30 octobre 2025 et le 9 novembre 2026, soit 375 jours, le meilleur score est passé de 2,5 % à 41,3 %. Il a doublé un peu plus de quatre fois, à peu près une fois tous les trois mois.
Où Fable 5.2 progresse et où les agents échouent
Scale Labs a précisé sur X le 9 novembre que les plus gros progrès de Fable 5.2 concernent l’audio et la musique, l’architecture et l’aménagement intérieur, et la modélisation 3D. Selon le même fil, le modèle progresse aussi nettement sur les projets longs et complexes. Près de 50 projets qu’il a réussis n’avaient jamais été menés à bien par un agent avant lui. Le design de produits industriels et l’animation restent « loin d’être résolus ».
L’analyse publiée au lancement, en octobre 2025, décrit les échecs des agents de l’époque. Un même livrable pouvait cumuler plusieurs défauts. Parmi les livrables ratés, 45,6 % étaient de qualité médiocre, « enfantine » ou amateur. Un peu plus du tiers (35,7 %) étaient incomplets, comme une vidéo de 8 secondes pour une commande de 8 minutes.
Dans 17,6 % des cas, les fichiers étaient corrompus, vides ou au mauvais format. Dans 14,8 %, le travail se contredisait, par exemple une maison dont l’aspect changeait d’une vue 3D à l’autre.
Le CAIS a aussi constaté en juillet que la durée d’un projet pour un humain ne prédit pas la réussite d’un agent. Certaines tâches rapides pour un professionnel, comme transcrire de la musique ou tester un jeu en temps réel, restent hors de portée des agents. Ils bouclent en revanche en quelques minutes du dessin numérique ou du code qui demande des heures à une personne.
Les limites du chiffre
L’indice ne couvre qu’une partie du travail à distance. Il exclut les missions qui exigent des échanges avec le client, comme le soutien scolaire, et le travail en équipe, comme la gestion de projet. Il écarte aussi le travail physique et les missions qu’on ne peut juger qu’après un long délai. C’est le cas du référencement naturel, qui vise à mieux placer un site dans les moteurs de recherche.
L’article de recherche prévient qu’une IA qui obtiendrait 100 % « pourrait encore faire moins bien que les humains sur des types de travail que nous n’évaluons pas ». Les 41,3 % de Fable 5.2 se rapportent donc aux seuls projets de l’indice.
Chaque modèle reçoit un score unique. « Il n’y a pas d’intervalle de confiance pour le taux d’automatisation », précise le classement : aucune fourchette n’indique la marge d’erreur. Le classement ne dit pas non plus à quelle fréquence une réussite se répète quand un agent retente le même projet.
Les conditions du test ont aussi changé en juillet 2026. Au lancement, les agents tournaient dans des environnements standard, avec un budget plafonné à 30 dollars de frais d’utilisation des modèles par projet. Depuis juillet, le CAIS fait travailler chaque modèle dans le meilleur agent de programmation de sa famille de modèles : Claude Code pour Anthropic, Codex CLI pour OpenAI. Ce sont les agents de programmation que les développeurs utilisent au quotidien, complétés d’un outil qui pilote les logiciels graphiques.
Chaque projet dispose d’un poste de travail sous Linux équipé de plus de 30 logiciels professionnels, et d’un processeur graphique si besoin. L’agent a 24 heures au maximum, et un second agent critique son travail avant la remise.
Le budget par défaut est désormais de 50 dollars par projet, porté à 150 dollars pour Fable 5, dont les tarifs sont plus élevés. Le budget de Fable 5.2 ne figure ni dans le classement ni dans l’annonce d’Anthropic.
Le CAIS présentait les résultats de juillet comme « associés à une infrastructure d’agent plus solide ». La hausse depuis 2025 mêle donc l’effet de meilleurs modèles et celui d’un meilleur dispositif. Les scores publiés ne permettent pas de faire la part des deux.
Deux autres documents publiés la même semaine, une prévision et la fiche technique d’Anthropic, apportent un contrepoint. L’AI Futures Project, un groupe qui publie des prévisions sur les progrès de l’IA, cite l’indice dans sa mise à jour du 10 novembre. Il y voit le signe que les autres compétences de l’IA semblent en retard sur sa capacité à faire de la recherche.
Cette mise à jour s’appuie sur l’audit de METR consacré à la recherche chez Anthropic. METR est un organisme à but non lucratif qui évalue les modèles d’IA. Le groupe reprend aussi la fiche technique des nouveaux modèles, le document où Anthropic décrit leurs capacités et leurs risques. Anthropic y écrit que Mythos 5.2, qui repose sur le même modèle que Fable 5.2, « ne semble pas près de pouvoir remplacer nos chercheurs et ingénieurs de recherche ».
Notre analyse
Le Remote Labor Index mesure quelque chose de plus proche du travail rémunéré que la plupart des tests d’IA. Il porte sur des projets entiers, avec les fichiers qu’un client recevrait, jugés par des humains face au travail d’un professionnel. Sur cette mesure, le meilleur agent est passé en un an de presque rien à environ quatre projets sur dix.
Le résultat porte sur des projets bien cadrés, remis avec un cahier des charges et des fichiers, et notés une seule fois. Il laisse de côté les échanges avec le client, les allers-retours et le travail d’équipe. L’indice ne compte pas non plus d’emplois.
Côté emploi, aux États-Unis, les employeurs ont attribué 1 265 suppressions de postes à l’IA en octobre, le chiffre mensuel le plus bas de 2026, contre 38 579 en mai. Chez Anthropic, une étude interne montre que les juniors sont passés de 27 % à 9 % des embauches techniques.
Trois informations manquent encore pour interpréter ce 41,3 % : le coût de chaque essai, la fréquence à laquelle une réussite se répète, et la part de la hausse due au nouveau dispositif de juillet.
Le CAIS prévoit d’ajouter à l’indice les principaux modèles à leur sortie. En juillet, il avait publié un compte rendu détaillé, exemples à l’appui, pour Fable 5. Au 11 novembre, son blog ne comptait aucun billet de ce type pour Fable 5.2.
Les prochains résultats diront si le rythme d’un doublement tous les trois mois environ se maintient. Ils montreront aussi s’il résiste quand les agents abordent les deux catégories que Scale Labs juge loin d’être résolues, le design de produits industriels et l’animation.
Sources
- Remote Labor Index: Measuring AI Automation of Remote Work, Mantas Mazeika, Alice Gatti, Cristina Menghini et al. (Center for AI Safety, Scale AI), arXiv, 30 octobre 2025
- Remote Labor Index (RLI), classement Scale Labs, consulté le 11 novembre 2026
- @AnthropicAI’s Fable 5.2 takes the top spot on our Remote Labor Index with @CAIS, Scale Labs sur X, 9 novembre 2026
- A Significant Increase in Digital Labor Automation, Mantas Mazeika, Center for AI Safety, 1er juillet 2026
- Remote Labor Index, Center for AI Safety et Scale AI, consulté le 11 novembre 2026
- Introducing Claude Fable 5.2 and Claude Mythos 5.2, Anthropic, 9 novembre 2026
- Q3.5 Timelines Update: Looks Like the Intelligence Explosion Will Happen in 2027 After All, AI Futures Project, 10 novembre 2026
- Can AI automate jobs? We created the Remote Labor Index, Dan Hendrycks sur X, 29 octobre 2025
Image d’en-tête : graphique MACCUS, données de Mazeika et al. (Center for AI Safety, Scale AI), arXiv 2510.26787, 30 octobre 2025 ; Center for AI Safety, 1er juillet 2026 ; Scale Labs, 9 novembre 2026