
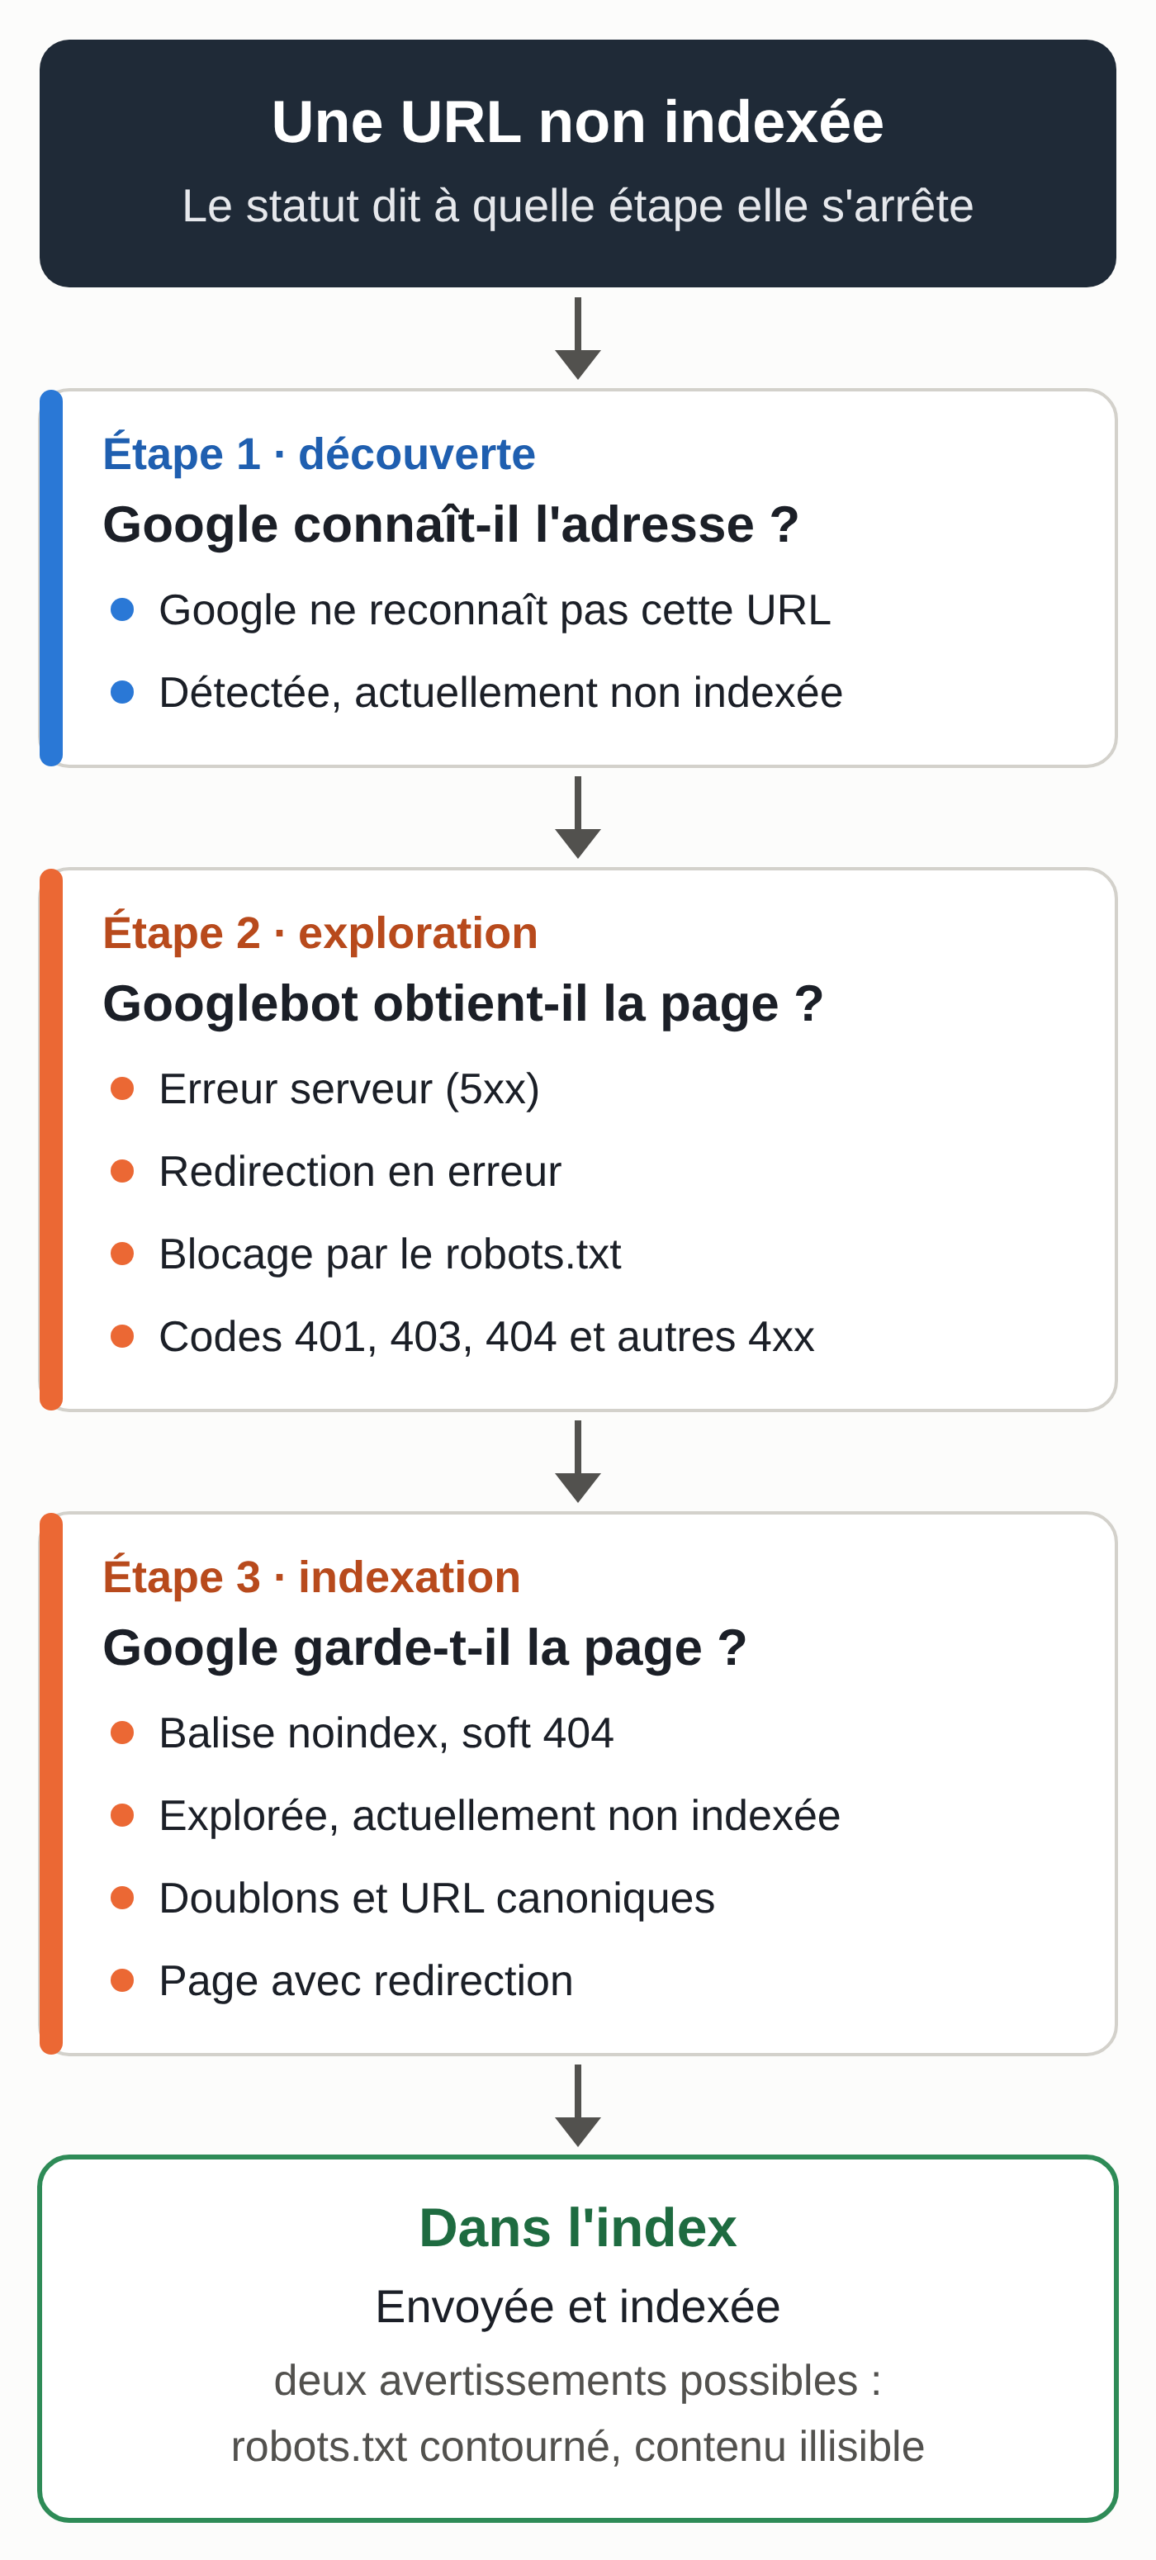
Le rapport « Indexation des pages » de la Search Console classe chaque URL connue de Google en deux groupes : indexée ou non indexée. Pour chaque page non indexée, il donne un motif, sous la forme d’un libellé court comme « Explorée, actuellement non indexée » ou « Page avec redirection ». Certains de ces libellés signalent une panne à réparer, d’autres décrivent un fonctionnement normal.
Ce guide reprend tous les motifs que la page d’aide de Google décrit au 10 octobre 2026, avec le libellé tel que la Search Console l’affiche en français, son équivalent anglais, notre niveau de gravité et la première action à mener. Une fiche par statut suit le tableau. Pour la mécanique générale (exploration, rendu, index), commencez par notre guide complet sur l’indexation.
Où trouver le rapport et comment le lire
Le rapport s’ouvre depuis le menu de la Search Console, ou directement à l’adresse search.google.com/search-console/index. La page récapitulative montre un graphique des pages indexées et non indexées, puis un tableau intitulé « Pourquoi des pages ne sont pas indexées ». Chaque ligne de ce tableau est un motif, avec le nombre d’URL concernées.
Trois colonnes de ce tableau orientent le travail. Le motif donne la raison. La source indique si le problème vient du site ou de Google : en général, seuls les problèmes dont la source est le site peuvent être corrigés par vous. La validation indique si vous avez déjà demandé à Google de vérifier une correction.
Google conseille de traiter d’abord les motifs dont la source est le site et dont la validation est « Échec » ou « Non commencé ».
Un clic sur une ligne ouvre la liste des URL touchées, limitée à 1 000 exemples. Google précise que cette liste ne contient pas forcément toutes les URL concernées. Le rapport ne se filtre pas par adresse : pour connaître l’état d’une page précise, il faut passer par l’outil d’inspection d’URL. Cet outil affiche aussi la date de la dernière exploration, utile pour savoir si une modification attend simplement le prochain passage de Google (voir nos repères sur les délais d’indexation Google). Le rapport sur les performances, lui, accepte des filtres par expression régulière : voyez nos 40 filtres regex pour la Search Console.
Au-dessus du graphique, un filtre permet de n’afficher que les URL envoyées dans un sitemap, ou au contraire celles qui n’y figurent pas. C’est le réglage le plus utile du rapport. Une page absente du sitemap et non indexée peut n’avoir rien d’anormal, alors qu’une page envoyée dans le sitemap et non indexée mérite une explication.
Deux réserves de Google avant de lire les chiffres. Sur un site de moins de 500 pages, le rapport sera probablement peu utile, et une recherche site:votresite.fr sur les pages importantes répond plus vite. Une couverture de 100 % n’est pas l’objectif non plus : les doublons, les pages filtrées et les pages supprimées doivent rester hors de l’index. Le but est que chaque page importante, dans sa version canonique, soit indexée.
Le tableau de tous les statuts au 10 octobre 2026
Le tableau suit l’ordre de la page d’aide de Google. La gravité est notre lecture, sur trois niveaux : « À corriger » quand une page qui devrait être indexée est bloquée par un problème technique, « À vérifier » quand le statut est normal pour certaines pages et grave pour d’autres, « Normal » quand Google décrit un fonctionnement attendu.
Vérifié le 10 octobre 2026.
| Libellé dans la Search Console (français) | Libellé anglais | Constat de Google | Gravité | Première action |
|---|---|---|---|---|
| Erreur serveur (5xx) * | Server error (5xx) | Le serveur a répondu par une erreur 500 ou a mis trop de temps à répondre. | À corriger | Consulter les statistiques sur l’exploration, puis l’hébergeur ou le pare-feu. |
| Erreur liée à des redirections * | Redirect error | Chaîne trop longue, boucle, URL trop longue ou vide dans la redirection. | À corriger | Remplacer la chaîne par une seule redirection 301 vers l’adresse finale. |
| URL bloquée par le fichier robots.txt * | URL blocked by robots.txt | Une règle du fichier robots.txt interdit l’exploration de la page. | À vérifier | Retirer la règle si la page doit être indexée. |
| Exclue par la balise "noindex" | Excluded by ‘noindex’ tag | Google a trouvé une règle noindex dans la page ou dans l’en-tête HTTP. | À vérifier | Retirer le noindex si la page doit être indexée. |
| Erreur "soft 404" * | Soft 404 | La page répond 200 mais ressemble à une page d’erreur ou à une page vide. | À vérifier | Renvoyer un vrai 404 ou compléter la page. |
| Bloquée en raison d’une demande non autorisée (401) * | Blocked due to unauthorized request (401) | La page demande une authentification. | À vérifier | Ouvrir la page en navigation privée, retirer l’identification si elle doit être publique. |
| Introuvable (404) | Not found (404) | La page renvoie 404. Une URL en 410 s’affiche aussi sous ce libellé. | À vérifier | Rediriger en 301 si la page a été déplacée, sinon laisser. |
| Bloquée en raison d’une interdiction d’accès (403) | Blocked due to access forbidden (403) | Le serveur refuse l’accès alors que Googlebot ne fournit jamais d’identifiants. | À corriger | Chercher la règle du pare-feu ou du serveur qui bloque Googlebot. |
| Bloquée en raison d’un autre problème de type 4xx | Blocked due to other 4xx issue | Une autre erreur 4xx (400, 405…) que les cas précédents. | À vérifier | Inspecter l’URL ; il peut s’agir d’une adresse technique sans intérêt. |
| Explorée, actuellement non indexée | Crawled - currently not indexed | Google a lu la page et a choisi de ne pas l’indexer pour l’instant. | À vérifier | Améliorer la page et ses liens internes ; ne pas la renvoyer en boucle. |
| Détectée, actuellement non indexée | Discovered - currently not indexed | Google connaît l’URL mais a reporté son exploration. | À vérifier | Vérifier la santé du serveur et réduire les URL inutiles. |
| Autre page avec balise canonique correcte * | Alternate page with proper canonical tag | La page désigne une autre page comme canonique, et celle-ci est indexée. | Normal | Aucune. |
| Page en double sans URL canonique sélectionnée par l’utilisateur * | Duplicate without user-selected canonical | Google juge la page en double d’une autre, sans balise canonique déclarée. | À vérifier | Déclarer la canonique, ou différencier la page si elle n’est pas un doublon. |
| Page en double : Google a choisi une autre URL canonique que l’utilisateur * | Duplicate, Google chose different canonical than user | Votre balise canonique désigne une page, Google en a retenu une autre. | À vérifier | Aligner redirections, liens internes, sitemap et balise canonique. |
| Page avec redirection | Page with redirect | L’URL redirige vers une autre adresse ; c’est la cible qui peut être indexée. | Normal | Aucune, sauf si l’URL figure dans votre sitemap. |
| Indexée malgré le blocage par le fichier robots.txt * | Indexed, though blocked by robots.txt | La page est bloquée par robots.txt mais indexée grâce à des liens. | À vérifier | Remplacer le blocage par un noindex, ou lever le blocage. |
| Page indexée sans contenu * | Page indexed without content | La page est dans l’index, mais Google n’a pas pu lire son contenu. | À corriger | Inspecter l’URL et tester la version en ligne. |
* Libellé repris de la page d’aide de Google, en français et en anglais. Nous ne l’avons pas observé dans la Search Console le 10 octobre 2026 : l’interface peut l’écrire un peu autrement.
Méthode. Les motifs, leurs définitions et les actions viennent de la page d’aide de Google sur le rapport d’indexation des pages, lue en français et en anglais le 10 octobre 2026, et des pages de documentation de Google Search Central citées dans les fiches.
Cette page d’aide française est une traduction automatique, et plusieurs de ses titres diffèrent de l’interface : elle écrit par exemple « URL marquée "noindex" » quand la Search Console affiche « Exclue par la balise "noindex" ». Nous avons donc relevé les libellés de la colonne de gauche en français à travers l’API d’inspection d’URL de la Search Console, qui renvoie les libellés de l’outil, sur des pages de sites que nous gérons. Les libellés que nous n’avons pas pu observer ce jour-là sont marqués d’un astérisque.
Les noms de tableaux, de filtres et de boutons cités dans ce guide (« Pourquoi des pages ne sont pas indexées », « Valider la correction »…) viennent de la même page d’aide et peuvent varier légèrement dans l’interface. Le tableau est revu à chaque changement de la page d’aide de Google, et la date ci-dessus change avec lui.
Les erreurs de serveur et de redirection
Erreur serveur (5xx)
Cause : Googlebot n’a pas réussi à obtenir la page. Le serveur a répondu par une erreur de type 500, la requête a expiré ou le site était surchargé. La documentation de Google sur les codes d’état HTTP précise qu’une erreur 5xx ou 429 pousse Google à ralentir l’exploration du site, et que les URL qui renvoient une erreur de serveur de façon persistante finissent par sortir de l’index.
Gravité : à corriger dès que des pages importantes sont touchées. Une erreur ponctuelle peut disparaître seule, car Google précise que ces erreurs peuvent être temporaires.
Action : ouvrez le rapport « Statistiques sur l’exploration », dans les paramètres de la Search Console, et regardez l’état de l’hôte. Google cite plusieurs causes : un serveur en panne ou sous-dimensionné, des pages dynamiques trop lentes, et surtout un pare-feu ou une protection contre les attaques par déni de service qui bloque Googlebot parce qu’il envoie plus de requêtes qu’un visiteur. Si vous ne gérez pas le pare-feu, la demande va à l’hébergeur. Le test en direct de l’outil d’inspection peut réussir alors que l’exploration de Google a échoué : une erreur passagère ne se reproduit pas forcément.
Erreur liée à des redirections
Cause : la redirection de l’URL n’aboutit pas. Google cite quatre cas : une chaîne de redirections trop longue, une boucle, une URL de redirection qui finit par dépasser la longueur maximale, ou une URL vide ou incorrecte dans la chaîne. Selon la documentation sur les codes d’état, Googlebot suit en général jusqu’à 10 redirections successives.
Gravité : à corriger si l’adresse reçoit des liens ou du trafic.
Action : remplacez la chaîne par une redirection directe vers l’adresse finale, en 301 pour un changement définitif. Une chaîne se forme par exemple après plusieurs refontes, quand une ancienne règle (http vers https, ajout du www) s’ajoute à une nouvelle (changement de slug). Google renvoie vers un outil de débogage comme Lighthouse pour suivre la chaîne.
Les blocages, volontaires ou non
URL bloquée par le fichier robots.txt
Cause : une règle Disallow du fichier robots.txt empêche Googlebot d’explorer l’URL.
Gravité : normale pour l’administration du site, les paniers ou les résultats de recherche interne. Grave si la règle touche des pages que vous voulez voir dans Google, ce qui arrive après une migration ou quand un site de préproduction passe en ligne avec son robots.txt de test.
Action : si la page doit être indexée, retirez la règle. Si elle ne doit pas l’être, gardez en tête une limite que Google répète dans sa présentation du robots.txt : ce fichier règle l’exploration et ne sert pas à masquer une page des résultats. Une page bloquée peut quand même être indexée si d’autres pages renvoient vers elle.
Pour l’exclure, il faut un noindex, et donc lever le blocage pour que Google puisse le lire. Notre article sur les robots IA et le robots.txt détaille la syntaxe.
Exclue par la balise "noindex"
Cause : en lisant la page, Google a trouvé une règle noindex, soit dans une balise <meta name="robots" content="noindex">, soit dans un en-tête HTTP X-Robots-Tag: noindex.
Gravité : c’est le résultat voulu pour une page que vous avez exclue. C’est un incident si la page devait être indexée. Parmi les causes possibles : une case « Demander aux moteurs de recherche de ne pas indexer ce site » restée cochée dans WordPress, un réglage d’extension SEO appliqué à tout un type de contenu, ou un en-tête ajouté côté serveur que personne ne voit dans le code de la page.
Action : inspectez l’URL. La section sur l’indexation indique si un noindex bloque la page. Lancez ensuite le test en direct : si la règle a disparu, demandez l’indexation. Si elle est encore là, cherchez « noindex » dans le code source et dans les en-têtes de réponse. Google rappelle dans sa documentation sur noindex que la règle ne fonctionne que si la page n’est pas bloquée par le robots.txt.
Bloquée en raison d’une demande non autorisée (401)
Cause : la page renvoie une demande d’authentification (code 401). C’est le cas d’un espace client, d’un site protégé par mot de passe pendant sa construction ou d’un intranet.
Gravité : normale pour un espace privé. Grave si une page publique est concernée, par exemple quand la protection de préproduction a été copiée sur le site en ligne.
Action : ouvrez la page en navigation privée. Si elle doit être publique, retirez l’identification. Google admet une autre option : autoriser Googlebot sans authentification, à condition de vérifier qu’il s’agit bien de lui.
Bloquée en raison d’une interdiction d’accès (403)
Cause : le serveur répond 403, accès interdit. Google relève que ce code signifie qu’un visiteur a fourni des identifiants sans obtenir l’accès, alors que Googlebot n’en fournit jamais. Le serveur renvoie donc cette erreur à tort.
Gravité : à corriger, puisque la page ne sera pas indexée. Sur un site WordPress, cherchez d’abord du côté d’une extension de sécurité, d’un pare-feu applicatif ou d’une règle d’hébergeur qui refuse Googlebot. Une adresse technique comme xmlrpc.php, fermée volontairement par une extension de sécurité, peut rester en 403.
Action : comparez la réponse servie à Googlebot (test en direct de l’outil d’inspection) avec celle d’un navigateur. Si le 403 sert à freiner les robots, changez de méthode : la documentation de Google demande de ne pas utiliser les codes 401 et 403 pour limiter la vitesse d’exploration, car ils n’ont aucun effet sur elle.
Bloquée en raison d’un autre problème de type 4xx
Cause : une erreur 4xx autre que 401, 403, 404 et 410, par exemple 400 (requête incorrecte) ou 405 (méthode non autorisée).
Gravité : à vérifier. Sur WordPress, ce motif peut regrouper des adresses techniques, comme admin-ajax.php, qui répond 400 à une simple visite. Elles n’ont rien à faire dans l’index.
Action : inspectez une URL d’exemple. Si c’est une page de contenu, cherchez pourquoi le serveur répond par une erreur. Si c’est une adresse technique, laissez-la.
Les pages supprimées ou vides
Introuvable (404)
Cause : la page a renvoyé 404. Selon Google, l’URL a pu être trouvée par un lien depuis une autre page, ou la page a été supprimée. Le 10 octobre 2026, une URL qui renvoyait 410 (supprimée définitivement) apparaissait sous ce même libellé dans l’outil d’inspection. La documentation sur les codes d’état traite d’ailleurs toutes les erreurs 4xx de la même façon, sauf le 429.
Gravité : normale pour une page supprimée sans remplaçante. Le rapport ne garde que les URL qui ont renvoyé 404 au cours du mois précédent, pour éviter une liste sans fin.
Action : Google conseille de corriger seulement les 404 que vous liez vous-même ou que vous listez dans un sitemap. Une page déplacée reçoit une redirection 301 vers sa nouvelle adresse. Pour une page supprimée, le 404 ou le 410 suffit.
Il n’existe aucun moyen de faire oublier une URL à Googlebot, qui revient de moins en moins souvent. Après un piratage qui avait créé des pages de spam, ces 404 montrent que les pages ont bien disparu.
Erreur "soft 404"
Cause : la page répond avec un code 200 (succès), mais son contenu ressemble à une erreur. Google cite une page vide ou un message d’erreur, comme un « Page introuvable » affiché sans code 404. Une fiche produit sans produit ou une recherche interne sans résultat peuvent donner le même effet. Google n’indexe pas la page.
Gravité : à vérifier. Si la page est vraiment vide ou supprimée, le problème est le code de réponse. Si la page a un vrai contenu, Google l’a mal lue, par exemple parce que ce contenu se charge en JavaScript et n’apparaît pas au rendu.
Action : pour une page supprimée, renvoyez un vrai 404 ou 410, ou redirigez vers une page équivalente. Pour une page légitime, lancez le test en direct et ouvrez « Afficher la page testée » : la capture montre ce que Google voit. Si elle est vide ou ne montre qu’un message d’erreur, le problème vient du rendu.
Explorée ou détectée, sans indexation
Ces deux statuts sont ceux sur lesquels vous avez le moins de prise directe, et leurs causes diffèrent.
Explorée, actuellement non indexée
Cause : Googlebot a visité la page et l’a lue, puis Google a décidé de ne pas l’ajouter à l’index pour le moment. La page d’aide se limite à cette phrase : la page sera peut-être indexée à l’avenir et il n’est pas nécessaire de la renvoyer pour exploration. Google ne donne pas de raison page par page.
Gravité : à vérifier, page par page. Pour des flux RSS, des pages d’archives, des pages de tags presque vides ou des traductions automatiques peu utiles, le statut est logique et sans conséquence. Pour une page de service, une fiche produit qui vend ou un article de fond, c’est un signal à prendre au sérieux.
Action : la page sur les demandes d’exploration donne la ligne de Google : une demande d’exploration ne garantit pas l’indexation, et ses systèmes privilégient l’inclusion rapide des contenus utiles et de haute qualité. Les leviers sont donc du côté de la page. Vérifiez qu’elle apporte quelque chose que vos autres pages n’ont pas déjà, qu’elle n’est pas un quasi-doublon, qu’elle reçoit des liens internes depuis des pages elles-mêmes indexées, et qu’elle figure dans le sitemap. Une fois la page réellement modifiée, une seule demande d’indexation suffit : Google précise que les demandes répétées pour la même URL n’accélèrent rien.
Détectée, actuellement non indexée
Cause : Google connaît l’URL, par un lien ou un sitemap, mais ne l’a pas encore explorée. La page d’aide explique qu’en règle générale Google voulait explorer l’URL et a reporté l’exploration parce que le site risquait d’être surchargé. C’est pour cela que le rapport n’affiche aucune date de dernière exploration pour ces pages.
Gravité : à vérifier. Pour quelques pages récentes, le statut est souvent passager : Google indique qu’il faut jusqu’à une semaine avant qu’il commence à explorer et indexer une nouvelle page. Pour une grande part du site, c’est un problème de capacité d’exploration.
Action : Google classe explicitement les sites où une proportion importante d’URL est « Détectée, actuellement non indexée » parmi les lecteurs de son guide sur le budget d’exploration, avec les sites de plus d’un million de pages dont le contenu change chaque semaine. Parmi ses pistes : un serveur qui répond vite, car la limite de capacité d’exploration augmente quand les temps de réponse restent stables ou s’améliorent ; moins d’URL inutiles, par exemple les variantes de tri et de filtre ; et un code 404 ou 410 pour les pages supprimées, au lieu de les bloquer.
Google y déconseille le noindex pour économiser de l’exploration, car la page est quand même demandée avant d’être écartée. Côté pages, assurez-vous que celles qui comptent sont liées depuis des pages déjà indexées.
Doublons, URL canoniques et redirections
Quand plusieurs adresses servent le même contenu, Google en choisit une, l’URL canonique, et laisse les autres hors de l’index. Sa page sur la canonicalisation cite les cas habituels : versions http et https, versions mobile et ordinateur, pages de catégorie triées ou filtrées, site de démonstration resté accessible. Le contenu en double n’enfreint pas les règles de Google concernant le spam. Trois statuts en découlent, plus celui des redirections. Notre guide sur la canonicalisation détaille les balises.
Autre page avec balise canonique correcte
Cause : la page désigne une autre page comme canonique, cette autre page est indexée, et Google est d’accord. Les exemples de Google sont une page AMP, une version mobile ou une version ordinateur de la même page.
Gravité : normale. Google écrit qu’il n’y a aucune action à effectuer.
Action : aucune. Si le nombre grimpe d’un coup, regardez d’où viennent ces URL : une adresse avec un paramètre de suivi (comme utm_source) qui désigne la page sans paramètre comme canonique finit sous ce libellé. La page d’aide précise aussi que la Search Console ne détecte pas les versions dans d’autres langues sous ce statut.
Page en double sans URL canonique sélectionnée par l’utilisateur
Cause : Google estime que la page double une autre, et la page ne déclare aucune URL canonique. Google a donc choisi lui-même l’autre page comme canonique.
Gravité : à vérifier. Si la page est un vrai doublon (une version avec paramètre, une page d’impression), Google fonctionne comme prévu. Si la page est différente à vos yeux, Google ne la voit pas ainsi.
Action : inspectez l’URL pour voir quelle page Google a retenue. Si Google a retenu la mauvaise page, déclarez explicitement la bonne canonique. Si ce choix vous convient, ajoutez une balise canonique vers cette page, ou une redirection si le doublon n’a pas de raison d’exister.
Si la page n’est pas un doublon, Google demande que son contenu diffère sensiblement de la canonique. Des fiches produits qui ne changent que par une couleur, ou des pages de villes au texte identique, en sont des exemples.
Page en double : Google a choisi une autre URL canonique que l’utilisateur
Cause : la page porte une balise canonique, mais Google a retenu une autre URL comme canonique et a indexé celle-là.
Gravité : à vérifier. Le statut peut venir de signaux qui se contredisent.
Action : dans l’outil d’inspection, comparez « URL canonique déclarée par l’utilisateur » et « URL canonique sélectionnée par Google », puis ouvrez les trois pages dans le navigateur. La documentation de Google sur les URL en double classe les signaux par force : une redirection et une balise rel="canonical" sont des signaux forts, la présence dans un sitemap un signal faible.
Elle demande de ne pas donner deux canoniques différentes par deux méthodes, de mettre une balise canonique sur la page canonique elle-même, et de ne pas utiliser le robots.txt pour ce choix. Alignez tout sur la même adresse : liens internes, sitemap, balise et redirections. Si l’URL que vous déclarez ne ressemble pas à la page, Google ne la choisira jamais.
Page avec redirection
Cause : l’URL redirige vers une autre adresse. Elle ne sera pas indexée ; la cible le sera ou non, selon ce que Google pense de cette cible.
Gravité : normale. Une adresse sans barre oblique finale qui redirige vers sa version avec barre oblique, une ancienne adresse redirigée après une refonte, la version http d’une page en https : tout cela finit sous ce libellé.
Action : aucune, sauf deux vérifications. Votre sitemap ne doit lister que les adresses finales, pas les URL qui redirigent. Et la cible doit elle-même être indexée : inspectez-la séparément. Dans l’outil d’inspection, les informations de l’index concernent l’URL testée, sans suivre la redirection.
Les deux avertissements sur des pages indexées
Le rapport a un second tableau, « Améliorer l’expérience sur la page ». Ses motifs n’ont pas empêché l’indexation. Google conseille quand même de les corriger, pour qu’il comprenne mieux la page.
Indexée malgré le blocage par le fichier robots.txt
Cause : la page est bloquée par le robots.txt et Google l’a quand même indexée, grâce aux liens qui pointent vers elle. Il ne l’a pas explorée. Dans les résultats, l’extrait sera probablement très limité.
Gravité : à vérifier. Le statut pose surtout problème quand le blocage devait cacher la page.
Action : si la page ne doit pas apparaître dans Google, retirez le blocage du robots.txt et ajoutez un noindex : c’est la seule façon pour Google de lire la consigne. Si la page doit apparaître, retirez simplement le blocage. Depuis janvier 2021, une page envoyée dans un sitemap, bloquée par le robots.txt et indexée quand même est classée sous ce statut en avertissement, et non plus en erreur, selon l’annonce de Google.
Page indexée sans contenu
Cause : la page est dans l’index, mais Google n’a pas réussi à lire son contenu. Google précise que le robots.txt n’est pas en cause, et évoque une page inaccessible à Google ou un format qu’il ne sait pas indexer.
Gravité : à corriger, car la page indexée ne peut pas se positionner sur un contenu que Google ne lit pas.
Action : inspectez la page, lancez le test en direct et regardez la page rendue. Comparez la réponse servie à Googlebot avec celle d’un navigateur. Ce motif existe depuis la même mise à jour de janvier 2021.
Les libellés propres à l’outil d’inspection d’URL
L’outil d’inspection d’URL, qui sert à vérifier une page précise, affiche aussi des libellés que le rapport n’utilise pas. Nous les avons relevés en français le 10 octobre 2026.
« Envoyée et indexée » signifie que la page est indexée et qu’elle figure dans un sitemap que vous avez envoyé. C’est l’état attendu de toutes vos pages importantes. Une page indexée qui n’est dans aucun sitemap porte un autre libellé ; si c’est une page qui compte, ajoutez-la à votre sitemap.
« Google ne reconnaît pas cette URL » signifie que Google n’a jamais détecté l’adresse. La page d’aide de l’outil le formule ainsi : la page n’est pas indexée, Google ne reconnaît pas cette URL. Pour une page publiée le jour même, rien d’inquiétant. Pour une page en ligne depuis des mois, cela veut dire qu’aucun lien ni aucun sitemap ne mène à elle.
En haut de l’outil, une phrase générale résume la situation, par exemple « Cette URL est sur Google » ou « Cette URL n’a pas été indexée par Google » dans la page d’aide française. Google rappelle que « sur Google » ne garantit pas que la page apparaisse dans les résultats.
Le test en direct ne vérifie pas tout ce que vérifie le rapport. La page d’aide précise que les doublons et le choix de l’URL canonique ne sont pas testés en direct. Un test en direct réussi ne dit donc rien d’un statut de doublon.
L’ordre des corrections, puis la validation
Commencez par séparer ce qui doit être indexé de ce qui ne doit pas l’être. Filtrez le rapport sur les pages envoyées dans un sitemap : votre sitemap est censé lister les pages qui comptent, et tout motif non indexé dans cette vue mérite une explication.
L’ordre suivant limite les allers-retours. Les erreurs de serveur passent en premier, car Google ralentit l’exploration de tout le site quand elles s’accumulent. Les 403 suivent : une seule règle de pare-feu peut fermer une section entière du site à Googlebot.
Viennent ensuite les blocages involontaires, robots.txt et noindex, qui viennent parfois d’un seul réglage appliqué à des centaines de pages. Puis les redirections en erreur et les soft 404, et enfin les doublons et les pages explorées ou détectées sans indexation, qui demandent un travail page par page sur le contenu et les liens.
Une fois toutes les instances d’un motif corrigées, ouvrez le motif et cliquez sur « Valider la correction ». Google vérifie d’abord quelques pages, puis remet en file d’exploration les URL connues pour ce problème, et seulement elles.
La validation prend en général environ deux semaines, parfois beaucoup plus, et s’arrête dès qu’une instance restante est trouvée. Il faut attendre la fin d’un cycle avant d’en lancer un autre. Pour aller plus vite, Google suggère d’envoyer un sitemap ne contenant que vos pages les plus importantes, de filtrer le rapport sur ce sitemap, puis de lancer la validation sur ce sous-ensemble.
La validation est facultative. Google met à jour les compteurs à chaque nouvelle exploration des pages concernées, que vous ayez cliqué ou non. Un motif disparaît du tableau 90 jours après la disparition de sa dernière instance ; s’il revient avant, il garde sa date de première détection.
Pour une page isolée, la demande d’indexation de l’outil d’inspection suffit, dans la limite d’un quota. Pour beaucoup d’URL, Google recommande d’envoyer un sitemap. Si vous suivez aussi Bing, notre guide de Bing Webmaster Tools montre l’équivalent de ce rapport côté Microsoft et le protocole IndexNow. Et si votre trafic chute sans aucun changement dans ce rapport, vérifiez le rapport sur les actions manuelles.
Un site traduit dans plusieurs langues
Dans une propriété qui couvre toutes les langues d’un site, le rapport les mélange dans les mêmes motifs, et deux points demandent une attention particulière. Les versions linguistiques d’une même page ne sont des doublons, pour Google, que si leur contenu principal est dans la même langue. Si seuls le menu et le pied de page sont traduits, les pages sont considérées comme des doublons.
Une traduction peu demandée, ou trop proche d’une autre version, peut aussi rester « Explorée, actuellement non indexée ». Notre méthode de référencement d’un site multilingue explique comment relier les langues entre elles. Pour suivre ensuite les clics de chaque langue, notre tableau de bord Search Console dans Looker Studio leur consacre une page.
Si votre site existe en plusieurs langues et que ses versions traduites restent hors de l’index, notre offre de SEO multilingue commence par un passage sur l’indexation de chaque langue, les adresses et les balises hreflang.