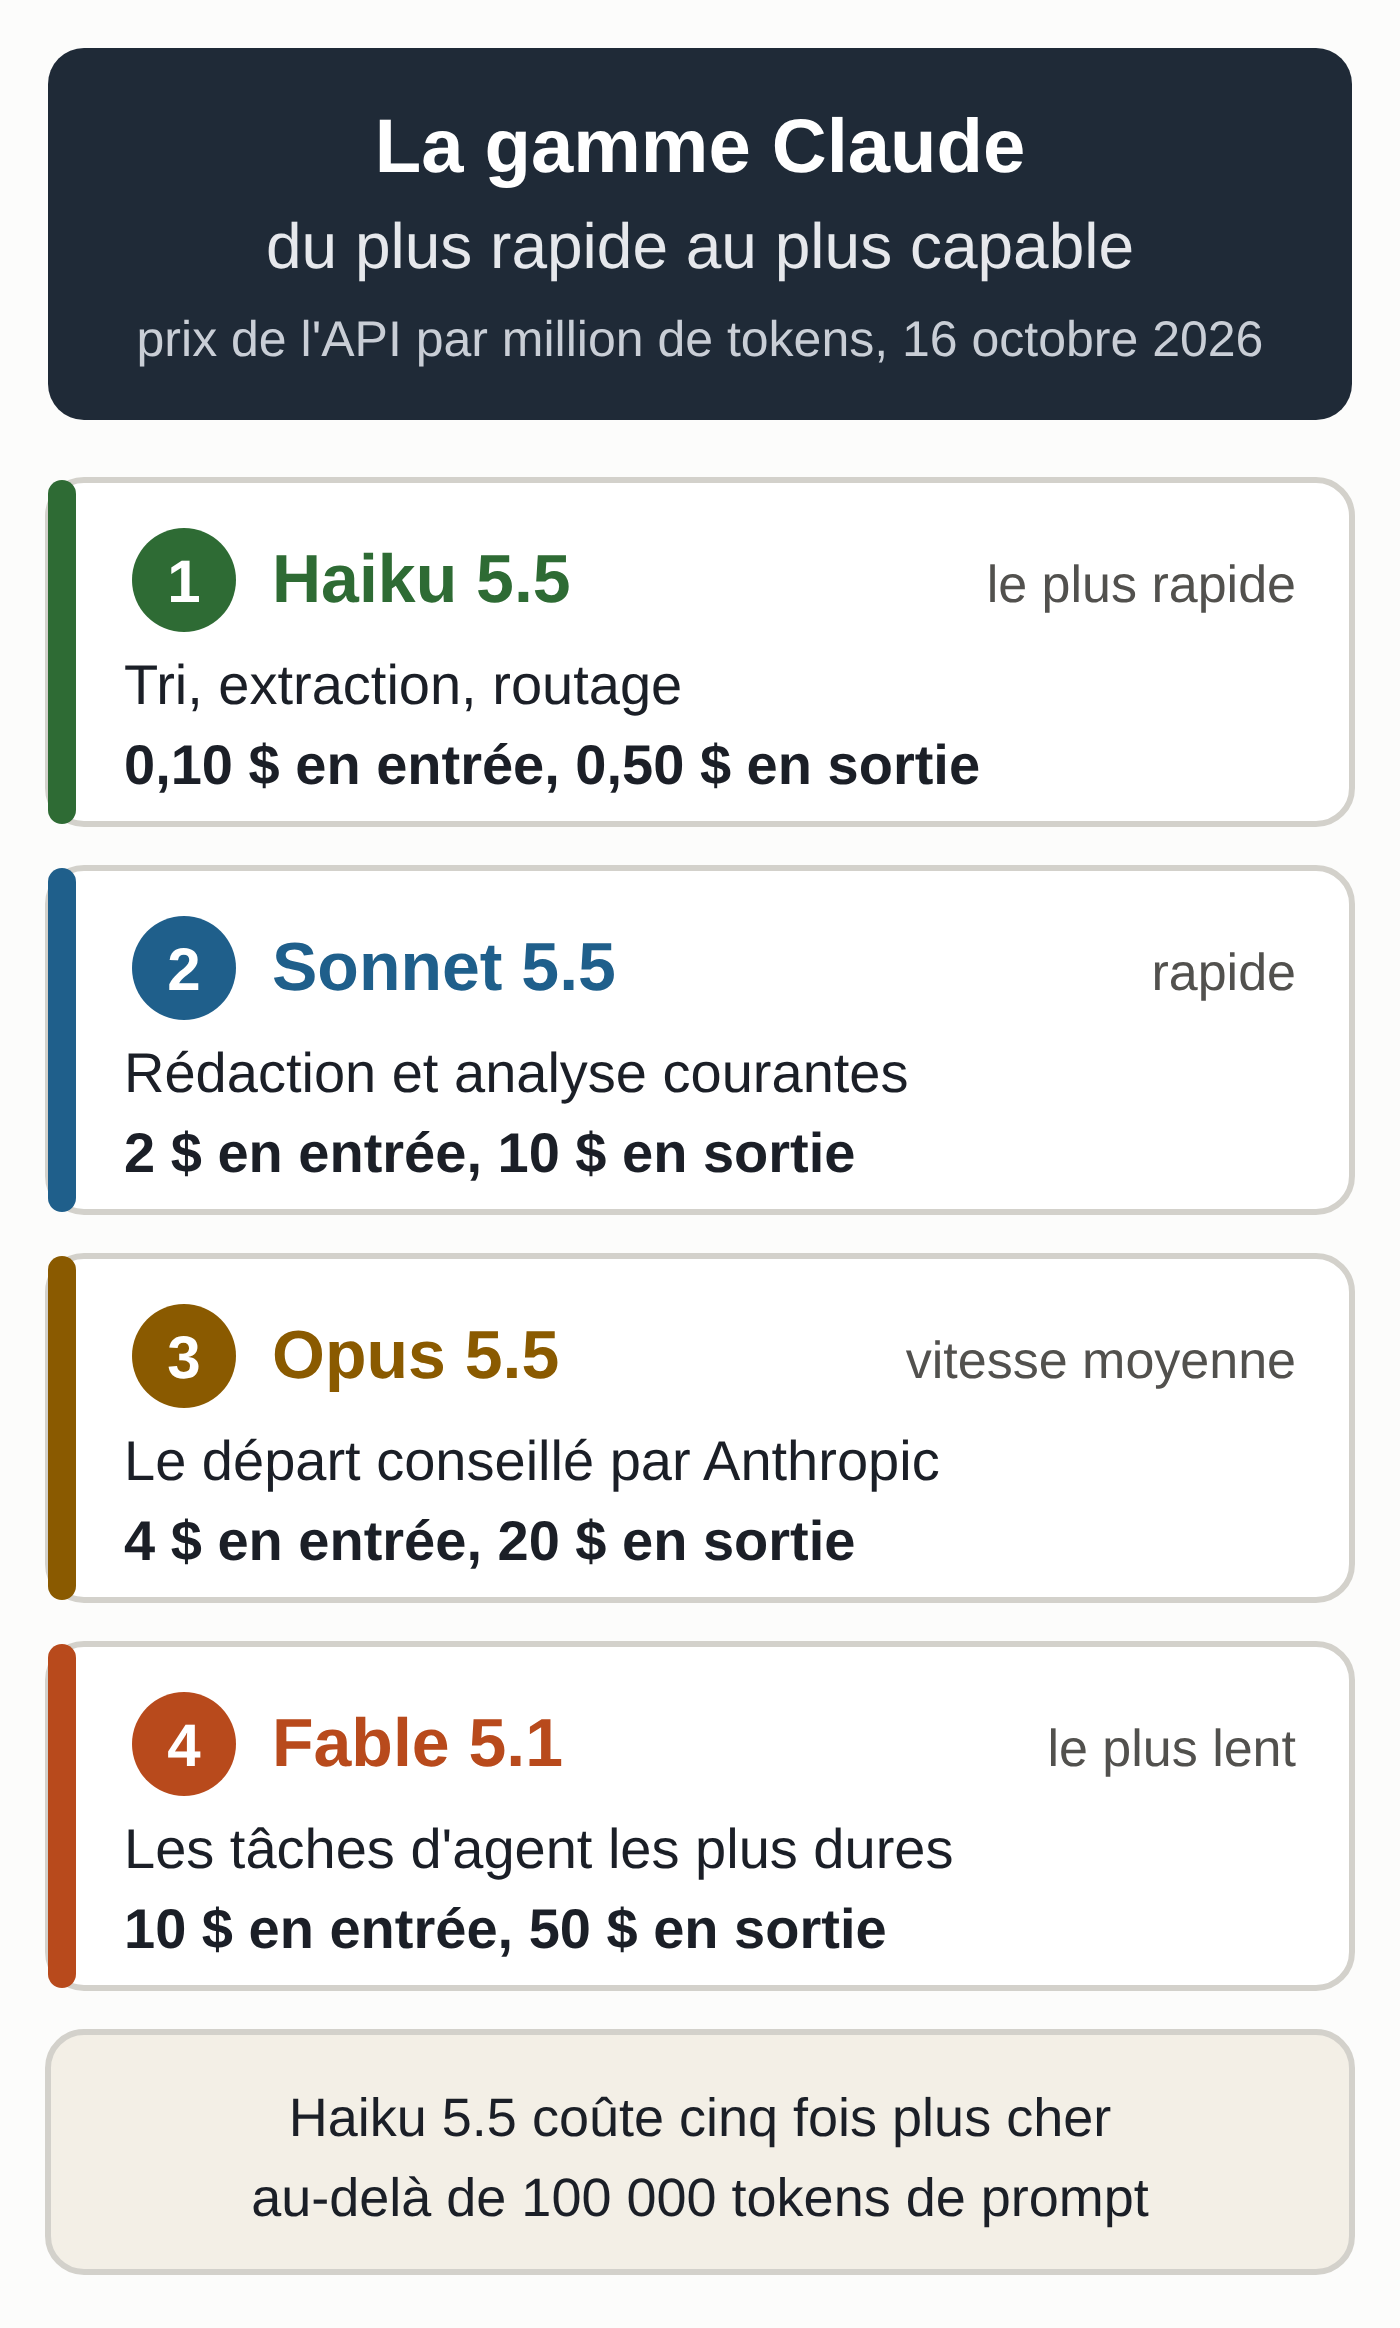
Au 16 octobre 2026, la gamme actuelle de Claude compte quatre modèles ouverts à tous les clients d’Anthropic : Haiku 5.5, Sonnet 5.5, Opus 5.5 et Fable 5.1. Par l’API, leurs prix vont de 0,10 dollar à 50 dollars par million de tokens, selon le modèle et selon qu’il s’agit du texte envoyé ou produit. Dans l’application Claude, l’accès dépend surtout de votre formule : la version gratuite donne Sonnet et Haiku, Opus demande un abonnement payant, Fable n’est inclus que dans certaines formules.
Pour la plupart des usages, Anthropic conseille de commencer par Opus 5.5 et de réserver Fable 5.1 au raisonnement exigeant, aux longues tâches d’agent ou aux cas où Opus ne suffit pas. Ce guide explique les noms, l’usage de chaque modèle dans une petite entreprise, le coût sur trois exemples chiffrés et la lecture d’un avis de retrait.
Un token est un fragment de mot : c’est l’unité dans laquelle l’API compte et facture le texte envoyé au modèle (l’entrée) et le texte qu’il produit (la sortie). D’après Anthropic, un million de tokens correspond à environ 2,5 millions de caractères avec le découpage actuel.
Quatre familles de modèles et un numéro de version
Le nom d’un modèle Claude se lit en deux parties. La famille donne sa place dans la gamme, de Haiku, le plus rapide et le moins cher, à Fable, le plus capable des modèles ouverts à tous, en passant par Sonnet et Opus.
Le numéro donne la version majeure puis la mineure : Opus 5.5 succède à Opus 5, Fable 5.1 prolonge Fable 5. Les familles n’avancent pas au même rythme. Fable 5.1 est sorti le 1er septembre 2026, Opus 5.5 le 22 septembre, Sonnet 5.5 le 28 septembre et Haiku 5.5 le 7 octobre. Les versions précédentes, de Haiku 4.5 à Fable 5, restent accessibles par l’API.
Pour un développeur, chaque modèle a un identifiant, par exemple claude-opus-5-5. Depuis la génération 4.6, ces identifiants ne portent plus de date et chacun désigne une version figée : Anthropic ne modifie ni les poids ni la configuration d’un identifiant existant, et une mise à jour sort sous un nouvel identifiant. Les modèles plus anciens portaient une date, comme claude-sonnet-4-5-20250929, avec un alias plus court qui pointait vers la dernière version datée.
Si les réponses changent sans raison apparente, Anthropic indique que l’infrastructure autour du modèle (routage des requêtes, filtres de sécurité) peut évoluer et modifier légèrement son comportement, à identifiant constant.
Le comparatif des modèles Claude au 16 octobre 2026
Le tableau reprend les quatre modèles actuels de la page des modèles d’Anthropic. Les prix sont ceux de sa page tarifs pour l’API, par million de tokens, en dollars hors taxes, avec l’équivalent en euros au cours de référence de la BCE du 15 octobre 2026 (1 € = 1,1208 $).
Vérifié le 16 octobre 2026 sur les fiches des modèles, la page tarifs et le comparatif des formules d'Anthropic.
| Modèle | Entrée, par million de tokens | Sortie, par million de tokens | Contexte et vitesse | Où l'utiliser |
|---|---|---|---|---|
| Claude Haiku 5.5Grand volume, réponse rapide : classement, extraction, routage | 0,10 $ (0,09 €)0,50 $ (0,45 €) au-delà de 100 000 tokens de prompt | 0,50 $ (0,45 €)2,50 $ (2,23 €) au-delà de 100 000 tokens de prompt | 1 million de tokensLe plus rapide | Application : toutes les formules, Free compris.API Claude, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS. |
| Claude Sonnet 5.5Le meilleur compromis entre vitesse et intelligence, selon Anthropic | 2 $ (1,78 €) | 10 $ (8,92 €) | 1 million de tokensRapide | Application : toutes les formules, Free compris.API Claude, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS. |
| Claude Opus 5.5Code et travail de bureau confiés à un agent sur de longues durées | 4 $ (3,57 €) | 20 $ (17,84 €) | 1 million de tokensVitesse moyenne | Application : Pro, Max, Team, Enterprise.API Claude, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS. |
| Claude Fable 5.1Raisonnement exigeant et tâches d'agent de longue haleine | 10 $ (8,92 €) | 50 $ (44,61 €) | 1 million de tokensLe plus lent | Application : Max et sièges Team Premium jusqu'à 50 % de la limite hebdomadaire, Enterprise ; Pro et sièges Team Standard avec les crédits d'utilisation.API Claude, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS. |
Prix de l'API d'Anthropic hors taxes, en dollars, avec l'équivalent en euros au cours BCE du 15 octobre 2026 (1 € = 1,1208 $). Prompt : tout le texte envoyé dans une requête. Lecture du cache, par million de tokens : 0,01 $ sur Haiku 5.5 (jusqu'à 100 000 tokens de prompt), 0,10 $ sur Sonnet 5.5, 0,20 $ sur Opus 5.5, 0,25 $ sur Fable 5.1. L'API par lots divise les prix par deux. Méthode : chaque ligne vient de la fiche du modèle chez Anthropic, de sa page tarifs et de son comparatif des formules ; nous revérifions le tableau à chaque sortie ou retrait de modèle annoncé par Anthropic, et la date ci-dessus change avec lui.
Les quatre modèles produisent jusqu’à 128 000 tokens par réponse et lisent du texte et des images. Leurs connaissances fiables s’arrêtent à juin 2026, d’après Anthropic. Pour la concurrence, nous avons comparé Claude à Gemini 4 Argon, le dernier modèle de Google, et à Muse Wonder, le modèle que Meta oppose à Opus 5.5.
Haiku, Sonnet, Opus et Fable, modèle par modèle
Claude Haiku 5.5 pour le tri et l’extraction en volume
Haiku 5.5 vise les tâches répétitives où la vitesse et le coût comptent plus que la profondeur. Anthropic cite le classement, l’extraction, le routage de demandes et le travail de sous-agent, quand un petit modèle exécute une étape pour un plus gros. Dans une petite entreprise : trier les e-mails entrants, relever les montants d’une facture, classer les demandes d’un formulaire. Son effort est réglé sur « medium » par défaut.
Son prix dépend de la longueur de la requête. Jusqu’à 100 000 tokens de prompt (tout le texte envoyé dans une requête), il coûte 0,10 $ en entrée et 0,50 $ en sortie par million de tokens. Au-delà, chaque requête paie cinq fois plus, même si une partie du texte vient du cache.
Il compte aussi environ 30 % de tokens de plus que Haiku 4.5 pour un même texte. Notre article sur la baisse de prix de Claude Haiku 5.5 fait le calcul sur 1 000 e-mails.
Claude Sonnet 5.5 pour le travail de tous les jours
Anthropic décrit Sonnet 5.5 comme le modèle qui combine le mieux vitesse et intelligence. Ses exemples d’usage parlent à une petite entreprise : rédaction de contenus, analyse de données, compréhension d’images, génération de code et utilisation d’outils par un agent. Il réfléchit avant de répondre quand la tâche le demande, avec un effort réglé sur « high » par défaut.
À 2 $ en entrée et 10 $ en sortie par million de tokens, il coûte deux fois moins qu’Opus 5.5, et l’application le propose dès la formule gratuite. Pour le courrier, les comptes rendus ou un tableau à analyser, c’est le modèle par lequel commencer.
Claude Opus 5.5, le point de départ conseillé par Anthropic
Opus 5.5 est conçu pour le code et le travail de bureau confiés à un agent sur de longues durées. Les exemples d’Anthropic : un agent qui code seul pendant plusieurs heures, la refonte d’un gros programme, des tâches qui demandent de lire beaucoup d’images ou de piloter un ordinateur. Sa réflexion est toujours active et ne peut pas être coupée : l’effort est le réglage principal, sur « medium » par défaut.
Opus 5.5 coûte 4 $ en entrée et 20 $ en sortie par million de tokens, contre 5 $ et 25 $ pour Opus 5. Par l’API d’Anthropic, un mode rapide, qui produit le texte jusqu’à 2,5 fois plus vite, est facturé le double : 8 $ et 40 $. Dans l’application, Opus demande une formule payante.
Claude Fable 5.1 quand Opus ne suffit plus
Fable 5.1 est le modèle le plus capable qu’Anthropic ouvre à tous ses clients. Ses exemples d’usage : des sessions d’agent qui durent des heures, une recherche approfondie en plusieurs étapes, une analyse menée jusqu’au document, au tableur ou à la présentation finis. Il est aussi le plus lent de la gamme et coûte 2,5 fois le prix d’Opus 5.5, soit 10 $ en entrée et 50 $ en sortie par million de tokens.
Anthropic conseille Fable 5.1 pour le raisonnement exigeant et les tâches d’agent de longue haleine, ou quand Opus 5.5, réglé à un effort élevé, échoue encore sur vos propres tests. Dans l’application, Fable est inclus dans Max jusqu’à la moitié de la limite hebdomadaire. Sur Pro, il passe par les crédits d’utilisation, payés en plus de l’abonnement au tarif de l’API.
Claude Mythos 5.1, réservé aux organisations vérifiées
Mythos 5.1 offre les mêmes capacités que Fable 5.1, au même prix. Anthropic le réserve aux organisations vérifiées par l’un de ses programmes, comme le Cyber Verification Program destiné aux professionnels de la sécurité informatique. Une petite entreprise hors de ce domaine peut l’ignorer.
Combien coûte un mois d’usage par l’API ?
Par l’API, vous payez les tokens envoyés et produits. La réflexion du modèle est facturée comme du texte produit, même quand elle n’apparaît pas dans la réponse. Les trois profils ci-dessous reposent sur des hypothèses simples ; vos chiffres dépendront de vos textes et de l’effort choisi.
Premier profil, le tri de 2 000 e-mails par mois avec Haiku 5.5, à 2 000 tokens envoyés (consignes comprises) et 300 tokens produits (réflexion comprise) par e-mail. Entrée : 4 millions de tokens à 0,10 $, soit 0,40 $. Sortie : 0,6 million à 0,50 $, soit 0,30 $. Total : 0,70 $ par mois, environ 0,62 €, ou la moitié avec l’API par lots si le tri peut attendre.
Deuxième profil, la rédaction de 100 devis ou comptes rendus par mois avec Sonnet 5.5, à 8 000 tokens envoyés (consignes, notes, modèle à suivre) et 3 000 tokens produits par document. Entrée : 0,8 million à 2 $, soit 1,60 $. Sortie : 0,3 million à 10 $, soit 3 $. Total : 4,60 $ par mois, environ 4,10 €.
Troisième profil, l’analyse d’un gros dossier avec Opus 5.5, vingt fois par mois : 150 000 tokens envoyés (environ 375 000 caractères) et un rapport de 20 000 tokens, réflexion comprise. Entrée : 3 millions à 4 $, soit 12 $. Sortie : 0,4 million à 20 $, soit 8 $. Total : 20 $ par mois, environ 17,84 €.
Le même dossier coûte 10 $ sur Sonnet 5.5 et 50 $ sur Fable 5.1. Sur Haiku 5.5, il revient à 2,50 $, mais chaque requête dépasse le seuil de 100 000 tokens et paie le tarif haut. Pour plusieurs questions sur le même dossier, le cache change le calcul : sur Opus 5.5, relire le dossier depuis le cache coûte 0,20 $ par million de tokens au lieu de 4 $, après une mise en cache facturée 5 $ par million pour cinq minutes, ou 8 $ pour une heure.
Pour comparer, la formule Pro coûte 20 $ par mois en paiement mensuel. Les deux premiers profils coûtent moins de 5 $ par mois : pour ce type d’automatisation, le temps passé à la mettre en place et à la surveiller pèse plus lourd que les tokens.
Les formules de l’application et les modèles qu’elles ouvrent
Dans Claude sur le web, l’ordinateur et le mobile, vous payez une formule, avec des limites d’usage. La page tarifs des formules Claude affiche ces prix en dollars, hors taxes :
- Free, gratuit : Sonnet et Haiku, sans Opus ni Fable, et jusqu’à cinq projets.
- Pro, 20 $ par mois, ou 17 $ par mois en annuel (200 $ payés d’avance) : Opus en plus, et Fable avec les crédits d’utilisation.
- Max, 100 $ par mois pour 5 fois l’usage de Pro, ou 200 $ pour 20 fois : Opus, et Fable jusqu’à 50 % de la limite hebdomadaire. Facturation mensuelle seulement.
- Team, de 2 à 150 personnes : siège Standard à 25 $ par mois (20 $ en annuel), siège Premium à 125 $ (100 $ en annuel). Opus sur tous les sièges, Fable jusqu’à 50 % de la limite hebdomadaire sur les sièges Premium et avec les crédits d’utilisation sur les sièges Standard.
- Enterprise : 20 $ par siège et par mois, à l’année, 20 sièges minimum, plus l’usage facturé au tarif de l’API. Fable compris.
Pour un compte belge, claude.ai affichait le 28 septembre 2026 Pro à 18 € et Max à 90 € ou 180 € par mois, hors taxes : notre guide Pro, Max ou Team, quelle formule choisir détaille ces prix, la TVA et un test d’une semaine pour trancher. Les projets, qui regroupent vos documents et vos consignes, changent de forme : Anthropic a commencé à migrer ceux de certains abonnés Pro et Max vers une nouvelle version, comme l’explique notre article sur les Projets Claude.
Max et Team donnent aussi un crédit mensuel pour l’API : 100 $ sur Max 5x, 200 $ sur Max 20x, et sur Team 20 $ par siège Standard et 100 $ par siège Premium, mis en commun et plafonnés à 500 $ par mois. Ce crédit ne se reporte pas d’un mois sur l’autre et ne couvre pas Claude Code en usage interactif. Pro et Enterprise n’y ont pas droit. Pour une jeune entreprise, il compte d’autant plus que le programme Claude for Startups a refusé toutes les candidatures en attente le 13 octobre 2026.
Côté données, l’entraînement des modèles sur vos conversations dépend d’un réglage que vous pouvez couper sur Free, Pro et Max, et n’a pas lieu par défaut sur Team et Enterprise. Le détail figure dans notre tableau des réglages de confidentialité, outil par outil.
Les limites d’usage en termes simples
Chaque formule a une limite par session, remise à zéro sur une fenêtre glissante de cinq heures. Les formules payantes y ajoutent une limite hebdomadaire. Le web, l’application de bureau, le mobile et Claude Code puisent dans la même réserve.
Il n’y a pas de nombre de messages fixe : la consommation dépend de la longueur des conversations, du modèle et des fonctions utilisées. Par session de cinq heures, Pro offre au moins 5 fois l’usage de Free, Max 5 ou 20 fois celui de Pro, et un siège Team Premium 5 fois celui d’un siège Standard, qui dépasse déjà Pro. Le modèle fait partie du calcul : sur Max, Fable ne peut pas consommer plus de la moitié de la limite hebdomadaire.
Une fois la limite atteinte, vous pouvez attendre la remise à zéro, passer à la formule supérieure ou, sur une formule payante, activer les crédits d’utilisation, facturés au tarif de l’API. Paramètres > Utilisation indique où vous en êtes. Si vous atteignez souvent le plafond, nos sept réglages pour tenir le mois avec Claude Pro aident à faire durer le quota.
L’effort, un réglage aussi important que le choix du modèle
Par l’API, les quatre modèles actuels acceptent un réglage d’effort à cinq niveaux : low, medium, high, xhigh et max. L’effort porte sur tous les tokens produits, réflexion, texte et appels d’outils compris : plus il est haut, plus le modèle approfondit et plus la réponse coûte. D’après Anthropic, régler l’effort est souvent plus efficace que changer de modèle.
Les réglages par défaut diffèrent : « high » sur Fable 5.1 et Sonnet 5.5, « medium » sur Opus 5.5 et Haiku 5.5. Une requête qui ne précise rien tourne donc un cran plus bas sur Opus 5.5 que sur Opus 5. Anthropic destine « low » aux tâches simples et aux sous-agents, et « xhigh » aux tâches d’agent ou de code qui durent plus de 30 minutes. Sur Opus 5.5 et Fable 5.1, la réflexion ne se coupe pas ; sur Sonnet 5.5 et Haiku 5.5, elle peut être réduite.
Avant de changer de modèle, testez la même tâche à deux niveaux d’effort et gardez le plus bas qui donne un résultat juste. Pour répartir le travail entre plusieurs modèles, par exemple un petit qui exécute et un gros qui tranche les cas difficiles, voyez notre guide pour choisir son modèle IA et organiser un travail avec plusieurs agents.
Lire un avis de retrait de modèle
La page des dépréciations d’Anthropic utilise quatre statuts. Un modèle actif est pris en charge et recommandé ; un modèle « legacy » ne reçoit plus de mises à jour et peut être déprécié plus tard. Un modèle déprécié fonctionne encore, avec un remplaçant et une date de retrait fixés. Un modèle retiré ne répond plus.
Pour ses modèles publics, Anthropic s’engage à prévenir au moins 60 jours avant le retrait, par e-mail aux clients qui l’utilisent et dans sa documentation. Exemple en cours : le 30 septembre 2026, l’éditeur a annoncé le retrait de Claude Sonnet 4.5 pour le 30 novembre 2026, avec Sonnet 5.5 comme remplaçant. Une automatisation qui appelle encore claude-sonnet-4-5-20250929 cessera de fonctionner à cette date.
Pour les modèles actuels, la page donne une date plancher : Opus 5.5 ne sera pas retiré avant le 22 septembre 2027, Haiku 5.5 pas avant le 7 octobre 2027. La date plancher de Haiku 4.5, « pas avant le 15 octobre 2026 », est passée sans avis de retrait, et le modèle reste actif. S’il est déprécié, le préavis d’au moins 60 jours s’appliquera. Dans les applications Claude, Haiku 4.5 quitte le sélecteur des formules Gratuit, Pro et Max le 29 octobre 2026 (voir notre article sur le retrait de Claude Haiku 4.5 du sélecteur).
Quand un avis arrive, repérez les outils concernés (la page Usage de la Console d’Anthropic exporte la consommation par clé d’API et par modèle), testez le remplaçant sur vos vraies données, puis changez l’identifiant avant la date. Ces dates valent pour les plateformes d’Anthropic ; Amazon Bedrock et Google Cloud fixent leur propre calendrier.
Le bon modèle selon votre situation
Vous écrivez, résumez et répondez dans l’application
Commencez par Sonnet 5.5, disponible dès la formule gratuite. Passez à Opus 5.5, avec une formule payante, pour un long document à analyser ou un raisonnement en plusieurs étapes. Si vous hésitez encore entre deux assistants, notre comparatif Claude ou ChatGPT sur cinq tâches de bureau tranche sur des cas concrets.
Vous automatisez une tâche répétitive
Prenez Haiku 5.5 par l’API, à l’effort « low » pour commencer, l’approche qu’Anthropic recommande pour les tâches simples en grand volume. Vérifiez à la main une cinquantaine de résultats avant de laisser tourner, puis remontez l’effort ou passez à Sonnet 5.5 si les erreurs dépassent ce que vous acceptez.
Vous confiez un long travail à un agent
Partez d’Opus 5.5, avec un effort « high » ou « xhigh » si la tâche dure. Passez à Fable 5.1 seulement si Opus échoue encore sur vos propres tests, en sachant qu’il coûte 2,5 fois plus cher et répond plus lentement. Les risques d’un agent laissé sans cadre sont décrits dans notre article sur le rapport d’Anthropic consacré aux agents IA.
Vous travaillez sur de très longs documents
Les quatre modèles lisent jusqu’à un million de tokens d’un coup. Sur Fable 5.1, Opus 5.5 et Sonnet 5.5, une requête de 900 000 tokens paie le même prix par token qu’une requête de 9 000 tokens. Sur Haiku 5.5, au-delà de 100 000 tokens de prompt, le tarif est multiplié par cinq. Pour un dossier relu souvent, le cache réduit fortement la note.
Trois choix pour votre administratif
Dans la plupart des petites entreprises, trois choix couvrent l’essentiel : Sonnet 5.5 dans l’application pour le travail courant, Opus 5.5 pour les dossiers longs, Haiku 5.5 par l’API pour les tâches répétitives. Revoyez-les à chaque nouvelle version : les quatre familles ont changé de version entre le 1er septembre et le 7 octobre 2026. Pour une première tâche concrète, le guide de l’IA par métier part de votre activité.
Avant de payer une formule ou l’API au nom de votre entreprise, lisez les conditions d’utilisation d’Anthropic qui s’appliquent à votre cas.
Si vous préférez déléguer votre administratif sans comparer les modèles vous-même, découvrez notre assistant IA.